GeniWorld:先把机器人动作渲染成空间条件
URDF运动与场景动力学分离,用于交互模拟和训练数据合成
GeniWorld 不直接把关节数字交给视频模型,而是先用机器人URDF和相机标定渲染运动,再预测环境响应。作者用固定场景训练、随机场景测试,并把合成轨迹用于真实策略;这种空间约束有价值,但并不等于获得精确物理模拟器。
图解主要方法
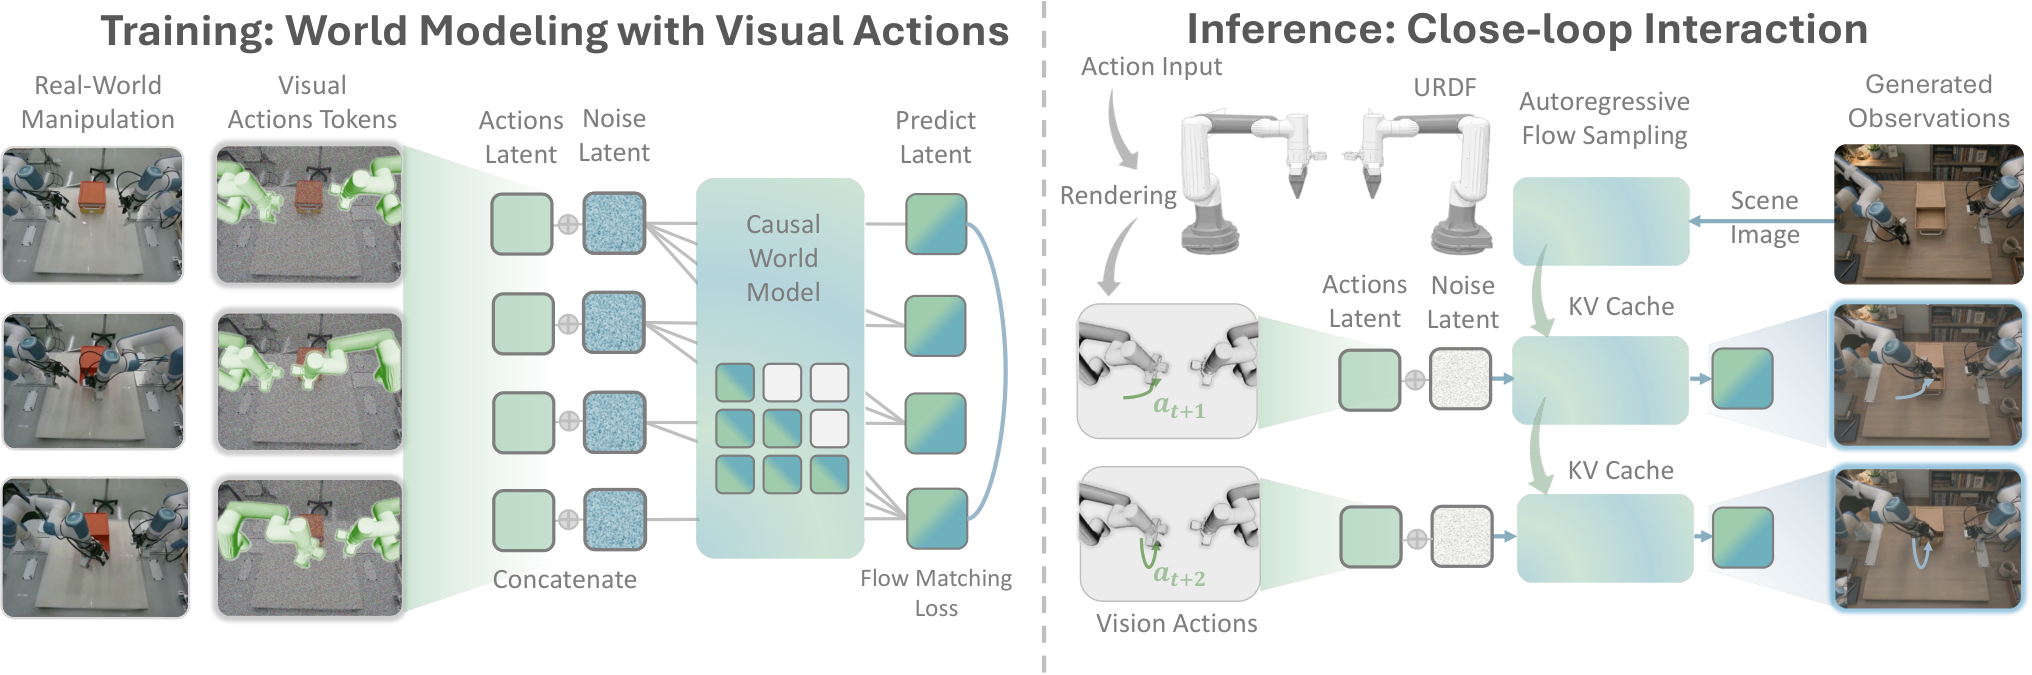
图 2 怎样把动作变成视频模型能利用的空间引导?
- 1
渲染机器人运动而非整个环境
图左由数值动作、前向运动学、URDF和标定相机得到机器人专属运动序列,排除背景与被操作物体。它给出机构运动位置,物体接触后的变化仍由世界模型学习;准确URDF与标定是前提。
- 2
在潜空间拼接动作与场景
同一因果VAE分别编码动作渲染和场景视频,各48通道,拼成96通道输入Wan2.2-5B。训练只给场景latent加噪,动作条件保持干净,以flow matching预测未来观察;这利用了视频骨干的空间先验。
- 3
用因果块和缓存组成闭环
图右以初始真实或编辑图为起点,按动作生成下一段观察,再反馈给策略或遥操作员。块内允许完整注意力,历史KV缓存供后续使用;训练从真实历史逐步转向生成历史以降低暴露偏差。
- 4
分开评测与数据合成用途
策略评测把同一初始观察送入现实和模拟;数据合成则可编辑初图,重放已有动作或由人重新遥操作。新轨迹需要操作者和图像编辑成本,不能称为无需标注、无需人工的免费数据。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【跨场景视频】RoboTwin50任务共2250训练轨迹;clean测试250条,random另250条且不适配。随机场景LPIPS0.144、FVD20.15。 表 I、附录 B ↗
我的解读我的解读:同分割支持视觉动作的效果;附录FVD采用Inception特征的时间均值/标准差拼接,并非通用I3D协议,不应跨论文直接比较数字。
来源证据【真实策略】四任务、五设置、每格20次,即每配置400次;每任务25真实示范加65空间和65多样合成,总体成功40.8%→69.0%。 图 9 与附录 C表 III ↗
我的解读我的解读:数据多样性确有实际价值,但未匹配等量真实数据或相同人力预算;灯光变化仍仅52.5%,不是所有OOD已解决。
来源证据【交互和评价】五步采样H20上约8Hz;策略模拟分数与真实表现正相关,论文主要以图展示。 第 IV-C/IV-D 节 ↗
我的解读我的解读:接口生成频率不是机器人低层控制频率;缺少充分置信区间和更广策略集合,相关性不能保证新策略排序可靠。
开放情况与使用许可
08-06 首发,今日按回顾补收;已打开作者项目并读正文附录。页面提供论文与演示,本次未核实专属实现、数据或权重实际开放。
LICENSE论文及图 2 为 CC BY 4.0;模型与数据发布许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
显式运动图把机器人几何约束接入生成模型,降低数值动作与视觉空间对齐的负担,并用真实策略测试合成数据价值。
反方 · 哪些结论还不够
依赖本体模型和相机标定,接触与物体动力学仍是生成近似;合成数据增益混有数量、多样性与人工采集差异。
综合判断
适合研究机器人专用交互模拟和定向数据增广;应保留真实验证集,不把生成成功视频直接当物理可行真值。
我会先做的验证
未执行的验证方案:对相同起点与动作做真实/模型成对测试,分接触、滑移、遮挡和标定误差测状态偏差;再以等预算真实增广、图像增广和世界模型新轨迹比较策略OOD成功与人工成本。