GenSfM:把相机与三维形状放进同一个生成过程
未标定多视图如何联合恢复几何、位姿与表面外观
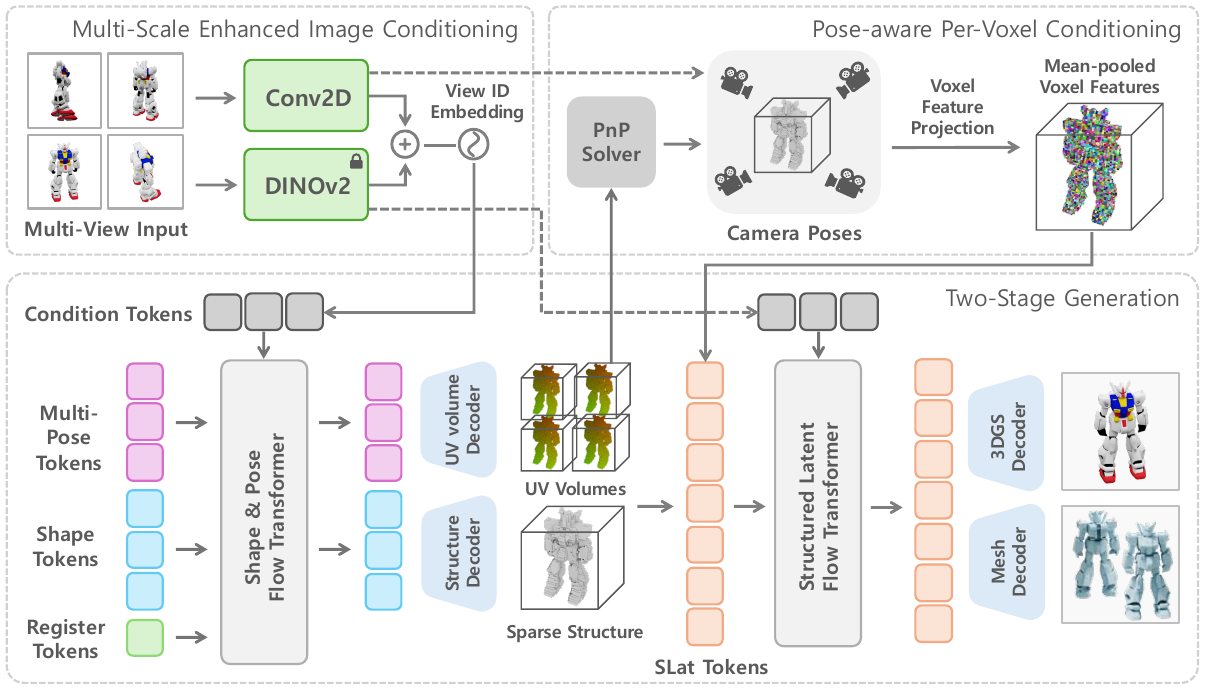
GenSfM从四张未标定对象图像联合生成稀疏形状与相机,再用投影对齐的视觉特征细化三维资产。相机与形状不再完全串联,但论文中的UV投影是像素坐标场,不是资产网格UV展开。
图解主要方法
未标定多视图如何联合恢复几何、位姿与表面外观
- 1
把相机变成三维原生投影体
每个体素存储其投影到图像的二维坐标,以Pose VAE压缩为4³个token。它与64³占据形状的稀疏结构一起进入粗生成阶段,视图身份token绑定图像,降低相机向量与几何表示不匹配。
- 2
联合流匹配形状与相机
共享自注意力、图像交叉注意力同时去噪形状和各视角投影体,各流具有自己的时间条件。恢复投影对应后通过DLT求投影矩阵,再做RQ分解得到内外参;几何与相机在这一阶段互为条件。
- 3
用恢复相机细化局部表面
按估计位姿投影体素,采样DINO与CNN特征并聚合多视图,条件化细粒度SLat生成。沿用TRELLIS解码器输出纹理网格等表示;训练细化阶段用真值相机、测试用预测相机,仍存在条件误差迁移。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据约43万对象训练,粗阶段8张H200、细阶段4张H200各100万步;Toys4k和GSO各400对象、两组不重叠四视图。 训练与评测范围 ↗
我的解读是对象中心四视图任务,不是任意场景SfM;计算成本与数据规模不可忽略。
来源证据Toys4k PSNR28.54对TRELLIS-M24.01,GSO25.50对22.28;Toys4k中位平方Chamfer×10⁻³为0.1133对0.4329。 ICP对齐的生成器比较 ↗
我的解读该表经过ICP,不能与另表点图最小二乘或原始位姿指标混用;对齐后高质量不等于绝对位姿已正确。
来源证据预测内参条件Acc@5为0.9723/0.9821,但评测统一消除了前后方向符号歧义。 相机及资产边界 ↗
我的解读高相机分数不检验方向手性;没有完整UV接缝、去光照、PBR分通道或重光照实验,不能以渲染PSNR代替资产验收。
开放情况与使用许可
已访问作者项目页;未发现可验证的完整实现、权重及独立模型卡,不将论文或展示页称为模型开源。
LICENSE论文与原图:CC BY 4.0;不代表代码或权重许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把相机不确定性纳入生成,可缓解先估位姿失败再传递到重建的串联问题。
反方 · 哪些结论还不够
对象中心、固定少量视图,对称性和方向歧义仍在;细化训练依赖真值相机。纹理视觉质量并未覆盖可编辑资产的全部要求。
综合判断
联合形状与相机值得跟进;资产流程还需独立验证坐标、拓扑与材质可用性。
我会先做的验证
未执行的验证方案:加入非对称标记,关闭前后翻转容错检测相机手性;导出网格检查尺度、法线、UV接缝、PBR通道和换光照效果,并比较预测/真值相机细化差距。