GeoState:把相机运动从世界状态中分开
压缩的几何状态能否预测未来,再从指定视角读出深度?
GeoState 将多视角几何特征压缩为场景状态,单独预测其时间演化与相机运动,再用查询相机解码未来深度。核心是减少“观察位置改变”对世界状态的扰动,而不是直接生成RGB视频。
图解主要方法
压缩的几何状态能否预测未来,再从指定视角读出深度?
- 1
1 · 压缩多视角几何
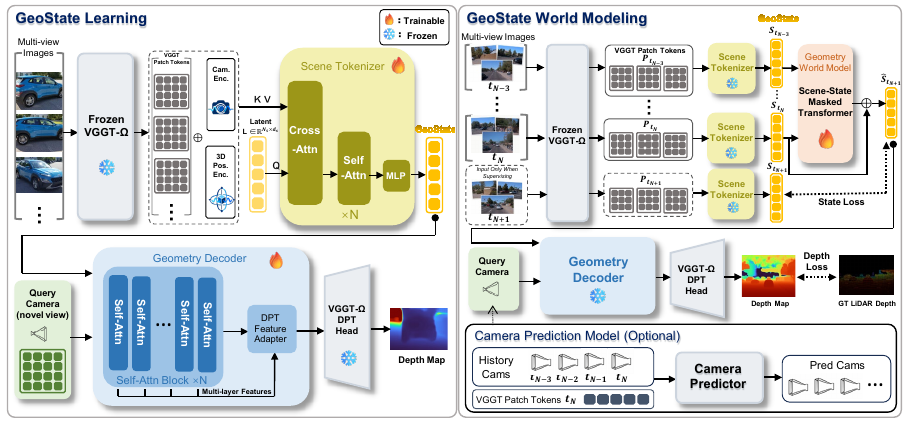
图1左侧以冻结VGGT-Ω的第4、11、17、23层特征及点置信度、源位姿和射线为输入,经8层Perceiver聚合成512个512维token。查询相机只在后续解码引入;这有助于解耦,但不证明状态对所有输入视角完全不变。
- 2
2 · 在状态空间预测动态
四个观测时刻组成上下文,12层时空因子化Transformer以残差预测未来状态,零初始化输出头从Copy-Last起步。训练含单步状态/深度监督,再进行7步深度滚动监督;独立约8.99M参数相机预测器在常速度SE(3)运动上学习视觉修正。
- 3
3 · 用查询相机读出未来
场景token先自注意力,再与查询射线交互,经DPT适配与冻结头输出深度。同一个未来状态可以查询多个相机,无需重新编码;实际预测相机与使用真值相机是不同实验条件。
- 4
4 · 固定尺度,避免未来对齐泄漏
评测以最后观测FRONT图像的LiDAR深度确定尺度,要求足够有效匹配;该尺度沿未来滚动保持不变。因此量纲评价依赖观测期LiDAR及标定,不是无标定纯RGB即可得到真实尺度。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据三相机、四观测时刻输入;2秒预测相机AbsRel为0.127,VGGT-World为0.213;匹配同一相机的Copy-Last为0.132。 Waymo主实验,100个留出片段 ↗
我的解读对旧方法优势不能全部归因于动态预测,状态更新相比保持最后状态的净改善较小。FR3D部分数字引用其论文,非统一重跑。
来源证据预测相机动态区域平均AbsRel从Copy-Last 0.1070降到0.0967,静态区域0.0915到0.0895;零样本KITTI 2秒0.155对0.160。 动态区域与跨域 ↗
我的解读收益更集中在动态区域,但跨域结果仍要与强静态基线比较,而不是只报绝对深度误差。
来源证据100场景、10未来时刻与600查询相机组成60万对比较,分小中大位姿扰动,并选择高重叠样本。 跨视角查询诊断 ↗
我的解读说明可见重叠区域的解码自洽;不覆盖遮挡后无真值的新空间,也不是物理交互准确性的证明。
开放情况与使用许可
官方仓库包含模型、训练、评测实现,已核对MIT LICENSE;README给出三个检查点的Hugging Face路径,但本次未完成权重下载验收。冻结VGGT-Ω、训练数据和模型权重须分别遵循各自条款。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将几何状态与观察相机分开,是从视频特征走向可查询世界表示的重要设计;匹配Copy-Last消融尤其有助于辨认动态模型究竟贡献多少。
反方 · 哪些结论还不够
依赖几何基础模型、标定相机与观测尺度;跨视角检查偏向高重叠区域。输入上下文改变仍可能扰动特征。没有动作条件交互、接触预测、PBR材质或资产输出。
综合判断
已有证据支持驾驶场景中的短期深度预测和跨视角查询;尚不能外推为一般物理模拟器或闭环机器人规划模型。
我会先做的验证
未执行的验证方案:固定输入相机数、尺度来源和查询轨迹,对Copy-Last、常速度几何与学习动态逐项比较;按遮挡、新出现物体和相机转弯分组,增加预测相机误差对深度的敏感度曲线。