GeoWM:直接询问未来几何,绕开逐帧滚动的误差积累
深度历史、相机运动与投影锚点共同预测指定时刻;并非动作条件模拟器
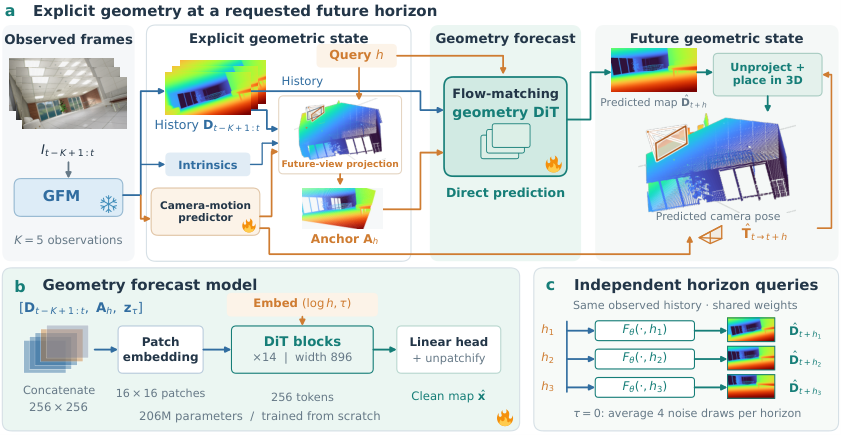
GeoWM先把最近五帧转为深度和相机轨迹,再将最后一帧几何投到预测视角,作为流匹配Transformer的条件。各未来时域直接查询,共享历史而不递归生成中间帧。四类数据上的深度预测较强,但独立预测未保证跨时刻一致性,且没有控制动作输入。
图解主要方法
不生成中间画面,能否直接预测指定时刻的三维几何?
- 1
从五帧RGB建立几何历史
冻结的VGGT恢复各帧深度、相机内参与位姿。最近相对运动送入轻量旋转回归与平移回归器,一次预测预设未来相机位姿;几何骨干的任意尺度需要训练和评测中的相应对齐。
- 2
投影到未来视角,提供静态结构锚点
将最后一帧深度反投影,再用预测相机位姿投影到未来视角,用最近深度的z-buffer处理遮挡。锚点不是最终答案:动态物体、显露区域和错误位姿仍需预测器修正。固定相机的DOMINO实验省略该锚点。
- 3
以深度而非视觉latent学习流匹配
深度历史、锚点和加噪目标按通道拼接,256×256输入形成256个patch token;14层、宽896的206M Transformer接收流时间及未来时域对数嵌入,预测干净深度。有效像素的逆深度加权L1流速度损失强调近处结构,TartanAir例外使用无该权重的损失。
- 4
独立查询每个时域,平均四次噪声预测
训练中40%样本使用流时间零点,推理也在该点直接读出干净深度,不积分ODE。每个时域做四个噪声样本预测后取平均,再与预测位姿恢复未来点云。因此一次时域查询包含四次预测,并非一次前向;不同查询没有共同轨迹一致性约束。
实验与证据
完整阅读公开正文、实验、消融和参考文献,核对图2、arXiv首发与许可;公开HTML未附额外附录。未独立运行作者实验。
来源证据每数据集训练100k步,batch16,AdamW学习率10⁻⁴,EMA0.999;VGGT冻结。文中称单GPU数小时,未明确GPU型号。 第4节实现细节 ↗
我的解读训练规模和预测器参数可复核,但不能把未披露硬件下的时间当作普适成本或个人设备性能保证。
来源证据KITTI验证3257个窗口、20时域;Cityscapes500窗口、5时域;TartanAir7314窗口、20时域;DOMINO四个拆分合计37360窗口、157325预测对。所有评测时域训练中已见。 第4节数据协议 ↗
我的解读覆盖驾驶、飞行与操控是任务多样性证据;各数据集分别训练,不是单个统一模型的零样本跨领域迁移。
来源证据前三数据集深度逐图中值对齐,DOMINO采用真实尺度;点云CD相似对齐,位姿ATE/RTE/RRE用Umeyama对齐。 表1注释及评测协议 ↗
我的解读对齐后几何形状更准与绝对距离可用于避障是不同命题。文中点云单位为米,也不能忽略评测时的相似变换。
来源证据KITTI全时域CD为1.027米,对照Cosmos-3为1.060;DOMINO为0.036对0.059。KITTI中时域δ1为83.1%,Cosmos-3为83.5%。 表1 ↗
我的解读收益依数据、指标而变;深度相对误差改善不必然意味着各几何指标同步大幅改善,不宜仅选最大的相对收益。
来源证据移除深度历史后KITTI AbsRel为28.6;用未做运动补偿的锚点为15.1,完整为14.2。历史长度2/3/4/5分别15.4/14.5/14.4/14.2。 消融实验 ↗
我的解读消融支持历史几何及运动补偿有贡献,但增加历史的边际改善快速下降,不支持无限增加上下文必然更好。
来源证据报告单时域查询GeoWM约0.11秒,在h=1/5/10/20保持不变;DINO-Foresight分别0.03/0.11/0.22/0.42秒。 效率比较表 ↗
我的解读直接查询的长时域成本优势合理,但最近时域DINO更快。查询20个不同未来时刻仍需各自计算;骨干成本是否纳入与计时硬件披露不足,不能写成完整20帧只需0.11秒。
开放情况与使用许可
2026-10-11核对论文链接和精确名称检索,未确认本研究官方代码、权重或模型卡。VGGT等基础模型的公开状态不能转化为GeoWM已开源。
LICENSE论文及图2为CC BY 4.0;GeoWM专属代码和权重许可尚未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
KITTI全时域AbsRel为14.2(表中×100),Cosmos-3为16.6、VGGT-World为22.5;长时域为17.4对21.2。
控制表征的消融中,特征预测为17.6,增加深度损失为16.0,直接深度为14.2,支持这套训练与模型规模下的几何目标选择。
反方 · 哪些结论还不够
Cosmos-3使用零样本发布模型,而GeoWM有目标数据集的深度监督;不能把数值差距全部归因于架构。
DOMINO双重域外长时域δ1为72.0%,低于Cosmos-3的74.8%;并非所有指标、所有单元都更好。
递归消融复用按真实历史训练的直接预测检查点,递归输入存在分布变化;它没有证明最优训练的滚动模型必然失败。
综合判断
这是有说服力的定时域几何预测方案,价值在直接监督和运动投影锚点。证据还不足以把它称作可执行任意控制、具有绝对尺度保证或跨时间一致的通用世界模型。
我会先做的验证
建议实验,未执行:留出训练中未出现的时域与数据域,在不使用未来真实深度尺度对齐的条件下评测;匹配训练预算和硬件、纳入几何骨干成本,并比较相同总计算量的直接与专门训练递归模型。另加入动作干预与跨时刻点云一致性测试。