Grid-Bench:规则全部写明,模型还能追踪64步世界状态吗?
把感知与知识检索拿掉,用可执行网格检验长程状态模拟。
如果初始世界和每一步规则都明确给出,模型仍可能在长序列中丢失状态。Grid-Bench 用二维到四维的符号网格,把运动、反射、重标记等过程变成可精确核对的下一状态计算。它衡量语言模型的内部世界模拟,而不是视觉生成质量,也不与大模型栏目重复计数。
图解主要方法
把感知与知识检索拿掉,用可执行网格检验长程状态模拟。
- 1
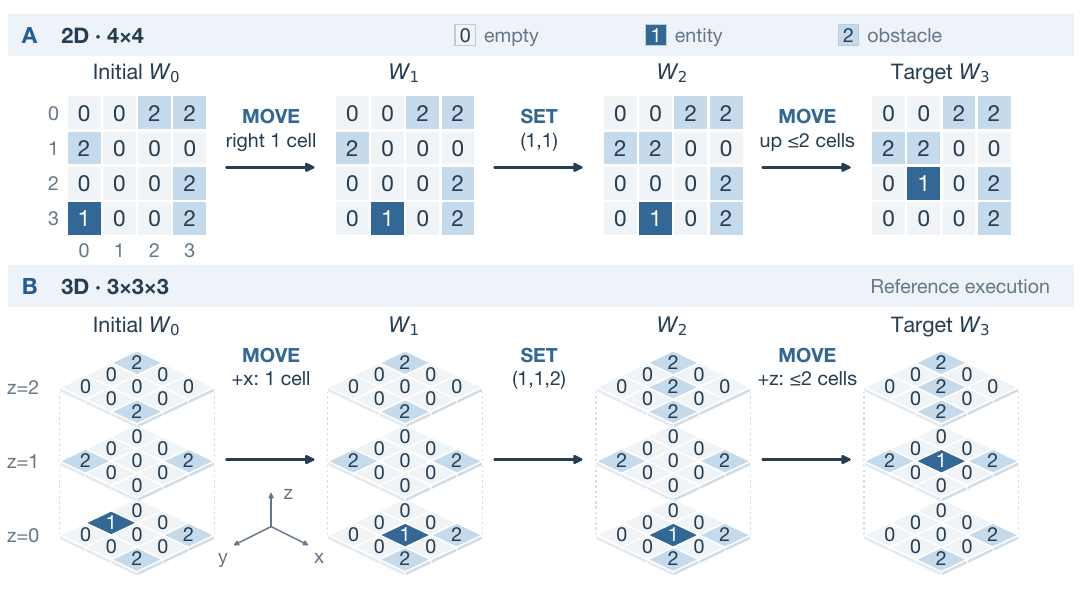
图1:所有规则和状态显式给出
输入初始 JSON 网格、操作定义和完整历史。例如先右移,随后 SET 放置障碍,再向上移动时必须在障碍前停住。SET 也计入步数,不能只统计主操作;没有依靠常识补充隐含碰撞规则。
- 2
生成具有有效工作量的轨迹
八类操作为 PAINT、REFLECT、STENCIL、MIX、RELABEL、LAYER、MOVE、COMPRESS。旧状态同步更新与 MOVE 的前沿优先顺序区分;生成器按支持区域、密度和有效变化筛选。2/3/4维体积接近256/252/256,但邻接和边界结构仍不同。
- 3
同一轨迹取六种长度前缀
248条轨迹各取6个前缀,共1488条查询;主实验192条轨迹形成1152条,另336条补充。模型每题独立生成一次、无工具、总 token上限128k,支持时启用高推理,超时7200秒。后缀题答对不表示同一会话从先前错误中恢复。
- 4
同时保留完整正确与局部误差
EM要求整个世界完全一致,格式失败也记零;单元格准确率 CA 仅在合法状态上计算。解析最后一个 JSON,不依据答案修复;置信区间用2000次按轨迹分层 bootstrap,保留嵌套前缀相关性,不能将1488条当成独立样本。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据GPT-5.6-Sol 在T1为183/192、95.3%完全正确,T64仅25/192、13%;Claude在T64为14/192、7.3%,但合法输出只有58个,Sol为191个。 主实验:长序列退化 ↗
我的解读Claude合法输出 CA90.5%与 Sol81.6%来自不同子集,不能据此宣称前者总体状态跟踪更准。模型调用收集于9月16–24日,论文首发10月15日,不是10月新模型发布。
来源证据Sol在T64的191个合法输出中 CA81.6%,复制初始状态基线51.0%,180个优于复制。Kimi与MiniMax在T8 EM接近33/192和31/192,共同84个合法但错误样本的错格中位数为14和67。 局部准确仍有信息 ↗
我的解读完全正确率会掩盖错误严重程度;局部比较需限制同一输入子集,并同时保留格式失败,避免选择偏差。
来源证据作者用独立字典实现检查全部1488个实例与30008次事件,未发现不一致。RELABEL接触合并事件仅4.3%,其较高分不等于重标记天然容易。 参考执行器与难度边界 ↗
我的解读独立检查是作者报告,本站未重跑。维度变化同时影响坐标、邻接和边界,不能直接解释为纯“维度推理”因果效应。
开放情况与使用许可
作者 Grid-Bench 代码根许可 MIT,LICENSE-DATA 明确数据 CC BY 4.0;Hugging Face 可取得1488题及8928条结果记录,但不是完整原始模型回答。当前代码版本0.6与论文生成器0.5不同,复现应固定版本。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
完全可执行的规则与双实现核对让错误可定位到更新顺序、障碍处理或长程累计;结合 EM、合法率与共同子集局部误差,比单一总分更适合世界模型诊断。
反方 · 哪些结论还不够
符号网格没有现实感知噪声、连续物理或开放动作空间;生成器分布决定难度,强推理和长时限也不对应实时部署。数据不包含原始模型完整回答,限制复查输出解析。
综合判断
是可审计的长程状态模拟压力测试;失败说明显式规则执行仍脆弱,但不能直接等同真实机器人或视频世界模型的能力上限。
我会先做的验证
未执行的验证方案:固定共同有效输入比较错格与非法率,保存原始回答;增加等计算的工具执行基线,并单独控制维度、边界暴露和每步改动量,检查错误是否集中在特定操作。