HarnessEval-W:让世界模型评分带上可检查的证据
按案例选择评测技能,观察质量、状态转移与持久性分别判断
一个漂亮视频的高分不说明动作正确或离屏状态持续演化。HarnessEval-W 把每个案例拆成能取证的问题,以工具和视觉模型分别检查,再保存评分与证据路径;它的主要贡献是可审计评测流程,而非证明某个模型全面理解物理。
图解主要方法
图 2 的路由、分题和聚合怎样防止评估不适用的问题?
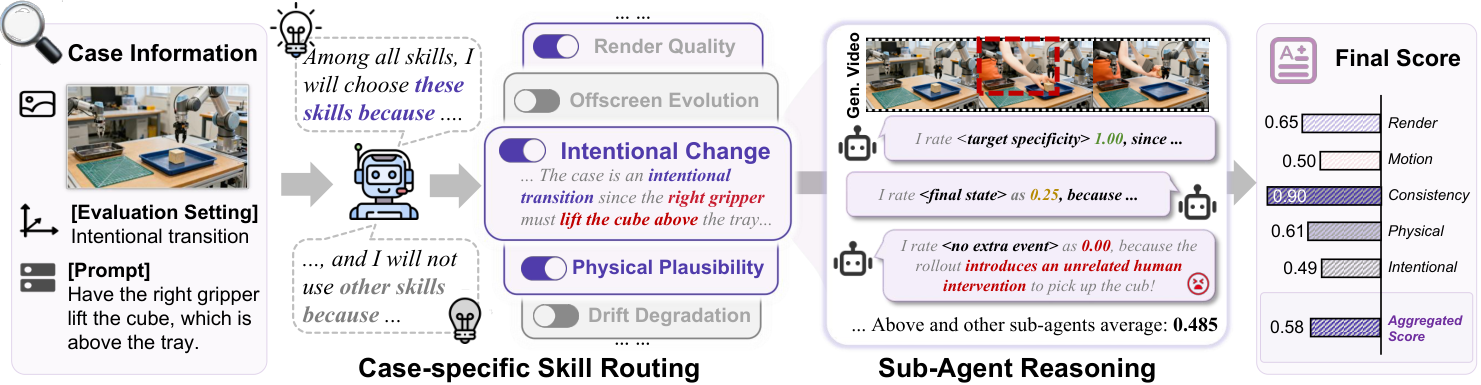
- 1
先冻结案例,再选择适用技能
图左输入初始世界、动作与评估意图,路由只依赖这些信息,对同一案例的不同被测模型一致。八个维度覆盖画面、物理外观、探索/意图/物理转移及漂移/回访/离屏演化;不适用的技能记录跳过理由。
- 2
把整体判断拆成可检查子问题
图中把目标是否可见、动作是否发生、最终状态是否正确、旁侧物体是否保留等分开,用视觉判断或运动工具取证。分题提高可追溯性,但同一视觉模型产生的判断仍可能共享偏差,不能把多个角色当多份独立实验。
- 3
用证据门控而非盲目平均
图右以可见性和可判断性门控结果,再组合转移效果、受保护状态和额外事件。缺失必需证据的分数记为不可用,聚合时剔除或重归一;因此必须一起报告有效样本覆盖,避免难例缺测后分数虚高。
- 4
让物理工具服从适用条件
附录用光流/轨迹辅助验证抛物、碰撞等,但要求相机和背景较静、主体可辨。回访使用图像及CLIP相似性,照明变化也可能影响结果;工具输出需要放回案例语义中审查,不等于读取真实隐藏物理状态。
实验与证据
以下为作者报告;已阅读 v2 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【评估范围】论文固定330案例、18模型,保留文本、相机或原生动作接口并做适配;不同维度按适用子集平均。 主表 2、附录 A/C ↗
我的解读我的解读:同一意图在不同控制接口下未必同等可表达,整体排行可能混入接口能力;不宜直接宣称通用世界模型冠军。
来源证据【人类对照】约5000组A/B判断覆盖9模型和意图/物理转移两维,Spearman分别0.93/0.87;物理配对准确率71.7%,WBench31.9%。 第 5.3 节与图 6 ↗
我的解读我的解读:在人类偏好对齐上有支持,但不是所有八维都被验证;粗离散分数的平局率差异也影响配对指标。
来源证据【稳定性与开放集】重复试验是同GPT-5.5、温度0的三轮,而非跨后端稳健性。官方README公开集标为100案例,论文实验为330案例。 图 8、官方仓库与数据发布说明 ↗
我的解读我的解读:三次稳定不保证跨裁判无偏;复现时必须区分公开集与完整论文集合,不能直接把两者榜单数值混用。
开放情况与使用许可
已核实评测实现、聚合脚本和案例文件;官方提供100案例公开集,不能等同论文330例。README声明代码Apache-2.0,数据卡也标Apache-2.0;未实际执行依赖与评测。
LICENSE代码许可按README声明、数据按模型库卡核对;原论文及图2为CC BY-NC-SA 4.0,不能以代码许可替代论文图片许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
分题、工具、有效性门控和证据记录能把总分还原为具体失效原因,便于改进动作执行与状态保持。
反方 · 哪些结论还不够
裁判共同偏差、缺测覆盖、接口不等价与有限的人类验证仍存在;可解释记录不自动使结论正确。
综合判断
适合作为世界模型诊断框架,并辅以人工盲审、覆盖率和可控物理测试;排名应按同接口同案例比较。
我会先做的验证
未执行的验证方案:冻结公开案例与版本,用多个裁判后端重跑并盲审分歧;人为注入目标替换、离屏重置、假碰撞,测分题检出率和缺测率,同时报告含/不含缺测的排行敏感性。