HLA-WM:回到旧场景时,按相机几何重组线性注意力记忆
无需重训的历史摘要检索;12倍节省针对历史状态,不是整机显存
HLA-WM把Gated DeltaNet每段历史的状态变换单独缓存,按相机视锥重叠挑选相关片段,再按时间顺序重组当前记忆。它无需微调即可改善长视频回访一致性,但仍保存随片段数增长的摘要库,也没有建立遮挡后物体演化的物理状态模型。
图解主要方法
线性递归记忆遗忘了远处场景,能否在不重训、不保存全部视觉KV的情况下恢复?
- 1
把每个历史块写成独立仿射摘要
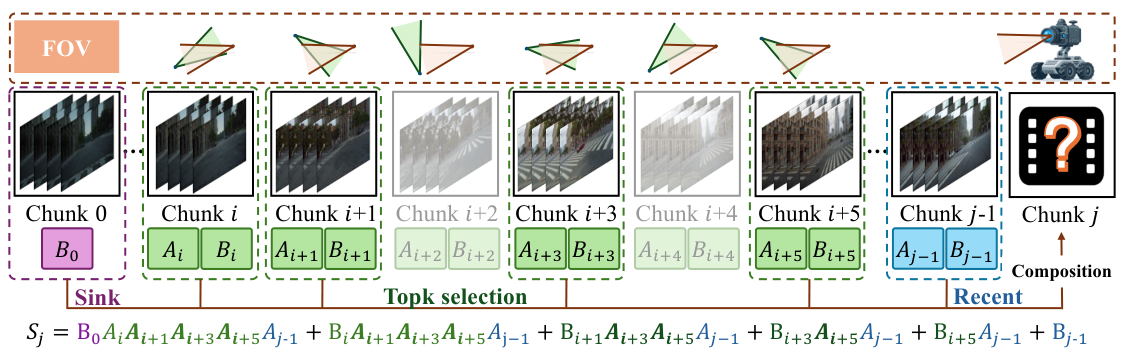
图3每块保存A和B,递推为S新=S旧A+B。A表示怎样变换此前记忆,B表示新写入信息;按原扫描顺序相乘和累加即可合成,无需重跑整段视觉token。
- 2
利用相机视锥选择相关历史
根据相机内外参,在画面7×7射线和场景中位深度的0.5、1、1.5倍处放代理点,计算双向落入视野比例。默认取Top1远期块,再保留首块sink与最近块;这不是精确深度重建或遮挡判定。
- 3
转弯时扩展近期上下文
当前块早段与晚段平移方向差达到25度时,将近期块数从1增到3。判据使用预定相机轨迹,保持转向处局部连续性,而不是由生成图像学习一个路由器。
- 4
按时间顺序重组,并对齐另一条注意力通道
图3底部合成被选块的A、B,跳过无关历史的衰减变换;softmax分支选择同一组KV。只替换主GDN矩阵和归一化状态,相机GDN、短卷积与FFN时序卷积保持原始递推。
- 5
生成当前块后写入新摘要
SANA-WM Stage1保持原权重与4步蒸馏采样,每块3个潜在帧。完成后额外进行t=0写缓存前向,保存该块摘要;下游AR或双向精修不重训,也不回放历史视觉token。
实验与证据
完整阅读68818字符正文、参考文献与附录A.1–A.9,视检图3,核对官方代码树、推理入口、许可和SOURCE公开范围。未运行H200视频实验。
来源证据单H200 140GB;SANA-WM-Bench简单/困难各80条、每条961帧约60秒、1280×704;MBench-A共547样本。 第5.1节 ↗
我的解读这是固定模型、输入、提示和相机轨迹的成对推断比较,优势是避免训练计算差异;没有独立运行复现。
来源证据困难轨迹Stage1 PSNR9.37→10.11、SSIM0.1774→0.1997、旋转误差20.3759→15.0887度。 表1 ↗
我的解读回访在同一模型首次和再次观察间比较,证明更一致,不是对真实世界几何的绝对准确度。
来源证据简单轨迹AR精修后PSNR14.44→14.82,但平移误差2.1587→2.1910、CamMC2.3121→2.3240。 表1、附录A.8 ↗
我的解读整体回访更相似时,部分控制指标仍略差;不能将Stage1六项改善套用所有精修子集。
来源证据60秒历史状态2.15GiB,约为完整KV的1/12;Stage1吞吐22.403→22.053FPS,降低约1.56%。 图4、效率分析 ↗
我的解读它在原生GDN之上增加独立历史库。该数字不含整套模型、VAE与精修器全部显存,也不是固定内存无限生成。
来源证据Hard双向精修仅GDN重组SSIM0.3304高于完整方法0.3142,但旋转误差33.0406度远高于完整方法10.5268度。 附录表4 ↗
我的解读两条记忆通道错配可能破坏控制,验证时需要同时检查外观与轨迹而非单看SSIM。
来源证据K=4时Uniform PSNR9.91、几何10.00;Uniform平移误差1.6881略好于几何1.6985。几何策略转弯时可多保留2块。 附录表6–7 ↗
我的解读几何检索有增益,但不是严格等预算;K=1回访最佳,K=5旋转误差更低,预算取舍没有单一最优。
来源证据公开SOURCE明确不包含训练、蒸馏、完整基准和若干消融。推理入口的中位深度默认3.0,须与相机平移单位一致。 官方源码与公开范围 ↗
我的解读公开代码足以核查主要推断机制,完整复现全部表格仍需补充实验脚本与正确场景元数据。
开放情况与使用许可
2026-10-11核对Caesarhhh/HLA_提交5879c5a6b2bae7b09fdce02e86eb5c32bc438b52,含实际推理、GDN内核、相机检索与重组实现。SOURCE说明公开Top1及基线,排除训练/蒸馏、完整benchmark和若干消融变体;使用SANA-WM现有权重,无新的训练权重。
LICENSE论文与图3CC BY 4.0;hla-wm子目录Apache 2.0并保留上游来源。SANA-WM、文本编码器、refiner权重许可分别适用,不能由代码许可推断统一商用范围。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
通过仿射变换合成保存每段对记忆的影响,比把旧状态直接平均更忠实于原GDN递推;选择全部历史时可退化为原递推作为检查。
两个基准、三个推断模式的回访指标均有整体改善;附录把GDN重组与softmax KV对齐分开消融,揭示两条记忆通道的相互作用。
反方 · 哪些结论还不够
几何检索与Uniform在较大检索预算下PSNR只差0.09dB,且转弯时额外保留近期状态,比较并非严格等计算预算。
Hard双向精修中只改GDN可使SSIM上升但旋转误差13.17度恶化到33.04度;单一相似度提升不能代表摄像机控制也好。
摘要库仍随历史长度线性增长;12倍对照是完整KV,不是原生GDN的常数状态或整模型显存。
综合判断
一种机制清楚、实现已公开的免训练记忆改造,适合研究相机回访一致性。证据尚不足以说明它能维护会随时间变化的完整世界状态。
我会先做的验证
建议实验,未执行:固定相同历史状态数与计算预算,对比几何、Uniform和随机检索,加入深度误差、相机标定噪声、遮挡及物体已移动的回访场景;同时记录旧外观复现、正确新状态、相机误差、总显存和超过60秒后的增长。