Holo4D:用持续三维轨迹约束动态视频换视角
几何轨迹怎样进入视频扩散模型,哪里仍会出现不可见区域幻觉?
Holo4D从源视频提取持续三维轨迹,投影到目标相机后作为视频生成条件。它生成的是新视角RGB视频,不输出可编辑网格、UV或PBR材质;几何约束减少不一致,但不会自动补出真实的遮挡背面。
图解主要方法
几何轨迹怎样进入视频扩散模型,哪里仍会出现不可见区域幻觉?
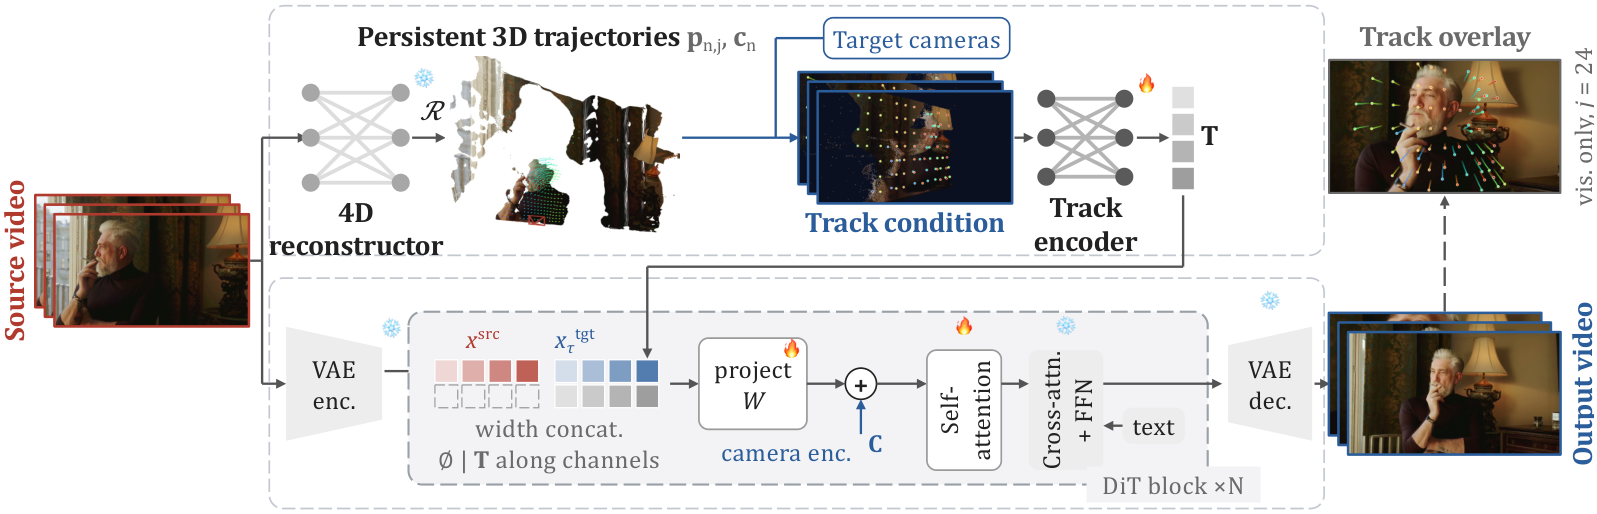
- 1
图2左:先重建动态轨迹
4D重建器从源视频得到持续三维点轨迹,使用查询帧颜色和目标相机投影形成位置、深度、有效性、时间与RGB特征。有效标记只表示投影有效,不是完整遮挡可见性判断。
- 2
把稀疏轨迹编码为目标视频条件
MLP后以scatter/channel-max聚合并附占据标记,再由因果3D适配器对齐视频token。未观测位置使用空条件;这种稀疏几何提示不能替代完整表面和材质表示。
- 3
在DiT中融合源视频和目标条件
干净源潜变量与带噪目标潜变量沿宽度拼接,保持时间对应;轨迹通道条件注入各DiT块,并用Plücker射线编码相机。图2虚线框展示生成网络,输入几何并不是最终导出的三维资产。
- 4
长视频分块续接而非无限窗口
初始49帧与后续I2V片段采用生成边界帧连接。机器人视频的首窗口零样本表现与后续在相关数据训练的续接模型应分开,不能把整段长rollout统称零样本。
实验与证据
已阅读正文及训练、后端、速度、迁移相关附录,核对实验条件与原图;未独立复现。
来源证据Wan2.1 T2V 14B、40块,训练自注意力与新增条件,冻结部分既有层;先144×256训练15000步,再384×672训练4500步,49帧。 模型与训练 ↗
我的解读训练成本、基础视频先验与外部几何重建共同贡献结果,不是只靠轨迹模块的小模型。
来源证据DAVIS50源片×两轨迹100输出;匹配后端条件下平移误差较Vista改善,但旋转指标ReCam为.099、Holo .102。iPhone五场景两阶段PSNR13.20、LPIPS.465,另法SSIM更好;Pi3后端某旋转结果也较Vista差。 多视角与真实视频 ↗
我的解读不能将一个平均或平移指标推广为所有相机运动、后端和重建指标都最佳。
来源证据报告约1.34倍去噪阶段加速,但加上几何处理的端到端时间相近。5B策略增广LIBERO为52.10对50.81,视角变化任务8.01反低于9.01,只有一个种子。 速度及机器人迁移 ↗
我的解读更快去噪不等于更快总管线;新视角视频也未稳定提高机器人策略泛化。
开放情况与使用许可
GitHub含训练、推理和评估实现,Apache-2.0;HF模型卡也标Apache-2.0,并列出T2V/I2V检查点与评估素材,基础模型和数据上游许可仍需分别核对。论文自身为CC BY-NC-ND 4.0,不与代码许可混同;本文保留原图内容。
LICENSE论文 CC BY-NC-ND 4.0;代码/发布模型标Apache-2.0,依赖许可另核
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用持续轨迹约束动态换视角,比逐帧图像编辑更直接处理跨帧几何一致性。
反方 · 哪些结论还不够
几何估计和遮挡误差会传给生成器,未提供可编辑部件、UV、去光照材质或物理重光照;生成细节仍可能幻觉。
综合判断
适合预览与视角数据增广研究,不应直接当作可交付三维资产重建。
我会先做的验证
未执行的验证方案:固定源视频与相机,按遮挡、细杆、镜面和快速运动分组测轨迹漂移、重复纹理及跨视角一致性;另测包含重建的总耗时,并用多种子验证策略增广。