Hy-Nomas:让动作指令只在该发生的时间生效
交替文字与相机控制时,如何保留历史而不重演旧动作?
8B视频世界模型将持续场景描述和有时间范围的动作指令分开,再用分段因果注意力生成后续画面。它支持同一会话交替文字和相机输入,但生成视觉连续性不等于物理状态正确。
图解主要方法
交替文字与相机控制时,如何保留历史而不重演旧动作?
- 1
结构化历史与当前动作
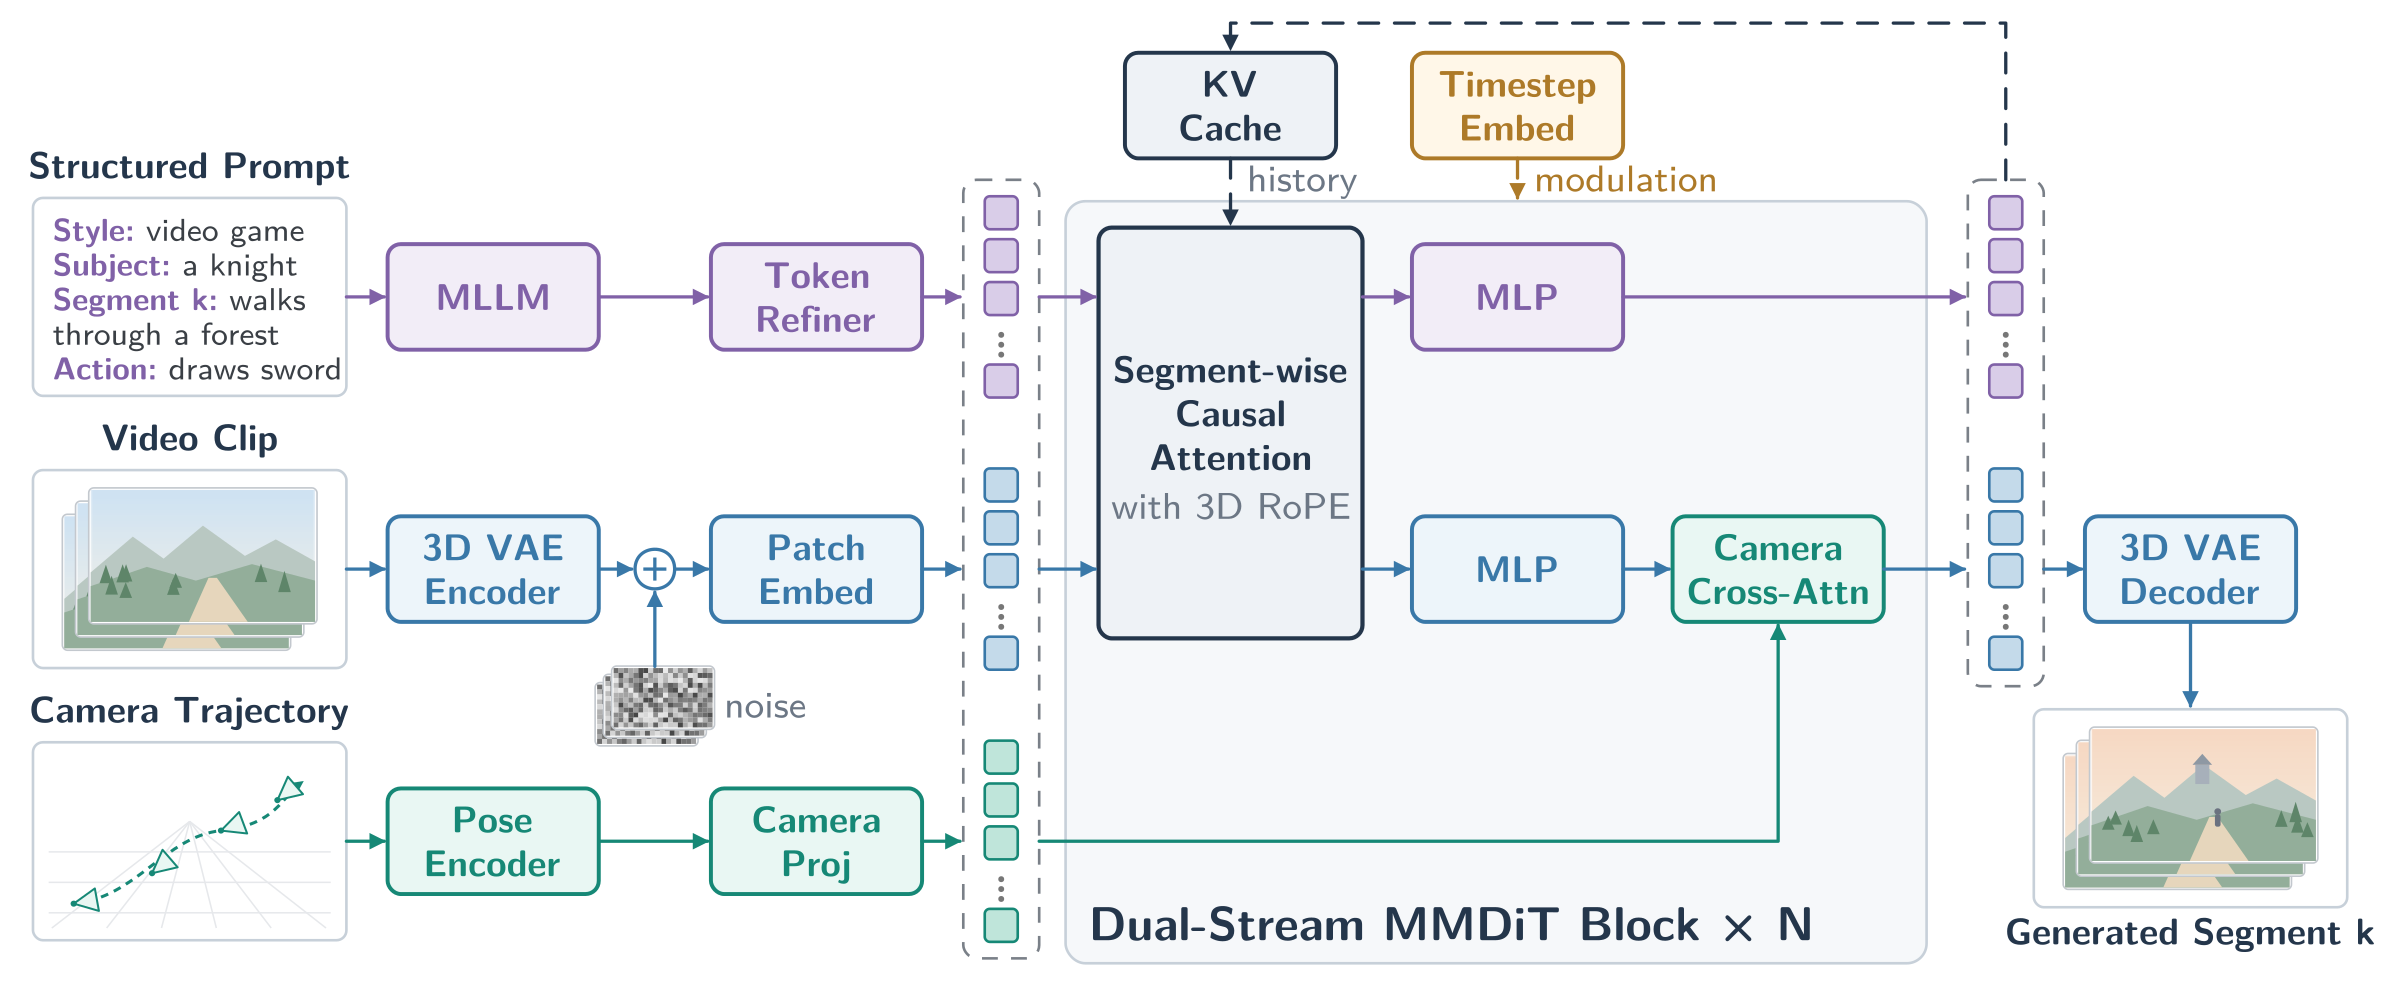
图5将带主体ID的结构化文本、视频latent和相机轨迹分别编码。描述头可供后续段读取;动作尾只在本段及标注时间窗内可见,避免后续生成重复旧动作。
- 2
相机是逐帧连续条件
相邻相机位姿转成相对变换,每4帧合并为64维token,在54个MMDiT块中交叉注意力注入。训练按段混合文字和相机模式,防止直接从相机描述文字偷取轨迹。
- 3
训练接近自身历史,推理限制缓存
segment forcing 用自己的一步低噪预测形成下一段缓存;再由100步蒸馏至4次网络求值。推理INT8权重/历史缓存、滑动窗口与CPU卸载控制显存;Prompt Enhancer根据历史生成下一段条件。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据280案例分60文字、100相机、60交替、60空间记忆;三名标注员一组。文字遵从对HappyOyster胜65%、负10%,对LingBot v2胜75%、负8.3%。 Hy-Nomas-Bench与人评 ↗
我的解读比较受原生接口限制;需要首图的基线使用Hy-Nomas首帧,LingBot交替接口经作者改造,不是完全统一输入机制。
来源证据视角离开后返回,对Genie3胜13.3%、平56.7%、负30%。单4090生成100秒、1280×704、24FPS的视频峰值20.53GiB。 空间记忆与部署 ↗
我的解读24FPS是输出播放帧率,不是实时生成吞吐;显存可运行也不代表交互延迟达标。空间记忆仍有明确短板。
来源证据风格LoRA人评文字胜35%负24%、物理观感胜46%负13%,相机控制则胜19%负37%。 LoRA取舍 ↗
我的解读少样本风格适配可能伤害原有控制能力,不能只看精选外观示例。
开放情况与使用许可
已核对官方实现目录和Hugging Face权重文件:base/distilled/INT8 DiT、PE、VAE和LoRA均有条目;仓库与模型标示Apache-2.0。README称代码初发10月21日,本文日期为10月27日预印本首发,不把论文日当代码初发日。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将描述保留与动作时间范围分开,是多轮视频控制中清晰可实现的改进,且公布了可检查的权重与代码。
反方 · 哪些结论还不够
人评物理观感不验证动力学;模型缓存有界、长程记忆未解决。缺少完全匹配的系统消融,PE和骨干贡献也需分开。
综合判断
适合交互视觉原型与受控视频创作;不能充当可保证物理状态的机器人模拟器。
我会先做的验证
未执行的验证方案:固定首帧和相机轨迹,反复执行开门、移物、离开再返回,按对象状态逐帧标注;分别测有无PE与LoRA的指令遵从、记忆和真实生成延迟。