In CEM:世界模型也在决定下一轮搜索什么
排序器兼任候选分布生成器;距离变小不代表规划判断改善
研究把CEM规划中世界模型的两个角色拆开:对当前动作序列打分,以及通过精英集改变下轮采样。四种代理模型交叉重评分,再仅用真实环境替换第一次精英选择,检验早期候选分布如何影响最终选中序列。原本预期的提案距离增长没有出现,距离分量揭示了另一种收缩掩盖误差的机制。
图解主要方法
当世界模型改变了自己下一轮要评价的动作分布,该怎样审计规划误差?
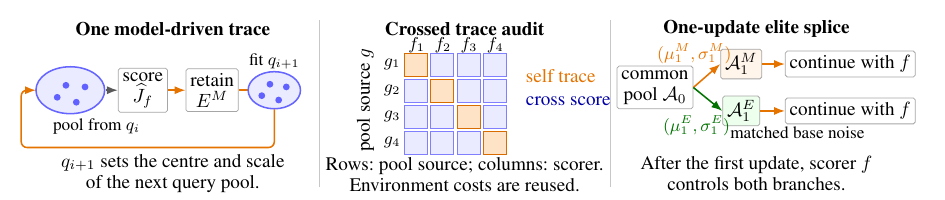
- 1
拟合四种上下文代理
冻结Dreamer上下文,使用identity、learned、anchored和random nonlinear特征图;动作条件线性转移自由滚动15步,预测上下文、奖励和继续概率。identity宽1280、其余256,不是严格同宽比较。
- 2
保存每轮候选并交叉评分
每池256条、取32精英、四轮CEM,动作维6、时域15;四种生成器的候选从同一真实保存状态执行,再让全部评分器重评分,形成4×4矩阵。
- 3
拆开提案均值和方差误差
按当前搜索标准差归一化均值差,另计对数标准差差;报告合成距离与白化Wasserstein距离,避免方差收缩掩盖均值方向错位。
- 4
只替换首次精英更新
从共同初始池分别以模型成本和环境真实成本选精英;此后两分支继续同一原评分器、匹配基础噪声,只改变第一次候选更新。
- 5
留出种子检验最终选择
前三种子依据自身池残差选random nonlinear作为干预对象,后三种子检验;最终比较截至末轮由模型选中的有限时域序列真实成本,不当作闭环任务回报。
实验与证据
全文与附录A–I、全部指标定义及预算阅读;PDF第2页图1原图核验,明确探索性与预指定分析。
来源证据原定义提案距离Walker .254→.235、Cheetah .252→.235,12个任务种子都下降。 表1;附录指标 ↗
我的解读原先“搜索会放大该距离”假设被否定;距离下降不能独立证明排名更准确。
来源证据均值误差Walker .200→.288、Cheetah .184→.292;对数尺度误差分别.293→.165、.303→.156。 表1 ↗
我的解读合成距离由尺度分量下降主导;白化Wasserstein距离反而约增25%和33%。
来源证据排序一致性Walker .503→.503,Cheetah .535→.523;机会校正精英重合度0→−.001、.071→.040。 表1 ↗
我的解读候选分布更集中但排序没有改善,且大部分表现接近机会水平。
来源证据交叉矩阵评分器列平方和占比Cheetah66.2%、Walker28.7%;生成器行分别10.0%、31.6%。 交叉审计表 ↗
我的解读任务依赖明显,不能把66.2%说成世界模型错误的普遍因果份额。
来源证据首次先知精英替换最终成本差,额外种子Walker−.253、Cheetah−.620;全部12任务种子方向为负。 干预结果;附录 ↗
我的解读按初始池P90−P10成本跨度归一化,不是成本下降25.3%或62%;干预依赖真实环境评分。
来源证据总报告约179GPU小时,混用H200/H100/A100/L40S/V100,含约133小时骨干、4.6小时拟合和41小时审计。 附录预算 ↗
我的解读异构设备小时不是统一计算量,也不含全部失败和探索实验;不是实用规划运行时。
开放情况与使用许可
附录I明确代码、检查点及保存状态拟随正式发表归档,当前没有可核实的完整公开包。
LICENSE论文CC BY 4.0;图1由PDF页面裁出并注明,未改动图内内容。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定环境状态、共享基础随机噪声,分离候选来源与评分器。
原假设被否定仍完整报告;首次精英替换在额外种子上保持最终成本方向。
反方 · 哪些结论还不够
交叉矩阵平方和分解是描述性关联,不等于模型角色的因果贡献。
196608次序列执行并非同数量独立样本,独立训练单位只有12个任务种子。
指标分量分析在先导实验后提出;不应把全部结果称预注册确认。
综合判断
有效提示规划评测要同时审计候选分布和打分;证明一次早期精英决定会影响后续搜索,尚未证明闭环控制收益或一种更好的可部署规划器。
我会先做的验证
建议实验(尚未执行):在非线性转移、更多环境及多种CEM预算上,用独立留出种子比较可部署校准/重采样;报告闭环回报、计算成本与候选覆盖,和先知干预分开。