InfiniSplat v2:冻结几何,用高斯属性学习改善新视角
降低渲染伪影是否意味着几何和材质也变得可靠?
InfiniSplat v2从多视图重建高斯场景,冻结深度与相机分支,仅学习颜色、尺度、旋转和不透明度。六数据集感知指标改善,但固定中心无法修复严重几何错误,输出也不是具备UV和PBR分解的网格资产。
图解主要方法
降低渲染伪影是否意味着几何和材质也变得可靠?
- 1
01 · 分离几何和外观学习
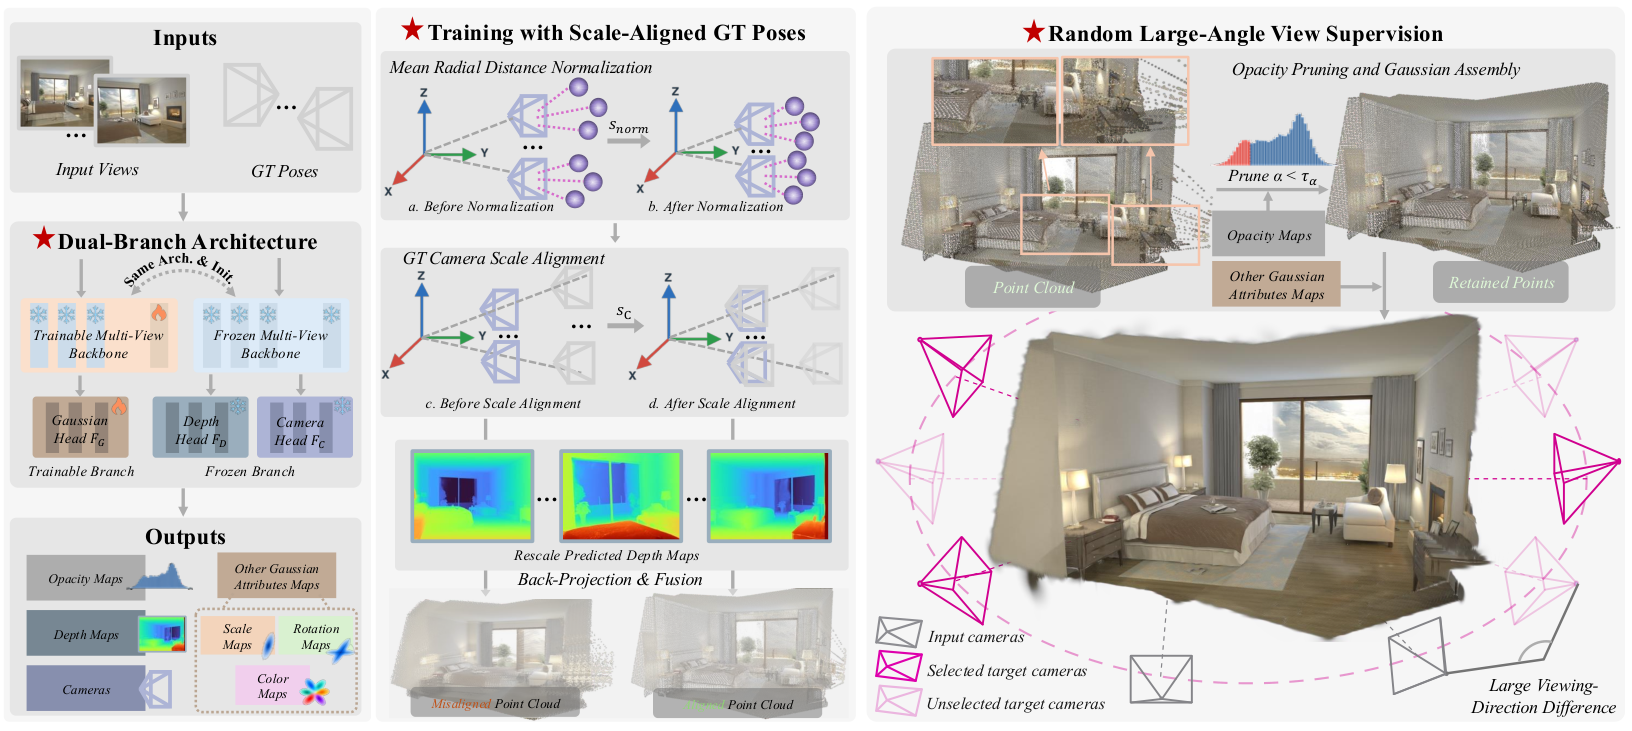
图2两条DA3分支独立初始化,几何分支完全冻结,属性分支只调最后10层与DPT头;中心来自深度反投影,不允许用位置偏移补偿外观误差,输出零阶球谐颜色及高斯尺度、旋转、不透明度。
- 2
02 · 训练时对齐真值相机尺度
先用预测点平均径向距离归一化,再由输入相机中心拟合Umeyama尺度;仅保留尺度,真值相对旋转和内参不改。训练用尺度对齐真值相机反投影与监督,推理可用给定位姿或冻结分支预测位姿。
- 3
03 · 让较大角度视图约束高斯形状
候选目标按与最近输入光轴的夹角排序,70%从大角度半区采样,30%从小角度半区;真值深度遮罩限定有输入支持的监督区域。体素合并并裁掉不透明度低于0.01的点,减少异常点影响。
- 4
04 · 用学习到的更新器细化属性
第二阶段冻结重建器,四层KNN Transformer结合当前属性、输入视图渲染梯度和图像特征,执行三次属性残差更新。梯度是网络输入而非直接Adam步骤;中心和点数固定,目标图像不作为推理反馈。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据输入4、8、16视图,六数据集等权;有位姿前馈LPIPS0.2472、DISTS0.1163,分别较各指标最强对照降低25.8%和32.9%。 表1:分开相机条件 ↗
我的解读两个百分比对应不同基线,不能写成对同一系统全面提升,也不能混合有位姿与无位姿比较。
来源证据无位姿细化使LPIPS0.3026→0.2970,但DISTS0.1341→0.1379变差;有位姿前馈PSNR20.2824低于ReSplat20.9139。 附录B:细化并非所有指标都升 ↗
我的解读感知指标领先不代表像素误差或每个数据集领先。
来源证据独立真值深度定义36125个不一致点,阈值0.01去掉其中51.8%,总点仅去掉7.5%,保留93.3%一致点。 图7与附录B4:透明度只是筛选信号 ↗
我的解读压低异常点贡献不等于修好几何,还剩约一半异常点;标签与评估来自Hypersim限定条件。
来源证据16张H20两阶段约48+13小时;8输入视图1022×756时网络5.619秒,378×280时0.564秒,单场景5次计时。 附录A与B5:训练与延迟 ↗
我的解读这是神经模块延迟而非完整资产交付时延;不能推广为所有场景实时,未验证重光照、去光照、UV与PBR。
开放情况与使用许可
2026-10-19确认官方仓库v2有模型、几何与导出实现,Hugging Face公开model.safetensors和配置文件。仓库PRL v1.0允许研究、教育、个人用途免费;组织项目使用需事前登记,第三方组件保留自身许可。未实际运行模型,也未替用户提交登记。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
冻结中心阻断了图像重建损失牺牲几何的路径,大角度监督与属性学习的消融提供可解释证据。
反方 · 哪些结论还不够
仍受深度先验和观察覆盖限制,可能留洞且像素高斯冗余;颜色包含拍摄光照,不能当作可重光照材质。
综合判断
适合多视图新视角渲染流程;几何编辑、网格拓扑与物理材质交付需要额外环节。
我会先做的验证
未执行的验证方案:固定输入覆盖与相机噪声,分别测渲染、几何误差、显存与端到端时延,再检查镜面表面及遮挡区;导出网格后单独评估材质分解与接缝。