InternW0:慢速预测未来,快速依据新观测调整动作
异步视频—动作专家与逐块 K/V 修正
InternW0 用大视频专家提供未来上下文,小动作专家按更高频率生成控制块;新的观测会改写动作专家看到的缓存视图。报告覆盖实验室操作与接触任务,但控制通路频率、整任务成功和子任务进度是三种不同证据。
图解主要方法
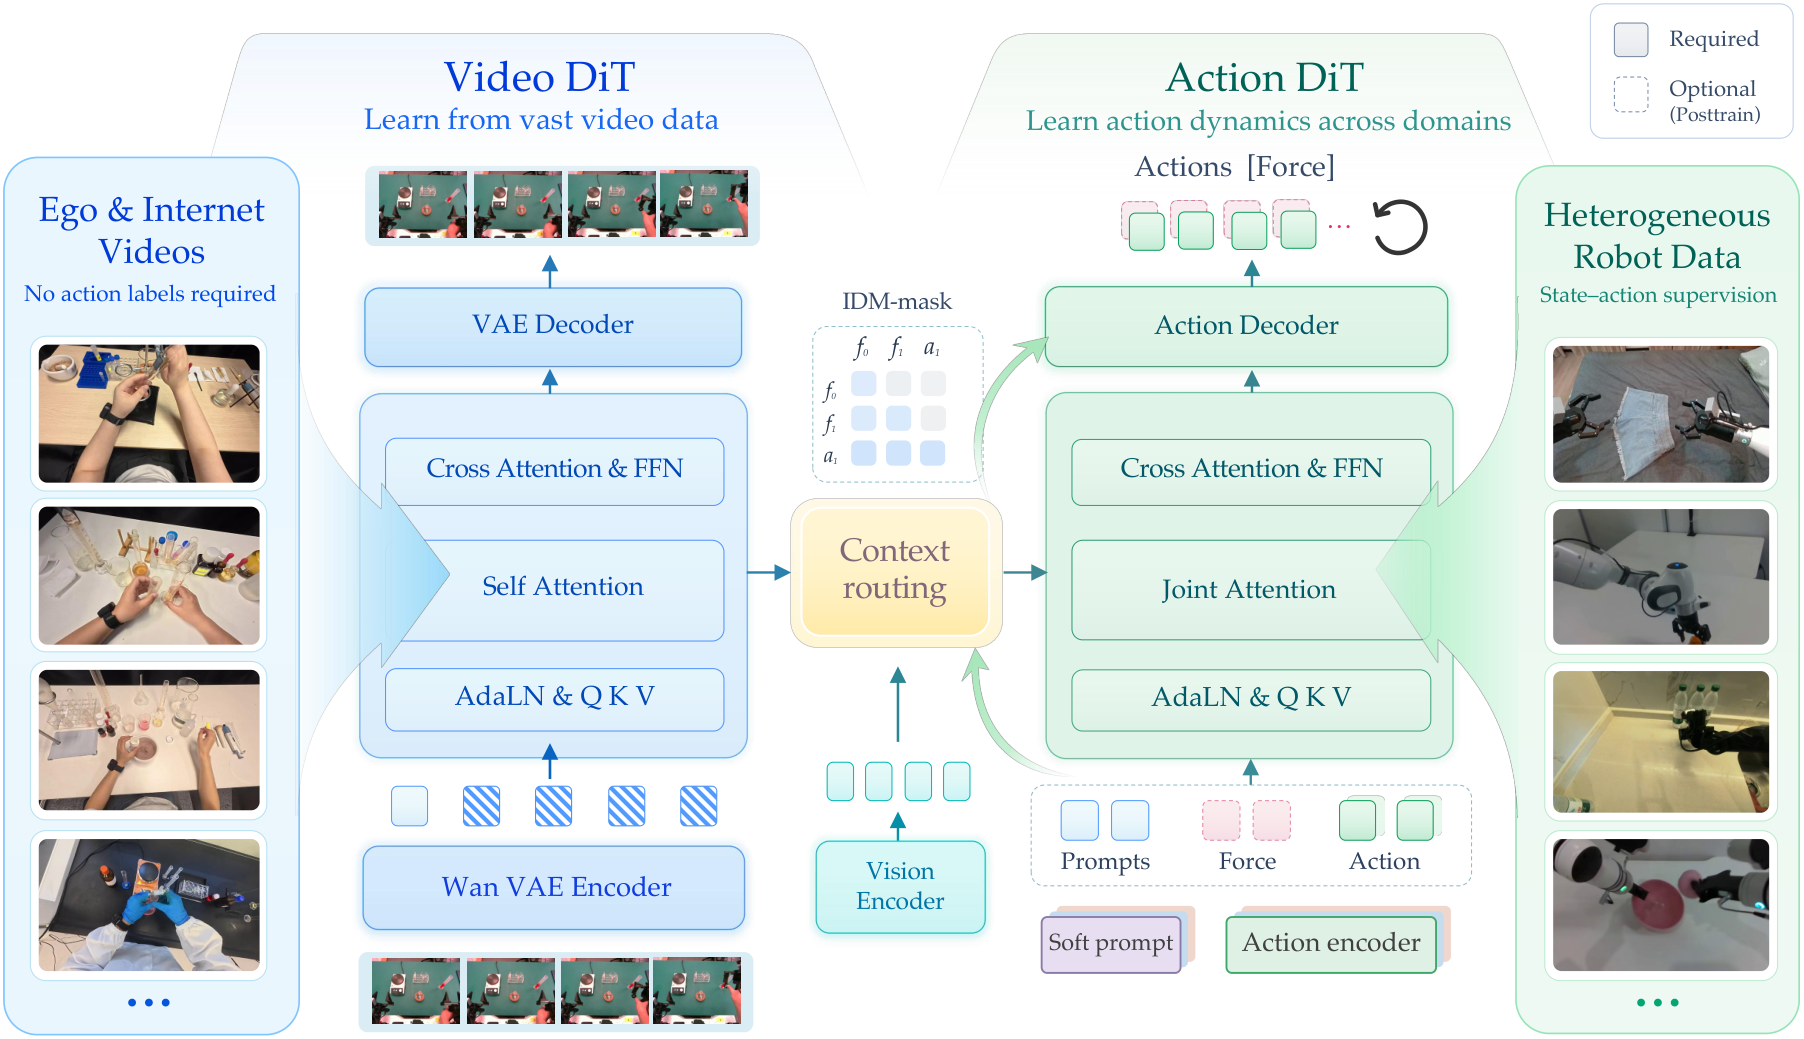
图 2 中 context routing 如何利用旧预测而不盲目执行旧计划?
- 1
共享视频先验,保留本体专用接口
冻结 Wan VAE 编码视频,DINOv3 编码当前图像。机器人状态和动作映射为 37 维,缺失通道用有效性掩码排除,域专用投影和软提示保留不同机器人语义。视频专家不读取机器人动作 token 或域 ID,动作专家读取视频上下文,因此不是对称的动作条件视频预测器。
- 2
双流训练让视频特征也服务动作
视频和动作分别做连续 flow matching。动作侧另读一个共享权重的视频条件流:一半保持干净,另一半独立加噪;它没有单独重建损失,但动作损失梯度会穿过 K/V 编辑器回到视频专家。无动作的人类视频仅贡献视频监督。
- 3
每个动作块用新图像重新路由缓存
当前观测形成少量 query,先从每层缓存 K/V 取相关信息,再分配回原视频 token 位置,预测带门控的残差修正。残差投影零初始化;基础缓存不被累积改写,每个块生成自己的编辑视图。慢视频计划更新时,再替换之后使用的缓存。
- 4
在接触后训练中加入力和触觉
动作侧可读取生成本块之前的力、触觉历史,并联合预测未来动作与接触信号。只解码动作去执行,未来力是预测而非已经观测到的反馈;这些通道在接触任务后训练中引入,不应说全部 7200 小时预训练都含触觉监督。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【数据与仿真】7233.5 小时、25 个域,含 275.4 小时 EgoLab 人类视频;RoboTwin Clean2Random 成功率 clean/random 为 83.2/68.0,均值 75.6。 表 1、4 ↗
我的解读我的解读:68.0 仅比所列 GigaBrain 的随机场景 67.9 高 0.1 点;8.3 点优势属于两部分均值,不能移作随机场景增幅。
来源证据【每任务 15 次真机】MOF 15 阶段进度为 68.4%,最后阶段到达率 26.7%;移液五阶段进度 65.3%,最后阶段 46.7%。 表 5–7 ↗
我的解读我的解读:进度不是完整任务成功;零件分拣又按对象计数。定量移液名称也不等于论文提供了体积误差精度验证。
来源证据【RTX 5090D】快速通路 60.73 ms,对应模型侧最高 16.47 Hz,含图像编码、路由和动作去噪,不含异步视频计划生成。 效率章节 ↗
我的解读我的解读:这不是视频预测频率,也不是包含机械执行与传感链的完整控制频率;与从头训练基线的差距不能单独归因于世界模型目标。
来源证据【有限数据消融】约 50 小时机器人数据加入约 50 小时 EgoLab 后,随机场景成功 13.73→21.97。 图 4 ↗
我的解读我的解读:既改变了数据类型也增加了量;不能直接作为全量模型中人类视频的净因果贡献。
开放情况与使用许可
已核对官方项目和完整技术报告;页面未给出可核实的本研究代码或权重文件。更广的几何、音频和干预建模属于系列规划,不能写成 InternW0 已完成的功能。
LICENSE论文 CC BY 4.0;模型、EgoLab 与训练系统的发布许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
缓存上下文按最新观测局部更新,让昂贵预测和快速反馈可以分开设计,对接触丰富任务很有现实意义。
反方 · 哪些结论还不够
真机样本小、各任务指标口径不同;缓存陈旧时的恢复能力、力预测校准和完整系统延迟仍缺定量拆解。
综合判断
适合研究异步世界动作模型与实验室操作迁移,离长期自主实验仍需全流程成功、操作精度和故障恢复证据。
我会先做的验证
未执行的验证方案:固定预训练数据与动作专家,比较同步重算、静态缓存和 K/V 路由;人为延迟视频计划并改变接触状态,记录端到端反应时间、力峰值、整任务成功及物理测量误差。