JCA:把生成视频里的动作交还给3D骨骼
同时生成任意拓扑rig的运动与视频,再估计相机把动作放回场景。
Joints, Camera, Action!让独立骨骼运动模型与视频模型通过双向注意力共同去噪,输出可驱动现成资产的关节轨迹,再用二维关节定位拟合相机。它把“视频里动得好看”推进到“资产能回放动作”,但当前只支持单rig与静态相机配准,不保证脚底接触或物体不穿透。
图解主要方法
同时生成任意拓扑rig的运动与视频,再估计相机把动作放回场景。
- 1
1 · 用图结构表达任意骨骼
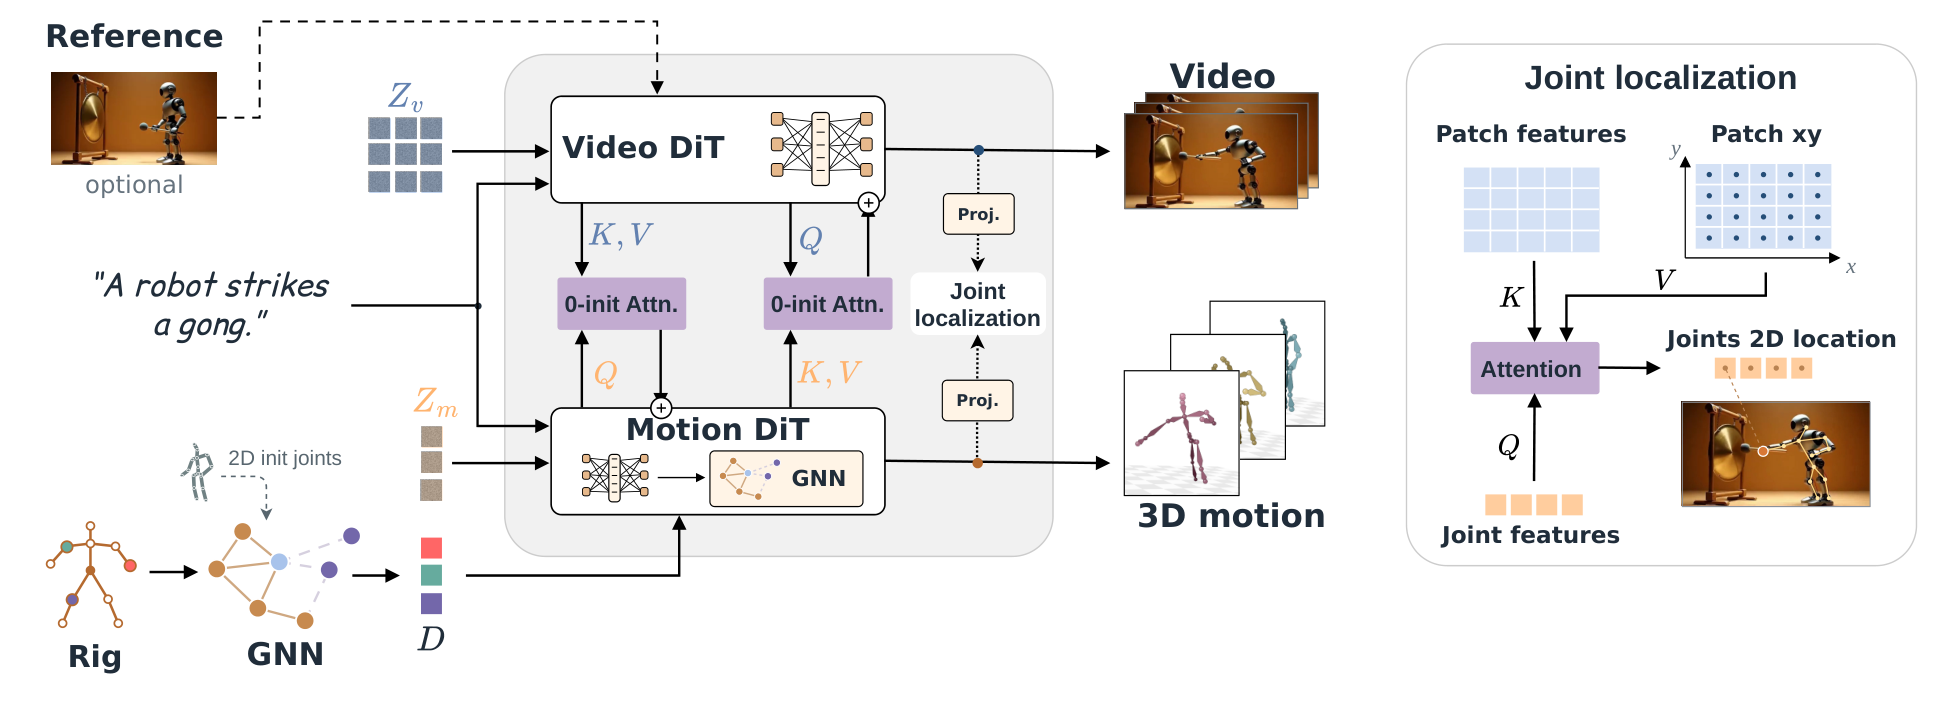
图2左下编码关节名称、静止几何、根/链/叶类型及可选参考图二维坐标,经双向GAT与全局注意力得到每关节描述。每帧关节以旋转、位置和变化量共18通道表达,根用世界坐标、非根用局部约定;先在纯运动数据训练,不要求所有运动都有视频。
- 2
2 · 小桥连接运动与视频骨干
十层motion DiT通过零初始化双向cross-attention接入Wan2.2视频骨干,起始时两边保持各自行为。共同时间坐标把运动帧n映射为n/4潜帧;运动模块、图编码器、定位头与桥约178M,连视频LoRA总可训练参数331.28M,并非整个系统只有178M。
- 3
3 · 在推理时增强两模态相互约束
bridge guidance分别计算桥开/关及文本/空文本四种预测,放大连接造成的变化。它提高视频—运动同步,但每去噪步需要四次前向;给定干净视频或运动可执行单向生成,也可用RGB关键帧引导轨迹。
- 4
4 · 二维定位后拟合静态相机
图2右侧以关节特征查询对应潜帧patch,注意力加权patch中心得到二维关节;与生成三维点配对,稳健估计整片唯一相机旋转、平移、焦距。最后IK匹配固定骨长;模型本身未读取场景3D碰撞几何。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据OiV含43K资产118K视频,编辑器为动画资产补场景,用分割与相机漂移检查保留标签;另有人体约60K、机器人约27K配对,以及125K纯运动序列。 训练数据与图文标注 ↗
我的解读比纯人体拓扑多样,但随机rig主要仍为双足;生成编辑和姿态重建的伪标签会带误差。
来源证据同起始姿态100对,用三视角渲染和模型盲评;提示符合58.4对ActionMesh43.4,网格边长畸变中位数0.20%对7.07%,动态程度0.83。 表1 · 20资产×5提示 ↗
我的解读是约1.6秒短动画、模型评审分,不是物理成功率;基线输入、视频恢复流程不同,骨架约束本身帮助保形。
来源证据通用JCA人体同步PA-MPJPE114.8mm落后EchoMotion97.7;人体微调后72.3。移除桥引导84.78,完全断桥140.71。动物67片视频恢复亦需同域微调才接近专用方法。 表2、3与附录D ↗
我的解读不能把微调后结果说成任意rig零样本全面胜出;人体同步以GVHMR恢复结果为参照,不是真实动捕。
开放情况与使用许可
已阅读NVIDIA官方项目页、论文与全部公开附录;页面提供视频、方法与引用,未核得JCA代码/权重或OiV下载许可,暂记论文及展示公开。不可将底座Wan开源视为JCA全系统开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把关节轨迹作为一等输出,连接视频生成与已有rig、蒙皮资产的编辑回放,是比只生成像素更实用的动画方向。
反方 · 哪些结论还不够
假设静态相机,训练偏双足,接触和穿透没有硬约束;交互物体只在视频里动而未恢复成3D。单rig短片、拓扑与现成蒙皮前提限制泛化;不生成UV或PBR,已有材质仍需独立管线。
综合判断
适合作为资产动画草稿和关键帧控制研究,离可直接进入物理交互或机器人执行仍需接触修正与约束。
我会先做的验证
未执行的验证方案:在未见非双足rig上测长片脚滑、骨长、穿模和动作语义;把运动导入原资产并换灯光检查UV/蒙皮拉伸,分别核对静态与移动相机配准误差。