KineWorld:把机器人运动区域变成世界模型的训练权重
同起点受控续训支持局部改善;公开权重尚未对应论文成绩,公开训练目标也未含TAWD
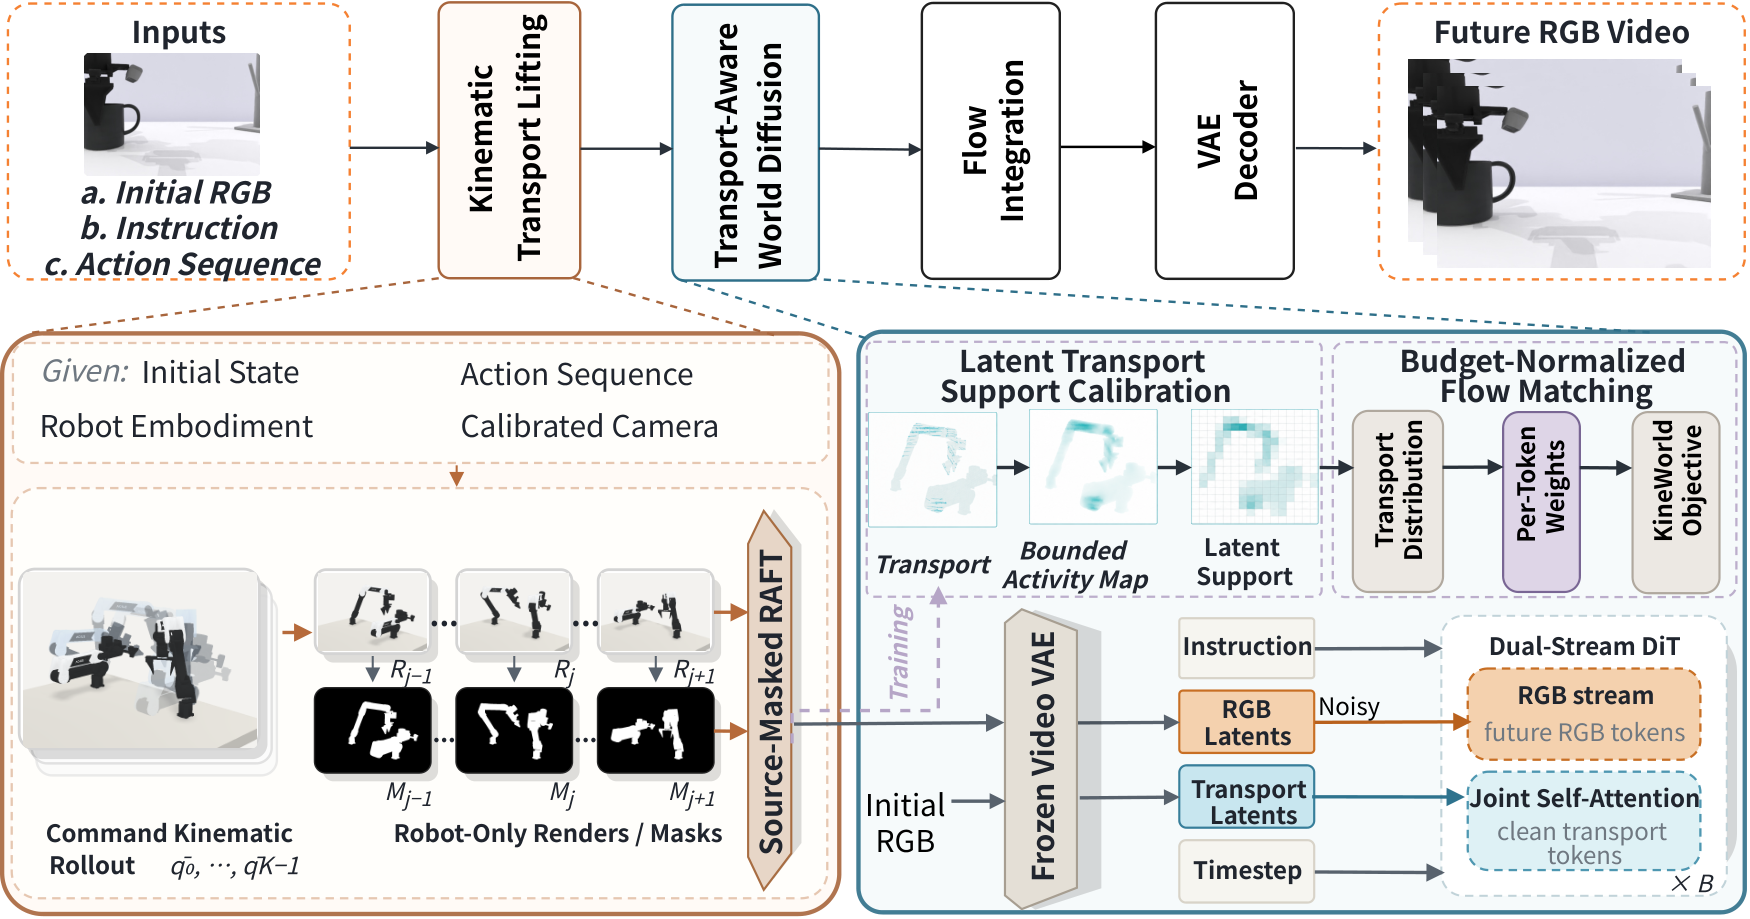
KineWorld把给定动作经机器人渲染转换为图像平面光流,一路作为Wan世界模型的干净条件,另一路分配未来RGB训练损失。它的主要证据应看同一起点、相同数据顺序的50步续训:1000配对事件上EWM提高1.75分,而不是把不同设置的基线到最终模型约20分变化全部归于加权。
图解主要方法
如何把已知机器人动作转换成世界模型应重点学习的位置,同时保持监督权重预算?
- 1
从指令动作获得机器人图像运动
14维双臂末端位姿和夹爪命令经控制器生成机器人状态,在标定相机下只渲染机器人。相邻渲染用RAFT估计光流,源可见掩码限制区域;没有使用未来真实RGB,也没有直接得到物体或接触流。
- 2
编码干净运输条件并与RGB联合建模
方向编码为色相、幅值按25像素归一化,零流为白色。冻结视频VAE分别编码RGB和运输图;首帧RGB与全部运输条件不加噪,只对未来RGB做扩散,双流通过联合自注意力交互。
- 3
将支持投影到潜变量网格
原始光流幅值裁剪并池化到VAE时空网格,首帧权重置零、停止梯度。支持分布按总量归一化;全零时回退均匀,微小错误流仍可能经归一化被放大。
- 4
固定总权重重新分配未来监督
beta=1时,每个token权重为(1+N乘支持概率)/2:一半预算均匀,另一半分给运动区域。均值等于1,但损失大小和梯度范数并未固定;该分支只训练时使用。
- 5
分别审计推理、动作接口与公开实现
视频生成仍需预先获得机器人流;动作头是分离且停止梯度的附加模块,不能将其当作TAWD效果证据。公开训练路径目前明确没有TAWD,应与论文机制分开验证。
实验与证据
全文112701字符及附录A.1–A.10阅读;图2视觉核验,GitHub代码目录/README、HF模型卡与模型和数据文件树核验。
来源证据相同步315检查点继续训练50次,学习率1e-5,无预热,数据顺序、种子、KTL和采样设置相同;只改beta0或1。 表6;A.7 ↗
我的解读这是更接近因果隔离的对照;并非完整从头训练的多种子重复。
来源证据1000配对事件:EWM66.10→67.85,增益1.75,95%区间[1.10,2.37];20000次事件配对bootstrap。 表6;A.7 ↗
我的解读同事件多视角成组重采样,避免帧级伪独立;仍只反映评测集采样误差。
来源证据TA62.80→68.40,INT77.00→81.20;视觉64.80→65.40,增益区间[-0.10,1.20]。 表6 ↗
我的解读运动相关代理更有提升证据;整体视觉改善区间跨零,次指标没有多重检验校正。
来源证据论文单视图总分68.95;多视图54.82,低于BWM65.54与WoVR65.39。 表1–3;A.3 ↗
我的解读不同方法参考档案不是共享RoboTwin实验;单视图领先不能推出多视图或机器人整体领先。
来源证据Clean-50共2500段,1800训练、200验证、500留出;组合训练使用前2000段。 A.2;A.7–8 ↗
我的解读不能把500留出数量当作各表实际评测规模;局部三相机与1000事件集合另有来源和范围。
来源证据KTL消融100事件300视频:三视角真实RAFT相对腕视角白流,PSNR35.35→42.76,运动相关0.9132→0.9953。 表5;A.8 ↗
我的解读固定检查点比较条件质量,检验KTL而非TAWD;不是新机器人训练成功率。
来源证据导出3.02FPS,1000事件230908帧,32worker四节点;含读取、生成、插值、H264,运输条件预计算。 表4;A.6 ↗
我的解读不能与其他论文H100生成速度直接比较,也不包含渲染和RAFT;播放24FPS不是生成24FPS。
来源证据附录前10%token承担36.63%权重来自构造的指数支持分布。 A.4;A.9–10 ↗
我的解读这是机制示例,不是实测训练统计;插值提升或定性例子也不应代替受控收益。
来源证据模型仓库实际有step-500和统计文件,卡片明确没有建立任何该权重的质量或榜单分数。 官方README;HF模型卡 ↗
我的解读文件存在证明开放范围,无法证明复现;公开训练代码均匀目标尤其需要醒目标注。
开放情况与使用许可
GitHub真实含双流、数据准备、推理与训练实现;HF有13.11GB step-500权重、归一化统计和1000视频ZIP。README明确公开训练使用均匀RGB目标而非TAWD,step-500未验证复现论文;视频来源检查点未指明。
LICENSE代码与模型卡标Apache-2.0,Wan、RoboTwin与外部资产独立许可。视频数据卡未明确许可,不能推定Apache覆盖视频。论文原图依arXiv托管许可用于必要方法评论,非开放图片许可声明。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
1000事件配对bootstrap给出TAWD相对均匀权重EWM增益1.75分、区间[1.10,2.37],控制比跨论文榜单更有说服力。
权重分支只在训练使用,归一化后均值为1;方法贡献与增加推理参数可分开。
公开材料主动区分视频展示、公开检查点、研究设置和评测,允许读者审计复现缺口。
反方 · 哪些结论还不够
配对bootstrap反映固定两个模型的评测采样不确定性,不是多训练随机种子的稳健性。
TA和INT分别含视觉轨迹代理及模型裁判,不能解释为关节控制误差或真实接触成功率。
公开源代码不含核心TAWD目标,权重也未对应论文结果,尚不能凭下载成功宣称完整复现。
综合判断
监督分配机制与小幅受控收益值得关注;跨论文榜单、展示视频和公开权重必须分别理解。它尚未证明闭环机器人控制、物体物理或端到端实时性。
我会先做的验证
建议实验(尚未执行):公开TAWD实现与确切检查点,重复多个训练种子,并在未见任务和物体上做闭环控制;计入机器人渲染、RAFT与编码的总延迟,分别测零运动、遮挡和接触区域。