Know Then Draw:先学语义,再用扩散把它画出来
离散视觉知识与像素渲染分阶段训练,收益到底来自哪里?
先自回归学习离散语义token,再冻结主干训练像素扩散模块。约400M的受控比较支持语义表示优于纯重建表示;最终3B模型的高分包含提示改写与固定种子下的变体选择,不能只看GPU小时宣称通用成本优势。
图解主要方法
离散视觉知识与像素渲染分阶段训练,收益到底来自哪里?
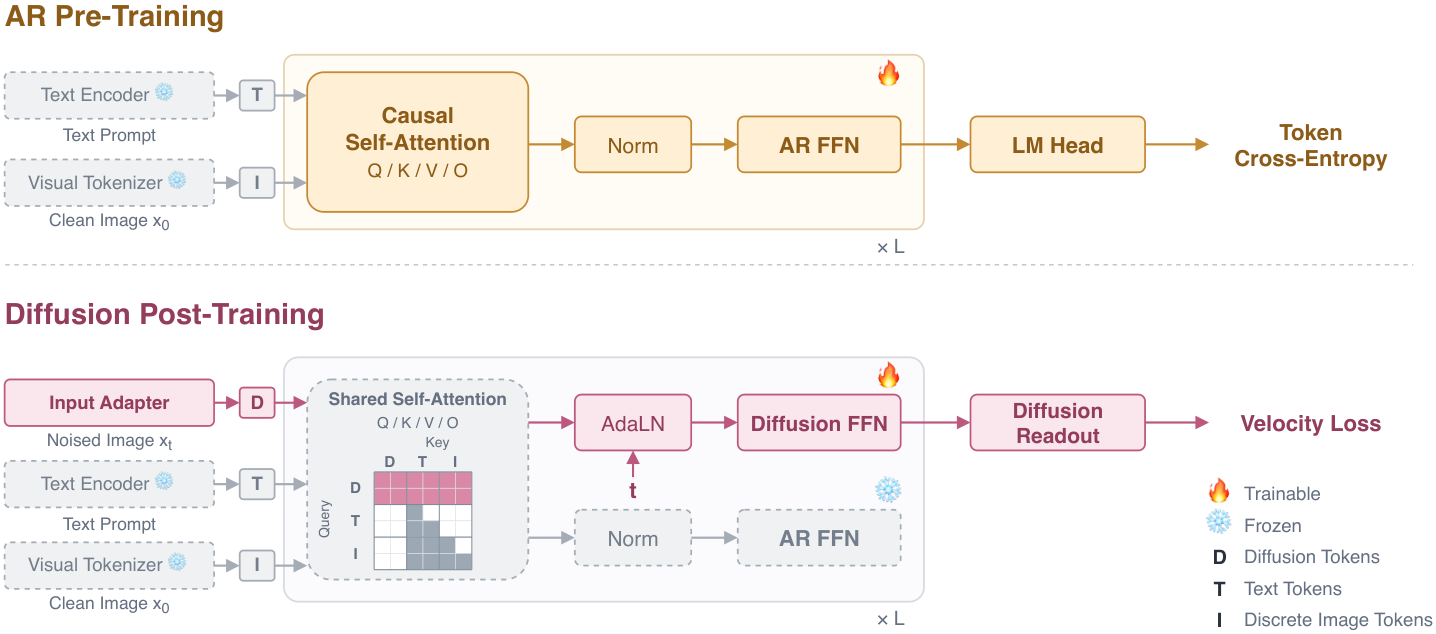
- 1
图2上层:先预测视觉语义
冻结视觉tokenizer与文本编码器,RandAR以随机位置顺序预测离散视觉token。Semantic-Recon在Qwen2.5-VL特征上用IBQ加重建学习;Semantic-LM只用冻结语言模型的语言监督训练码本,没有图像解码器。没有重建器不等于不能作为后续生成的语义条件。
- 2
图2下层:保留知识,添加像素渲染模块
AR预训练后冻结其参数,加入扩散token、前馈模块、调制和读出,复用注意力投影,让像素流匹配从语义条件中生成图像。训练条件来自真图token,推理条件由AR预测;两者误差分布不同,不能忽略语义生成错误对渲染的传播。
- 3
通过匹配对照隔离表示作用
直接像素模型与两阶段模型最终都约400M,两阶段约250M主干加150M渲染模块;匹配累计图像呈现、数据顺序和总更新。三个tokenizer版本共享生成器和训练流程,但外部冻结编码器及tokenizer预训练不包含在生成器容量/预算内。
- 4
扩展预算规律与最终采样分开
作者分别扫AR与渲染规模,用6ND代理拟合阶段预算,给出约60:40分配。代理不计后训练时冻结AR的前向开销;最终3B用约6600 H100小时、50步Euler采样,GenEval与DPG还使用LLM提示改写,并在固定种子下按评测分数选提示变体。
实验与证据
已阅读全文正文及附录A.1–3配置、A.8预算结论与A.9最终评测,核对实验条件与原图;未独立复现。
来源证据受控AR→PDM的GenEval65.51、DPG71.11,对直接PDM61.16/62.56;纯重建tokenizer虽rFID1.04,最终GenEval54.67,Semantic-Recon65.51、Semantic-LM64.84。 正文表1、2与附录A.1–2 ↗
我的解读我的解读:重建好不等于生成条件好,语义监督值得投入;Semantic-LM并未超过Semantic-Recon,不能宣称彻底舍弃重建必然更优。
来源证据最终模型GenEval .86、DPG87.78,约6600 H100小时;阶段时间3960/2640是名义分配,不是分别测得的运行时。GenEval553提示单图、DPG1065提示四图,提示变体依据固定种子评测分数选择。 规模研究与附录A.9 ↗
我的解读我的解读:高分有评测选择因素,跨系统“少数GPU小时”的比较还排除了部分外部预训练,不能当严格同成本优胜。
开放情况与使用许可
论文公开,本次未核实对应完整生成代码与最终3B权重。原图论文CC BY 4.0不代表模型或训练数据已开放,外部编码器另遵各自许可。
LICENSE论文及原图 CC BY 4.0;代码与权重许可另列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:语义组织与纹理细节分阶段学习,给视觉资产概念设计提供有价值的算力分配思路,且有匹配规模与图像曝光的控制证据。
反方 · 哪些结论还不够
最终评测存在提示选择与外部预训练成本口径,推理使用预测token而训练使用真值token也留下偏移。输出仅二维图像,没有网格、UV、可编辑部件、PBR分解或跨视角保证。
综合判断
适合关注文生图训练机制及概念图流程;不应当作已解决3D资产制作或通用最优60:40训练配方。
我会先做的验证
未执行的验证方案:使用事先冻结的提示与种子,匹配全部编码器/tokenizer开销,比较纯重建、语义重建和语言语义三种路线;另用同一资产多视角与材质描述测一致性,明确这只是概念图评测而非网格质量。