L3G-World:把可更新的3D高斯记忆直接交给视频生成器
重访场景时如何少漂移,9FPS又对应什么硬件和质量代价?
在持久3D高斯中同时保存几何与VAE特征,按可见区域修正旧记忆、在缺失区域新增,再直接渲染扩散条件。快速版H100端到端9.02FPS,静态场景重访更一致;“无限世界”仍需随探索范围增长的存储。
图解主要方法
重访场景时如何少漂移,9FPS又对应什么硬件和质量代价?
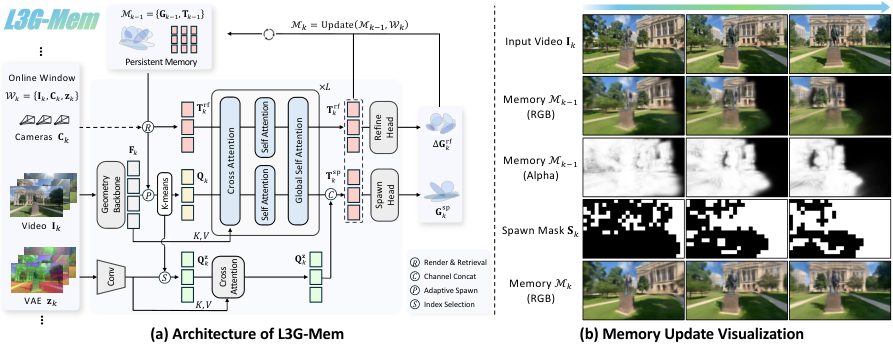
- 1
图2左:区分新增与修正
当前图像、相机和VAE潜变量进入几何主干。以渲染不透明度低或RGB误差高的位置生成spawn掩码,K-means选查询;旧高斯按深度与贡献度检索可见部分,进入refinement流。未检索到的旧记忆保留,避免每帧重新堆一份场景。
- 2
图2中:联合注意力与门控残差
新增查询与旧记忆分别跨注意力吸收几何,再经全局注意力交流;每token解码32个高斯。旧中心、尺度、旋转、颜色与不透明度作门控残差更新,VAE特征另用独立门。训练用五个连续块,监督当前记忆重现此前视图,压低遗忘。
- 3
图2右:直接渲染潜在条件
每个高斯携带16维VAE特征,用相同几何与混合方式渲染目标视角潜变量,省去先渲染RGB再VAE编码。特征光栅化时几何梯度停止,特征损失不会直接推动高斯中心;这里是生成条件缓存,不是已导出的UV网格或PBR材质。
- 4
视频生成与快速蒸馏形成闭环
Cosmos-Predict2.5-2B加入LoRA、相机条件和记忆条件,检索最多三个近姿态历史潜帧。教师35步生成81帧块;Fast学生先flow-map再on-policy蒸馏,每次三个潜帧、四步无CFG,生成历史周期性回写记忆。回写也可能固化生成错误。
实验与证据
已阅读全文正文及附录A蒸馏、B实现评测、E局限,核对实验条件与原图;未独立复现。
来源证据DL3DV和RealEstate10K中相机沿原路返回,比较同姿态生成帧;标准版RE10K PSNR18.36、LPIPS .269,DL3DV PSNR16.00、LPIPS .366。A100记忆约25K/33K高斯、8.91/11.88MiB。 481帧往返重访评测 ↗
我的解读我的解读:这验证自一致性,不验证场景真实存在或物理动力学;基线有单图初始化及动作映射改造,应按本文协议比较。
来源证据H100、480×832、400帧Fast端到端9.02FPS、7.4GiB;表2A100上千FPS是潜在条件渲染而非视频生成。Fast的RE10K PSNR16.19低于18.36,FID49.94高于36.09。 速度与质量取舍 ↗
我的解读我的解读:必须同时保留硬件、阶段和质量代价,不能将约千FPS渲染当成千FPS世界生成,也不能说加速无损。
开放情况与使用许可
官方cvlab-kaist/L3G-World仓库仅说明、图片与许可文件;四项代码/检查点发布计划均未勾选。声明的原创代码MIT不代表实现已可用;未来L3G-Mem权重受CC BY-NC、生成权重受NVIDIA条款,需分别核实,不能统称全套MIT。
LICENSE论文及原图 CC BY 4.0;代码与权重许可另列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:让空间记忆存储扩散真正需要的潜特征,减少接口转换;可见区域残差修正比重复累加更适合长时重访。
反方 · 哪些结论还不够
仅静态场景,未证明动态物体或物理交互;存储随探索空间增长,所谓无限不是内存有界。深度基础模型、相机输入和生成反馈都会影响几何可信度。
综合判断
可作为相机可控场景漫游研究方向;当前仓库还未发布实现或权重,不宜当即用的实时世界引擎。
我会先做的验证
未执行的验证方案:在相同相机轨迹上加入移动物体、光照切换与反复闭环,记录内存随面积增长、错误固化率及重访PSNR;分别移除refinement和直接潜渲染,测端到端延迟而不只测光栅化。