LaLa World:用语言串起动作和潜在状态预测
把动作说成文字,能否统一不同机器人的世界模型?
语言化数值动作与视觉变化,结合冻结视觉编码器和语言骨干预测潜在未来。跨域规划与策略实验积极,但仍依赖数值动作、不同编码器选择及限定对照。
图解主要方法
把动作说成文字,能否统一不同机器人的世界模型?
- 1
将动作和变化语言化
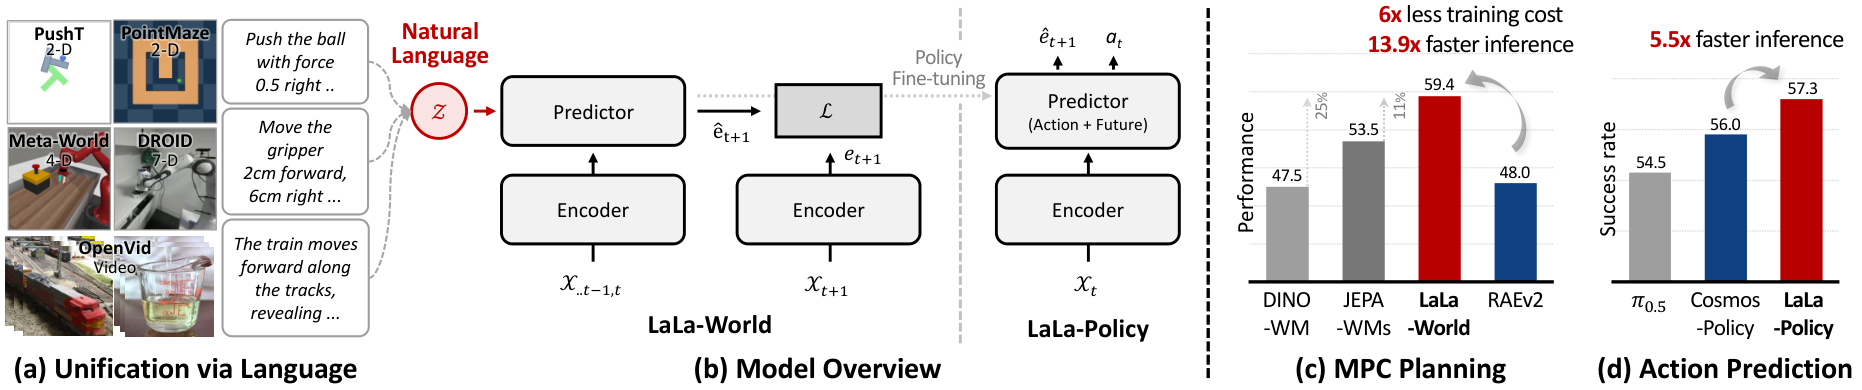
图1把动作数值及视觉变化描述送入共享Qwen3.5-0.8B预测器,冻结DINOv2/v3编码器提取状态;MLP对齐、三维位置编码和学习的patch查询预测下一潜在状态。世界模型不输入本体感觉。
- 2
在潜在空间训练预测
使用MSE而非像素视频生成损失;像素解码器主要服务可视化。七类控制数据加OpenVid、OmniEdit和ShareGPT等约6.5M数据,每epoch采1M、20epoch、8张H100、batch512。
- 3
语言接口下仍进行数值规划
CEM搜索数值动作,再语言化送入模型,规划视野不超过6步。五个子步动作按分量求和,执行时重复其平均值,因而丢掉子步内部变化;语言接口并没有去掉数值控制。
- 4
再训练独立策略头
策略实验使用SigLIP2、冻结Qwen骨干及16层DiT/GR00T动作头,且输入本体感觉;未来预测并不参与每次动作选择。这个策略管线不应与无本体感觉的世界模型规划混为一谈。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据主要五个仿真任务平均64.6→72.1,另一组44.8→50.5。DROID仅64段轨迹、3步离线动作评分,采用800×(0.1−误差)且上限80的公式。 规划范围与统计单位 ↗
我的解读DROID分数不是机器人成功率;汇总还按领域选择较优视觉编码器,单DINOv3平均53.7,报告组合61.3,双编码器63,并非一个统一编码器达到所有成绩。
来源证据匹配RAEv2约0.8B、相同DINOv3和数据的对照中,2小时达到对方12小时水平;5步预测快13.9倍、1步快2.9倍。PushT去掉动作数值仅保留定性词后81.2降到4.2。 效率与动作语义 ↗
我的解读效率结论属于该匹配设置,不是所有视频世界模型;动作数值仍至关重要,语言并没有自动解决精确控制。
来源证据LIBERO97.7对适配Cosmos97.3;RoboCasa50示范57.3对56,300示范66.4;轨迹推理2.12对11.71秒约5.5倍。对照Cosmos省略未来本体感觉值。 策略实验 ↗
我的解读主要仍为仿真,没有实机完成率;适配基线和数据量变化须与架构收益分开。
来源证据附录语言规划使用8–96次rollout,对照4500–54000次,但不是每项都更好,也未完整计入LLM调用成本。已比对10月21日v2与v1,正文方法和结果无实质变更。 附录与修订核对 ↗
我的解读较少rollout不是总算力必然更低;本期仅收录一次,不用无实质变化的版本重复计数。
开放情况与使用许可
junha1125/LaLa-World目前公开环境、数据准备和辅助脚本;训练评估核心、解码器及权重仍标待发布,统一许可证也待补。不能称完整系统已经开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
潜在预测配合自然语言动作接口,有望降低跨数据集动作表示适配成本,且提供较充分的匹配对照。
反方 · 哪些结论还不够
模型选择、数据混合与数值动作依赖显著;离线DROID指标和仿真策略不能外推为真实机器人泛化。
综合判断
支持继续研究语言作为跨域接口,尚不支持语言已替代精确动作表示的说法。
我会先做的验证
未执行的验证方案:固定单一视觉编码器与总训练数据,比较数值、语言数值和纯定性动作;在真实机器人记录闭环成功、规划调用成本及聚合子步造成的误差。