latent-SR:用可重放的稀疏修改学习长时文本世界预测
一次生成多步状态增量,程序保留不变事实,再监督中间结果
latent-SR先把历史编码成文本状态,再一次生成未来每步行动对应的稀疏修改,由程序重放得到各步状态。训练既奖励末端预测,也检查中间状态,并比较状态路径是否比直接使用历史更有用。它减少跨调用递归回灌的误差,但仍在自回归生成token,不能理解为消除了所有错误传播。
图解主要方法
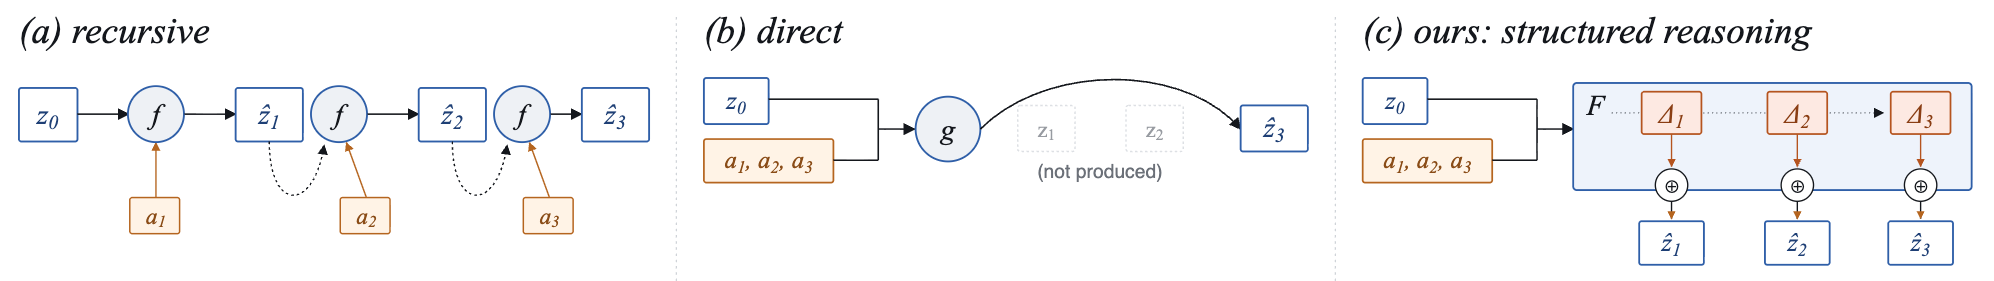
图1(c)如何保留中间轨迹,又避免跨调用回灌预测状态?
- 1
把历史压成面向未来的文本状态
图1的z0由编码器从已有交互生成,不要求还原不可见真实状态,只需保留影响未来观察的区别。ScienceWorld和CEO用平面JSON,Jericho允许嵌套结构;状态可以包含推断,但不能把这些推断当已观察事实。
- 2
一次生成行动对齐的稀疏修改
图1(c)将初态和完整动作序列输入一次transition调用,输出Δ1到Δk。程序按顺序合并set/remove等修改,不变字段直接继承;中间状态不再送进新的transition调用。token仍顺序生成,前面错误增量也可能影响后面输出,所以“非递归”只限定调用结构。
- 3
先蒸馏,再按预测结果训练
GPT-5.2生成候选编码—修改—解码轨迹,按末端质量和格式筛选,去除自由文字推理。Qwen3-4B随后用GRPO训练采样树,将后代平均奖励分配给编码、转移和解码节点;文本状态本身没有人工真值。
- 4
用终点、相对增益和中间预测共同评分
奖励包含末端质量、相对冻结历史预测器的正向增益及各中间重建状态的预测质量。增益取max(0,差值),不如基线时这一项为零而非负罚。CEO直接从重放状态读四个数值,无独立解码调用;其他环境再解码成观察。
实验与证据
已阅读v1正文、附录A–G和全部表格及提示格式,核对图1。实验为作者报告,本站未复现;发现部分文字与表格口径不一致,见证据解读。
来源证据【长时比较】相同Qwen3-4B骨干:ScienceWorld第10步Fact-F1为89.38,对raw-history direct为79.62;CEO第10步SE为81.73对74.81。Jericho第10步MAE为1.642,对direct为2.311、recursive为1.870。 表1–3 ↗
我的解读我的解读:前两项相对提升约12.3%和9.3%。Jericho“近30%误差减少”只相对direct成立,相对该时域更好的recursive约12.2%;短时Jericho仍是recursive更好。
来源证据【训练消融】CEO均值:蒸馏83.49、无蒸馏直接GRPO61.12、蒸馏+GRPO84.86、加增益86.58、加中间奖励87.35;同增益奖励的latent-direct为83.53。 表4、附录C/D ↗
我的解读我的解读:结构、蒸馏和过程奖励均有作用,不能将完整模型与直接模型的全部差距归因于某一个模块。8张A100/H100训练也不是零成本提示技巧。
来源证据【动作反事实】独立60个模拟公司,每个分出三条10周动作路径;公司聚类调整margin为+0.024,两种检验p<0.001。模型内动作置换平均差+0.0056,置换p=0.0012。 第5.5节、附录E.3 ↗
我的解读我的解读:有统计显著性,但效果量和零值并列应同时看。部分基线的中位数置换统计退化,不能只引用有利的显著性;模拟商业结果也不是现实财务预测证据。
来源证据【证据边界】CEO只评分现金、个人订阅、企业席位及未结问题,小于100的真值用100作误差分母。附录称案例三分支首周行动相同,但表14首周真值现金已不同;Jericho解码描述又提到历史风格上下文。 附录B.3、E.3表14、F.3/G ↗
我的解读我的解读:高分不保证小数值字段精确,亦不保证未评分流量正确。案例条件及“只经状态读取历史”的实际边界需要源码/日志澄清,不以该案例证明内部因果机制。
开放情况与使用许可
论文给出数据构造、提示格式、超参数和计算设备。当前论文页未链接项目代码或权重,定向检索未找到可确认的作者实现;不将环境公开或伪代码等同于完整开源。
LICENSE论文及图1标注CC BY 4.0,保留作者、论文链接与许可;未核实实现和模型权重的发布许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
在同骨干和训练阶段下比较递归与非递归,并用同奖励版本隔离结构影响;另有伪造状态扰动与动作置换检验,超出只比较末端平均分。
反方 · 哪些结论还不够
反事实显著性依赖60个模拟公司和特定指标;零值并列使部分中位数置换检验退化。代码未核实,正文与附录还有解码输入和案例首周条件的口径差异。
综合判断
对可编辑文本状态的有力结构实验,长期预测改善值得复核;目前不是通用世界模拟或闭环规划有效性的证明。
我会先做的验证
未执行的验证方案:在同预算和相同训练样本下复现稀疏编辑、完整状态及直接预测,保存每步错误;固定历史输入边界,对动作序列置换,并按公司聚类报告均值和置信区间。最后将模型接入规划器检验真实任务收益。