Latent World Model:为导航预测目标兼容度
不生成未来像素,但反事实标签仍依赖几何近似
该方法用当前画面和候选动作预测与目标画面的兼容度,再据此为无动作标签视频选择伪标签、强化导航策略。它把世界模型从画面重建转向决策评分,但训练世界模型本身仍需要带动作和位置信息的轨迹。
图解主要方法
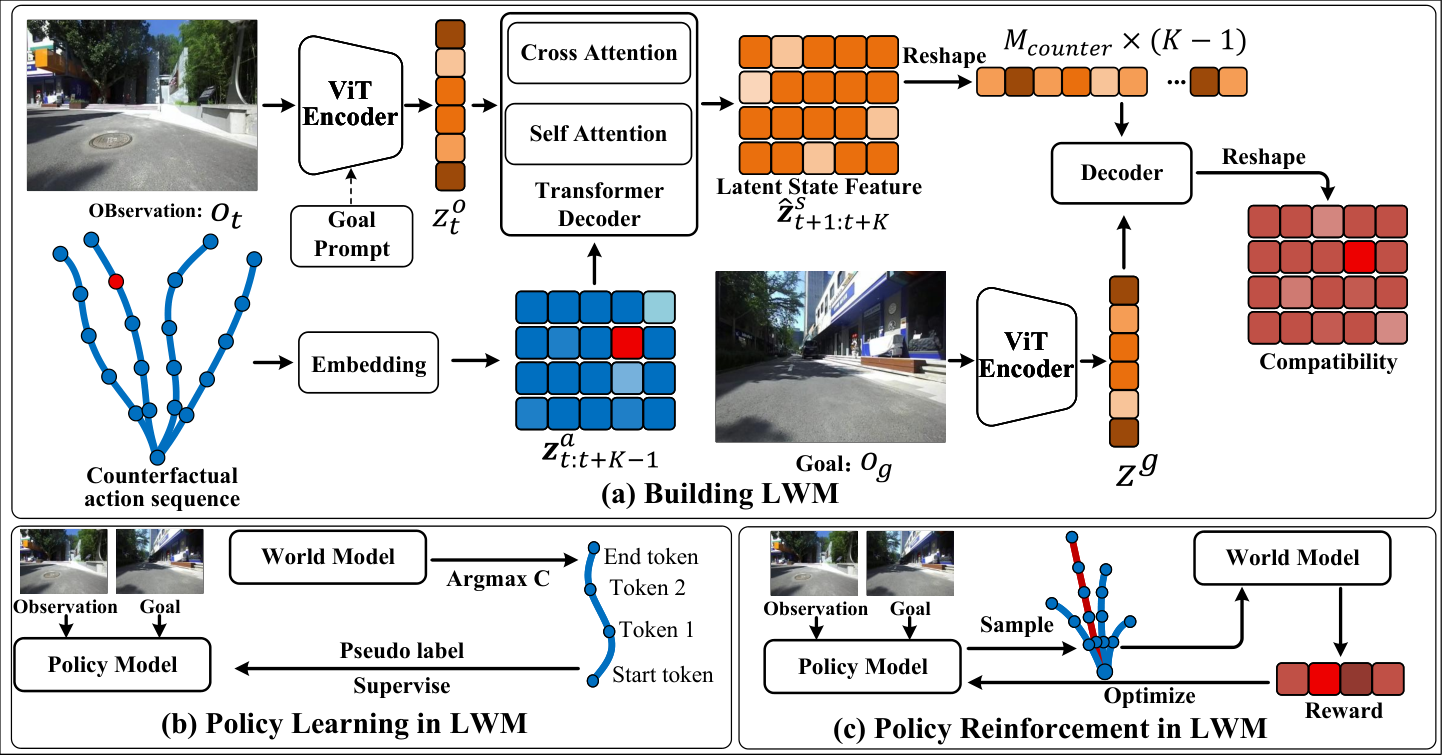
图 1 的世界模型、伪标签策略和强化学习阶段分别用了什么监督?
- 1
从动作条件特征转向兼容度
图1a视觉编码当前观察,因果Transformer读候选动作并预测潜状态,另一个解码器与目标图特征比较。最佳LWM-B-P在编码开始就看到目标图,因此是目标条件规划器;它不等于不看目标的通用动力学模型。
- 2
用跨轨迹动作构造近似反事实标签
从其他轨迹借动作序列,按其几何终点与目标位置的欧氏距离取负对数,监督兼容度。这里没有实际执行这些替代动作;靠近目标不必然代表能绕过墙、可通行或不会碰撞,物理反事实正确性不能由距离标签保证。
- 3
让世界模型为策略视频选择伪动作
图1b先聚类得到64条候选轨迹,评分选最佳,训练自回归策略输出64类动作增量token。无标签指这个后续策略阶段,不能抹去世界模型训练中的里程计、动作和轨迹簇来源。
- 4
在固定世界模型内进一步优化
图1c策略采样新组合,用兼容度当奖励、组归一化与KL约束做GRPO式训练。推理代码采用距离越小越好的评分约定,须与论文兼容度方向区分;模型内优化也可能利用评分盲点,需要真实闭环验证。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【离线比较】RECON、SCAND和自采数据上测候选终点误差及ACC3/ACC5;目标条件LWM-B-P的自采PE1.122、ACC5为83.80%。 主表 1 与第 3.2.3 节 ↗
我的解读我的解读:是给定候选的选择能力,不是任意环境通行保证;目标提前编码和骨干大小应与无目标条件版本分开。
来源证据【真实导航】六个场景中报告成功率66.7%,BC与NoMaD各33.3%;到目标0.5m内算成功,LPIPS仅在成功时统计。 表 3 与第 4.4 节 ↗
我的解读我的解读:场景与重复规模有限,缺少充分不确定性信息;成功条件下的视觉误差不能覆盖失败或碰撞风险。
来源证据【消融与文档不一致】增加跨轨迹候选总体有益但并非单调;附录部分消融配置与主表难以直接对应,架构维度描述也存在可疑处。 附录 A/B、公开推理实现 ↗
我的解读我的解读:实现提供了核查入口,但不能把不同表的数值拼成一条确定增益曲线;没有全量训练流程就不能宣称已完整复现。
开放情况与使用许可
官方LWM仓库包含推理、世界模型、策略和tokenizer,HF实际存在world_model.pt与ar_plus.pt;不是完整训练代码发布。
LICENSEREADME指出CroCo组件CC BY-NC-SA 4.0、检查点仅研究/非商业使用;主仓库未见独立整体LICENSE。论文及图1为CC BY 4.0,不替代模型许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把计算用于动作候选的目标关系,避免在不必要的像素细节上反复去噪,并支持离线策略改进。
反方 · 哪些结论还不够
空间近与可达性可能脱节;世界模型不是从纯无标签视频凭空学会动作,几何伪标签和奖励漏洞限制反事实主张。
综合判断
适合目标图导航的候选评分研究;接入真实系统前,需要显式检查碰撞、遮挡与地图拓扑分歧。
我会先做的验证
未执行的验证方案:在外观近但隔墙、外观异但相邻的成对场景上比较兼容度与实际可达性;固定候选集、目标输入和编码器,报告碰撞、到达率、校准、RL前后奖励投机及全部试次距离。