LAW:让规划、进度判断与世界动作模型协作
长任务的收益来自哪些模块,哪些只是小幅增量?
LAW 让视觉语言模型承担计划、状态监测与价值估计,再与世界动作模型共同完成长任务。其关键不只是生成未来,而是异步子任务状态、候选动作选择与历史记忆的配合;复杂开放基准中的绝对成功率仍很低。
图解主要方法
长任务的收益来自哪些模块,哪些只是小幅增量?
- 1
拆开计划、状态与价值职责
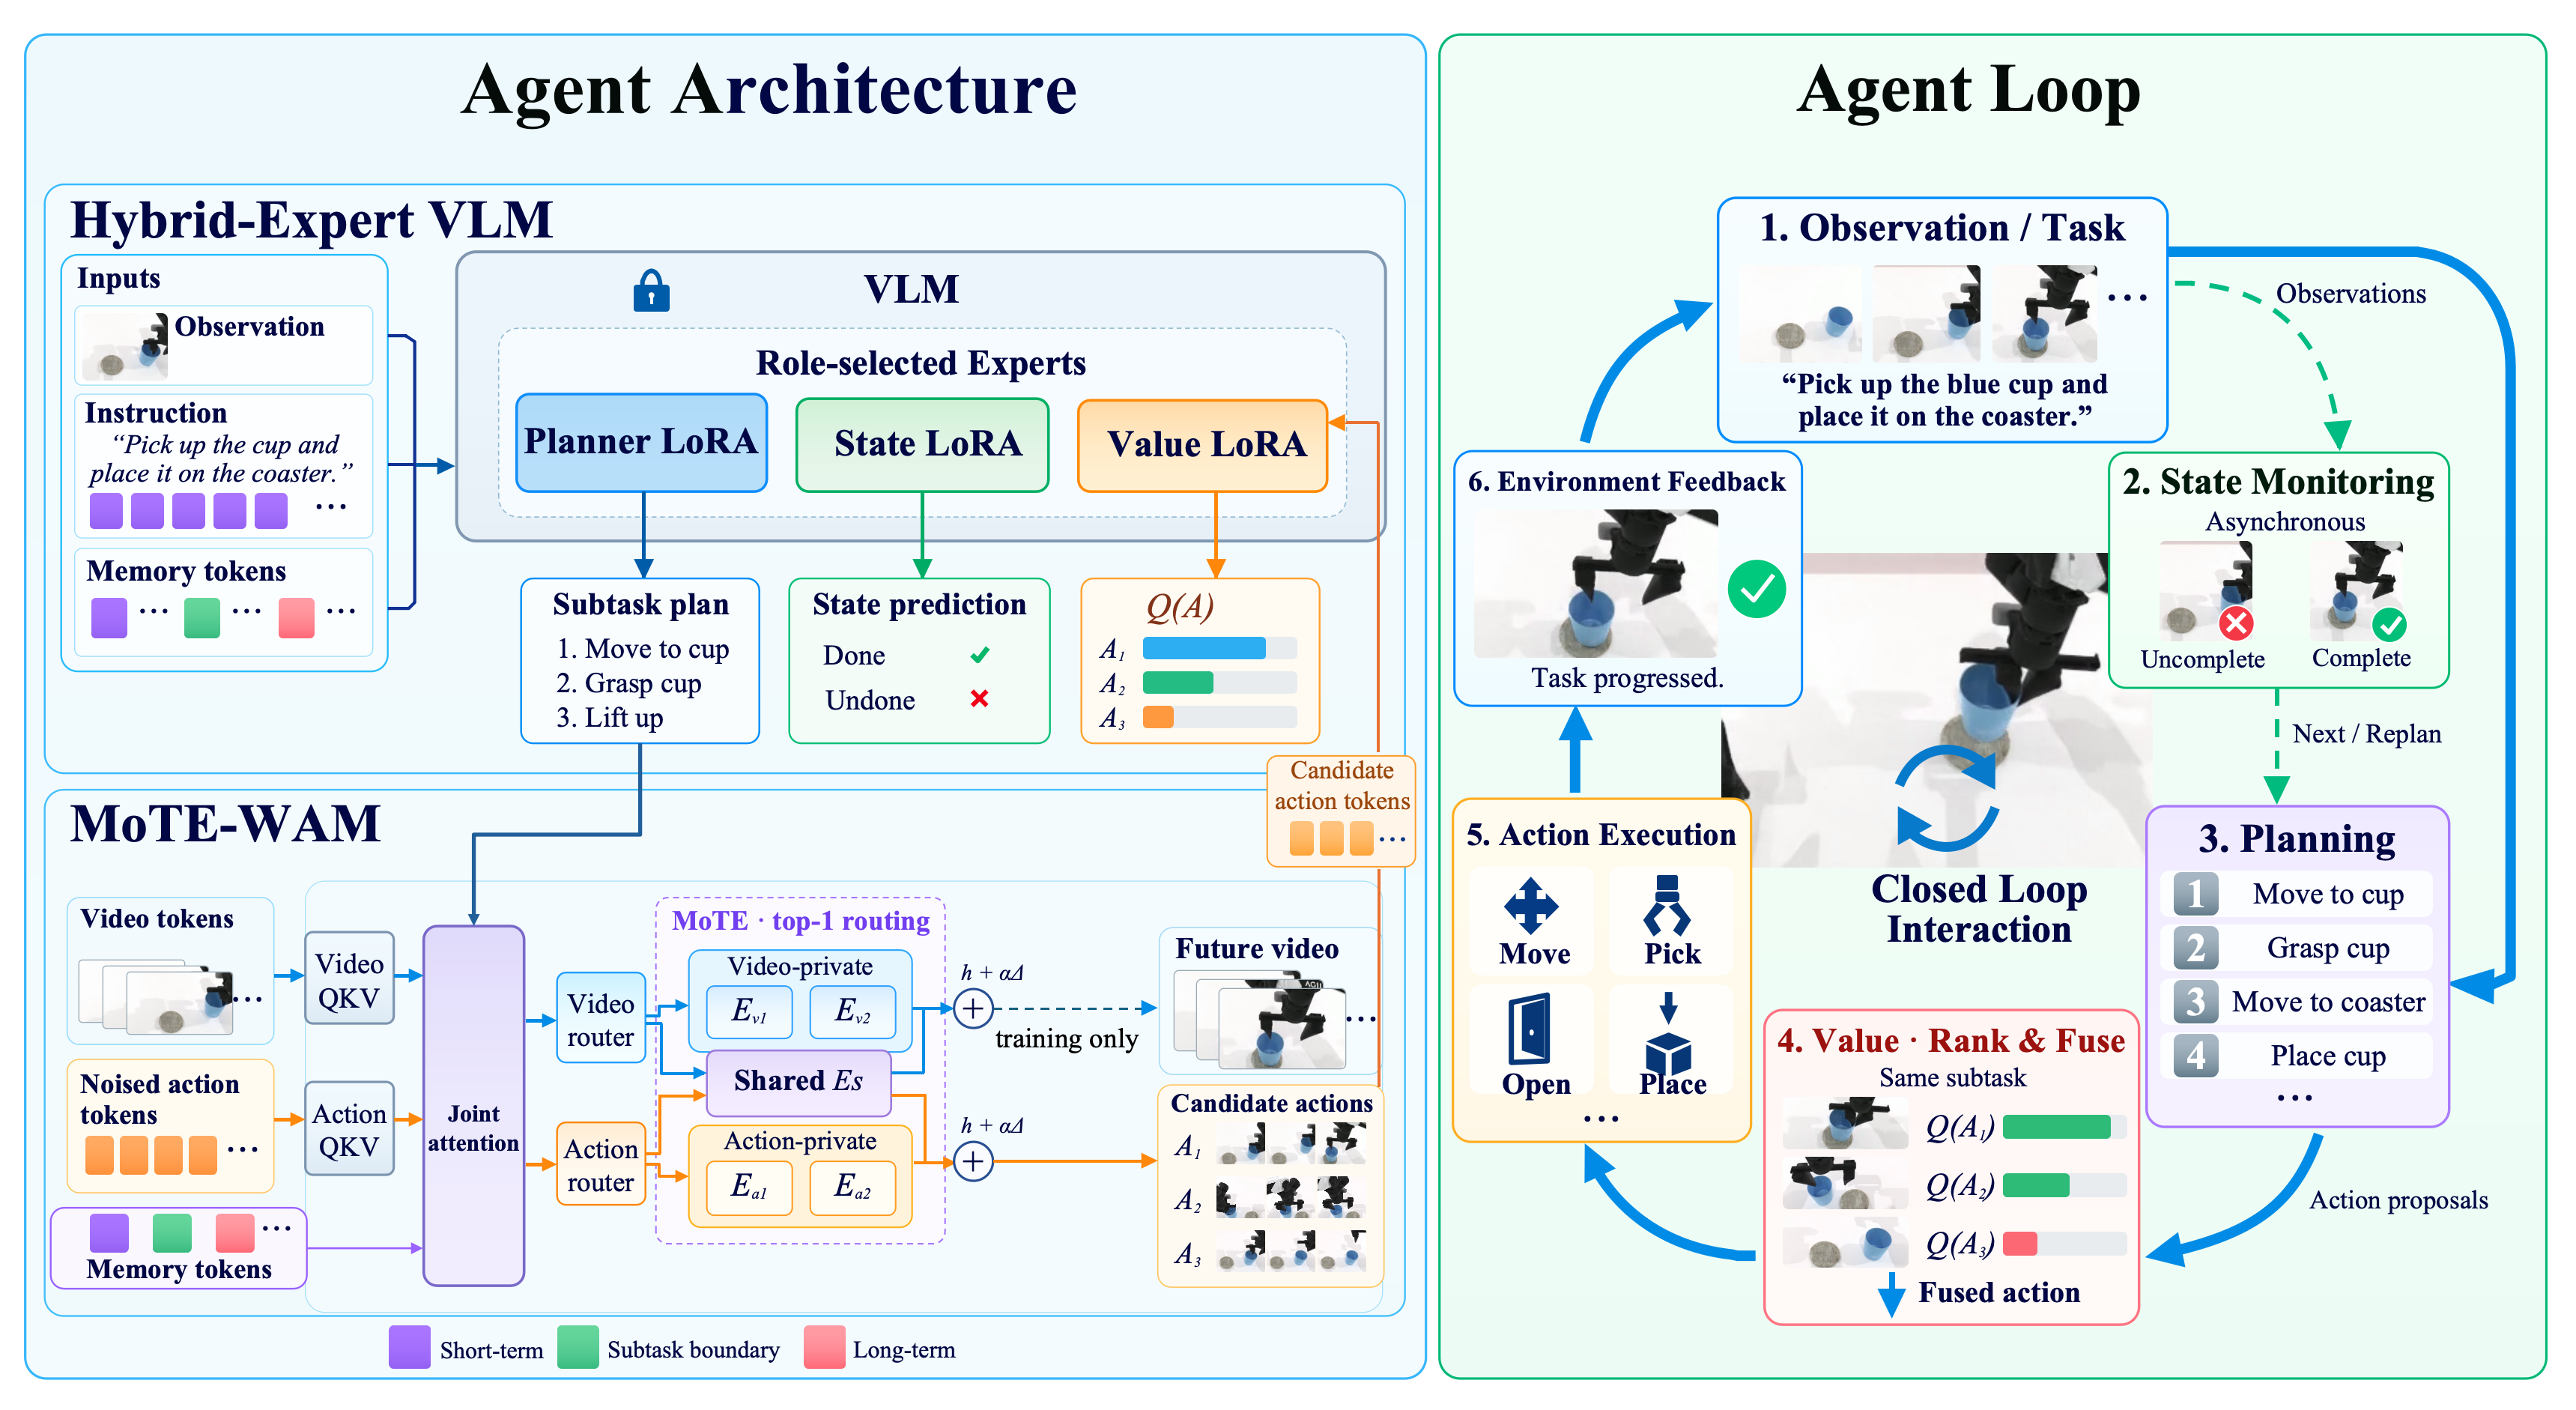
图2的冻结 Qwen3-VL-2B 通过不同角色适配器生成剩余子任务、判断进度和估计价值。状态监测异步运行,按时间戳和子任务实例丢弃过期结果,降低旧完成信号错误推进新任务的风险。
- 2
在动作模型中共享有限的世界表征
基于 Wan 的世界动作模型用稀疏专家区分模态私有与共享计算,视频训练信号帮助动作建模;实际推理不必每次显式生成未来视频。局部记忆保存近期状态,全局记忆压缩更早的子任务边界。
- 3
以价值筛选候选后执行前缀
生成32条动作候选,选出价值最高的8条加权融合,姿态使用适合旋转的平均,再执行前缀并重新观测。价值训练按子任务截断并使用已录制轨迹,因此面对新生成候选仍存在分布外误差。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据50项任务,标准与随机条件数据训练后平均94.21%,对照 FastWAM 91.83%;关闭价值模块的对应分数93.80%,加入价值只增加0.41个百分点。 RoboTwin与模块增量 ↗
我的解读整体系统有收益,但不能把全部提升归于价值选择,也不能把不同模块或另批消融的任务数字直接拼接。
来源证据RoboDojo 35任务、3个种子,平均得分6.47,成功率仅3.82%,并未超过所有方法;真实3项任务各20次、共60次,成功39次即65%,训练使用900条轨迹、每项300条。 开放基准与真实任务 ↗
我的解读真实长任务有积极证据,复杂基准仍离可靠执行很远;65%的真实成功不等于35项开放任务的65%。
来源证据语义计划、状态与价值由不同角色承担,状态耗时约60ms且需处理异步失效;训练依赖人工核验标注及大规模GPU资源。价值学习的失败轨迹可保留成功前缀,但候选动作并非同分布录制数据。 训练和闭环边界 ↗
我的解读系统工程与数据是重要成本;进度阈值不是物理成功证明,多个可行轨迹平均也可能产生不可行中间动作。
开放情况与使用许可
GitHub 已有实际代码,根许可 MIT;官方说明作者发布的权重采用 Apache-2.0、标注采用 CC BY 4.0,第三方组件保留各自许可。核验到 LAW-FastWAM 检查点及 LAW-VLM-FastWAM 适配器文件与模型卡。论文及原图为 CC BY-NC-SA 4.0,与代码许可不同。
LICENSECC BY-NC-SA 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
分工、异步状态防护和双层记忆使长任务控制过程更清晰,便于定位失败来自计划、状态切换还是低层执行。
反方 · 哪些结论还不够
全系统比较包含数据与工程差异;开放基准绝对成功率低,候选价值存在分布偏差,动作融合可能破坏几何可行性。模型较小也不代表通用推理全面超过大模型。
综合判断
可作为长任务世界动作系统的组合设计参考,当前证据不足以支持通用长时自主操作已经成熟。
我会先做的验证
未执行的验证方案:在子任务边界注入延迟和错误完成信号,测试多峰动作候选融合是否碰撞;使用未见任务和硬件,分别报告规划、监测、价值选择的增量收益及全部失败。