LEAP:在潜在规划中补上可读的终点约束
回顾补收:动作梯度、数值目标与总计算预算
LEAP 在冻结 LeWM 的可微 rollout 上优化动作,同时让预测特征接近目标图像,并通过训练好的读出器接近数值目标状态。收益来自规划配方与终点约束的组合,额外状态监督、动作提案训练和线搜索成本都不可忽略。
图解主要方法
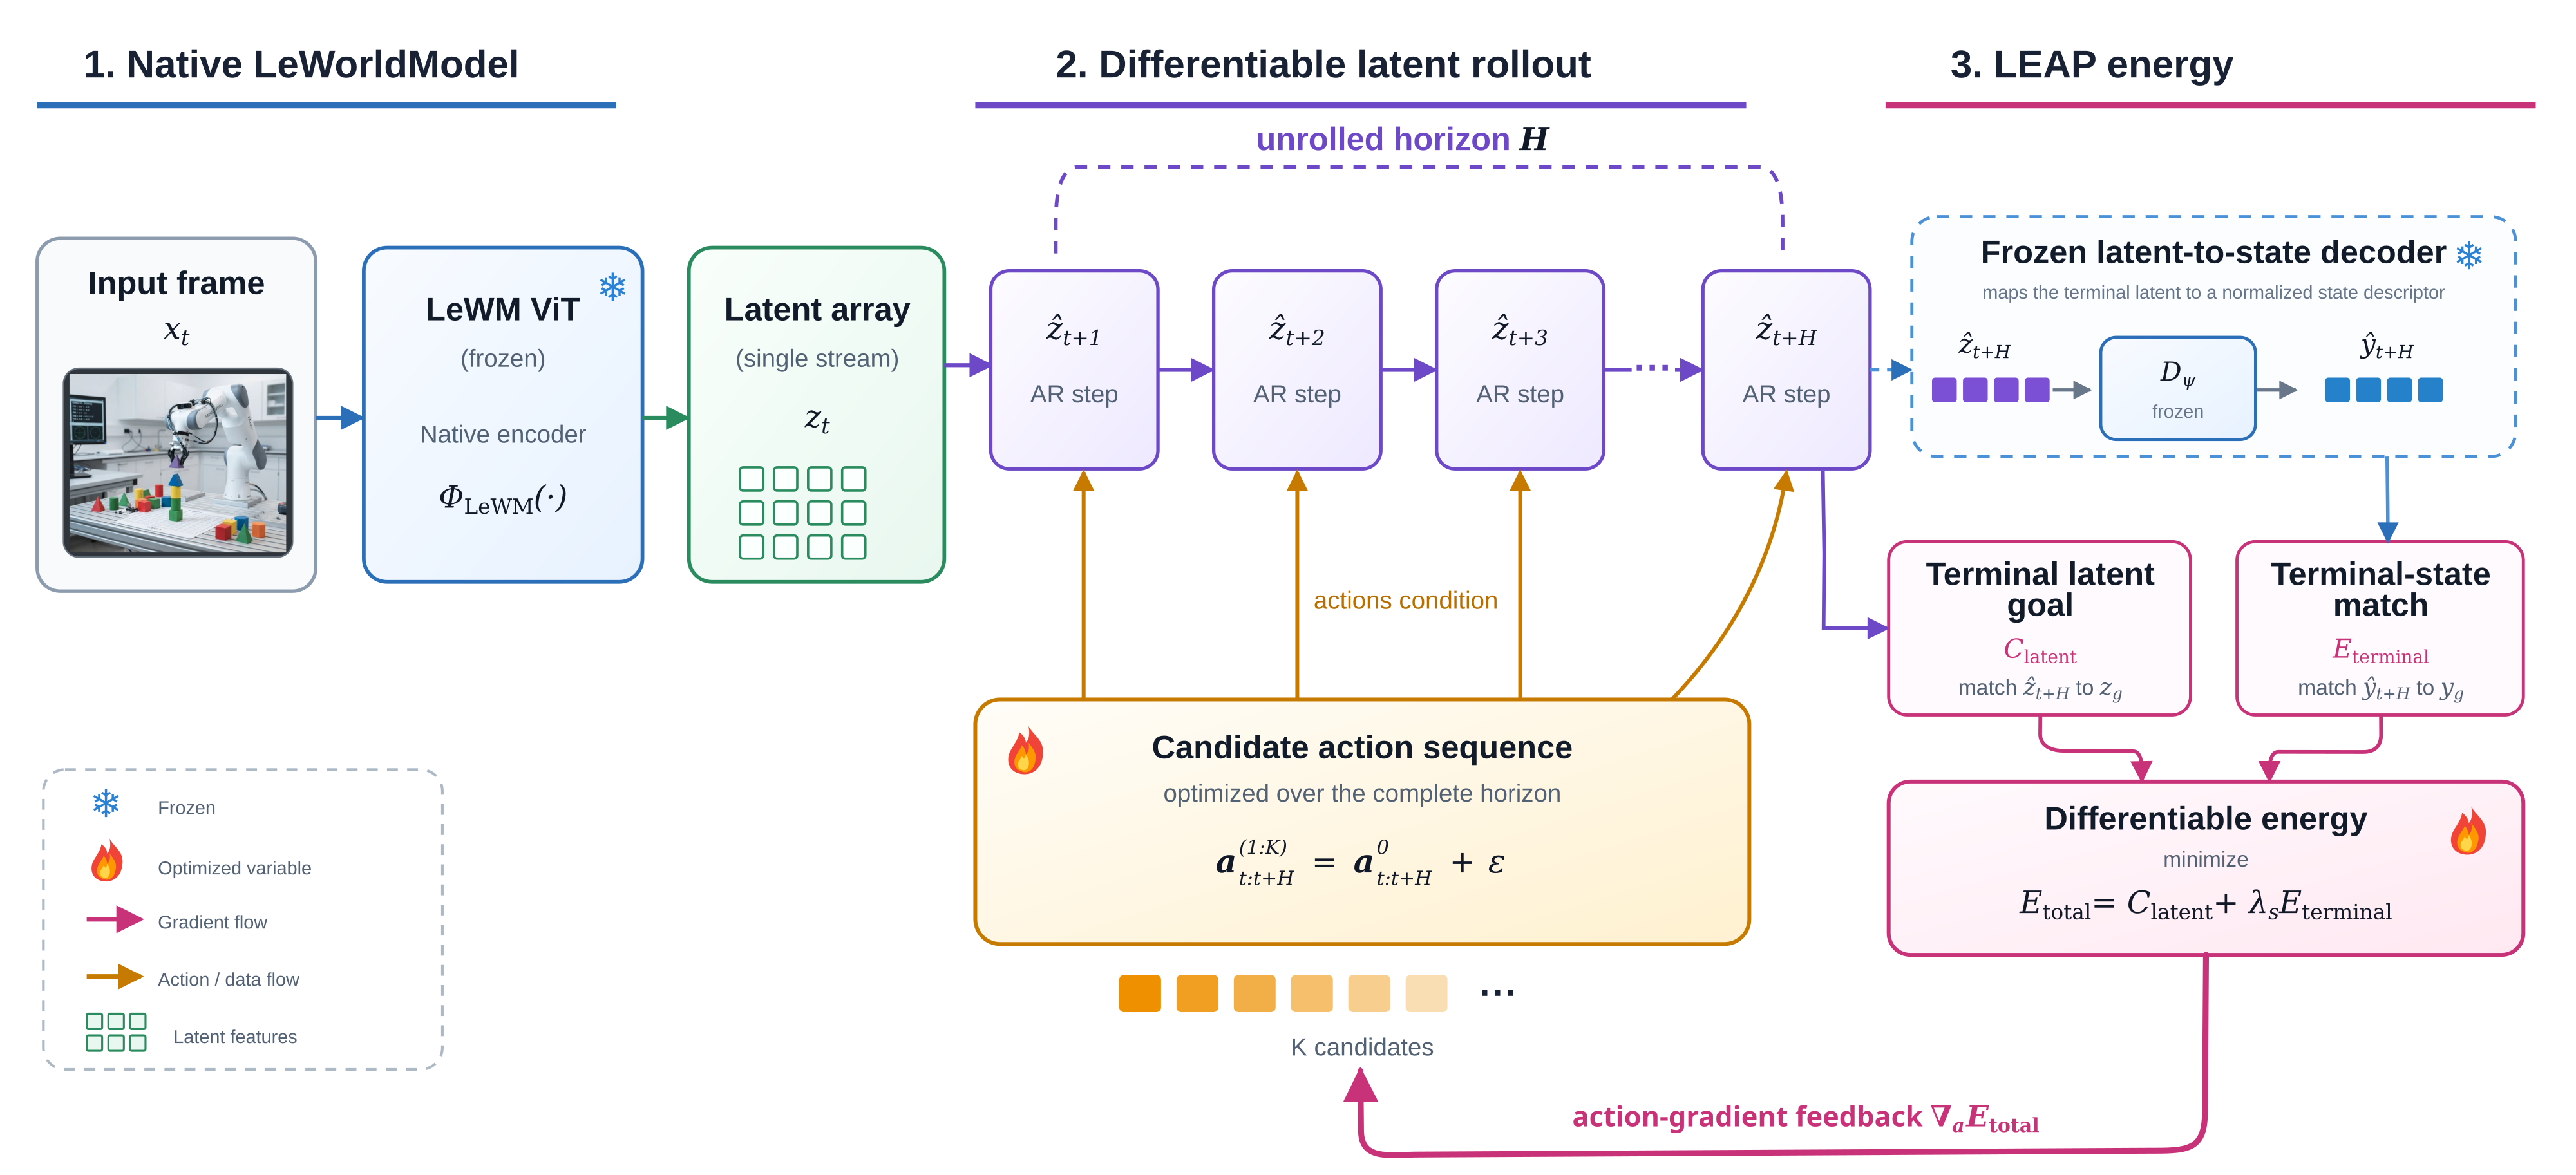
图 2 的两种终点能量怎样共同影响候选动作?
- 1
先取得动作提案与目标描述
当前图像和目标图像编码为潜在表示;另需基准提供的数值目标描述 y_g。训练动作提案网络提供候选中心,再加入扰动,Push 使用 32 个候选、Cube 1 个,其余 4 个。不是只给一张目标图片就完成全部设置。
- 2
在冻结世界模型中展开动作
五个动作块,每块五个原子动作,经过可微预测器展开未来潜在状态。参数冻结,但要保存动作梯度所需激活;候选数和时距增长仍会增加计算与内存。
- 3
加入可读终点的监督
一个两层、宽 256 的解码器先用 9000/1000 的训练/开发划分学习特征到状态的映射,再冻结。能量同时包含终点潜在距离和最后两个预测状态的数值目标误差,λ=10;因此规划器并非完全免训练。
- 4
线搜索优化,再截断与重选
用 L-BFGS 十次迭代与 strong-Wolfe 线搜索更新动作;每次迭代可能有多次函数调用,不能只按十次前向计预算。最后限制动作幅度并重新计算能量,选择有限最小值;幅度截断不等于碰撞或动力学安全约束。
- 5
执行一整块再重规划
执行所选五个动作块共 25 个原子动作,任务预算 50 步。这样减少规划次数,也延长两次观察之间的开环区间,真实扰动下的恢复能力仍需专门测试。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【四个仿真域,每域 100 次】平均成功率 LEAP 94.8%、CEM 77.5%;Push 90 对 88、Cube 100 对 62、Reacher 89 对 75、Rooms 100 对 85。 主实验 ↗
我的解读我的解读:完整系统差距包含候选提案、优化器和读出器,不能全部归因于一个能量项。
来源证据【配对 50 次消融】完整 96.5、仅潜在距离 91.0、仅状态终点 52.0。 能量消融 ↗
我的解读我的解读:更直接支持两种约束互补,终点项在此设置提供约 5.5 个百分点;单独使用数值状态不足。
来源证据【规划时间】每试验 1.28 秒,对 CEM 1.20 秒;更多 L-BFGS 迭代并未稳定变好。 预算与优化器分析 ↗
我的解读我的解读:论文统计排除环境加载等开销,目标取自相同轨迹的未来状态,不覆盖任意不连通或不可能目标。
开放情况与使用许可
已读全文及附录;未确认独立官方代码或训练检查点。论文采用的 LeWM 是上游依赖,不代表 LEAP 已发布。
LICENSE本研究实现与检查点许可待确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把难以解释的潜在目标距离与可读状态终点组合,让规划失败可以分层诊断。
反方 · 哪些结论还不够
依赖状态目标和额外训练,读出器误差可被优化器利用;仅有仿真证据,动作幅度约束不保证安全。
综合判断
适合有状态标注与可微模型的短时规划,评估时应单列目标可达性、读出器校准和真实环境扰动。
我会先做的验证
未执行的验证方案:固定真实前向调用次数而非优化器迭代数,对比 CEM 与 L-BFGS;加入分布外和不可达目标,在真实状态上检查能量降低是否真的意味着任务更接近完成。