LeWAM(NVIDIA):在策略噪声空间规划,减少世界模型误差被利用
四模式JEPA与噪声球面投影改善平均控制,不能保证所有候选都在真实策略分布内
这篇LeWAM从像素端到端训练单向量JEPA表示,用一个双向Transformer承担前向、后向、逆动力学和策略。规划时不直接搜索动作,而搜索经策略流解码为动作的噪声方向,再由世界模型预测到检索目标的潜在距离。它与其他同名LeWAM是不同论文。
图解主要方法
怎样限制世界模型中的规划搜索,使高预测分更可能转为真实控制收益?
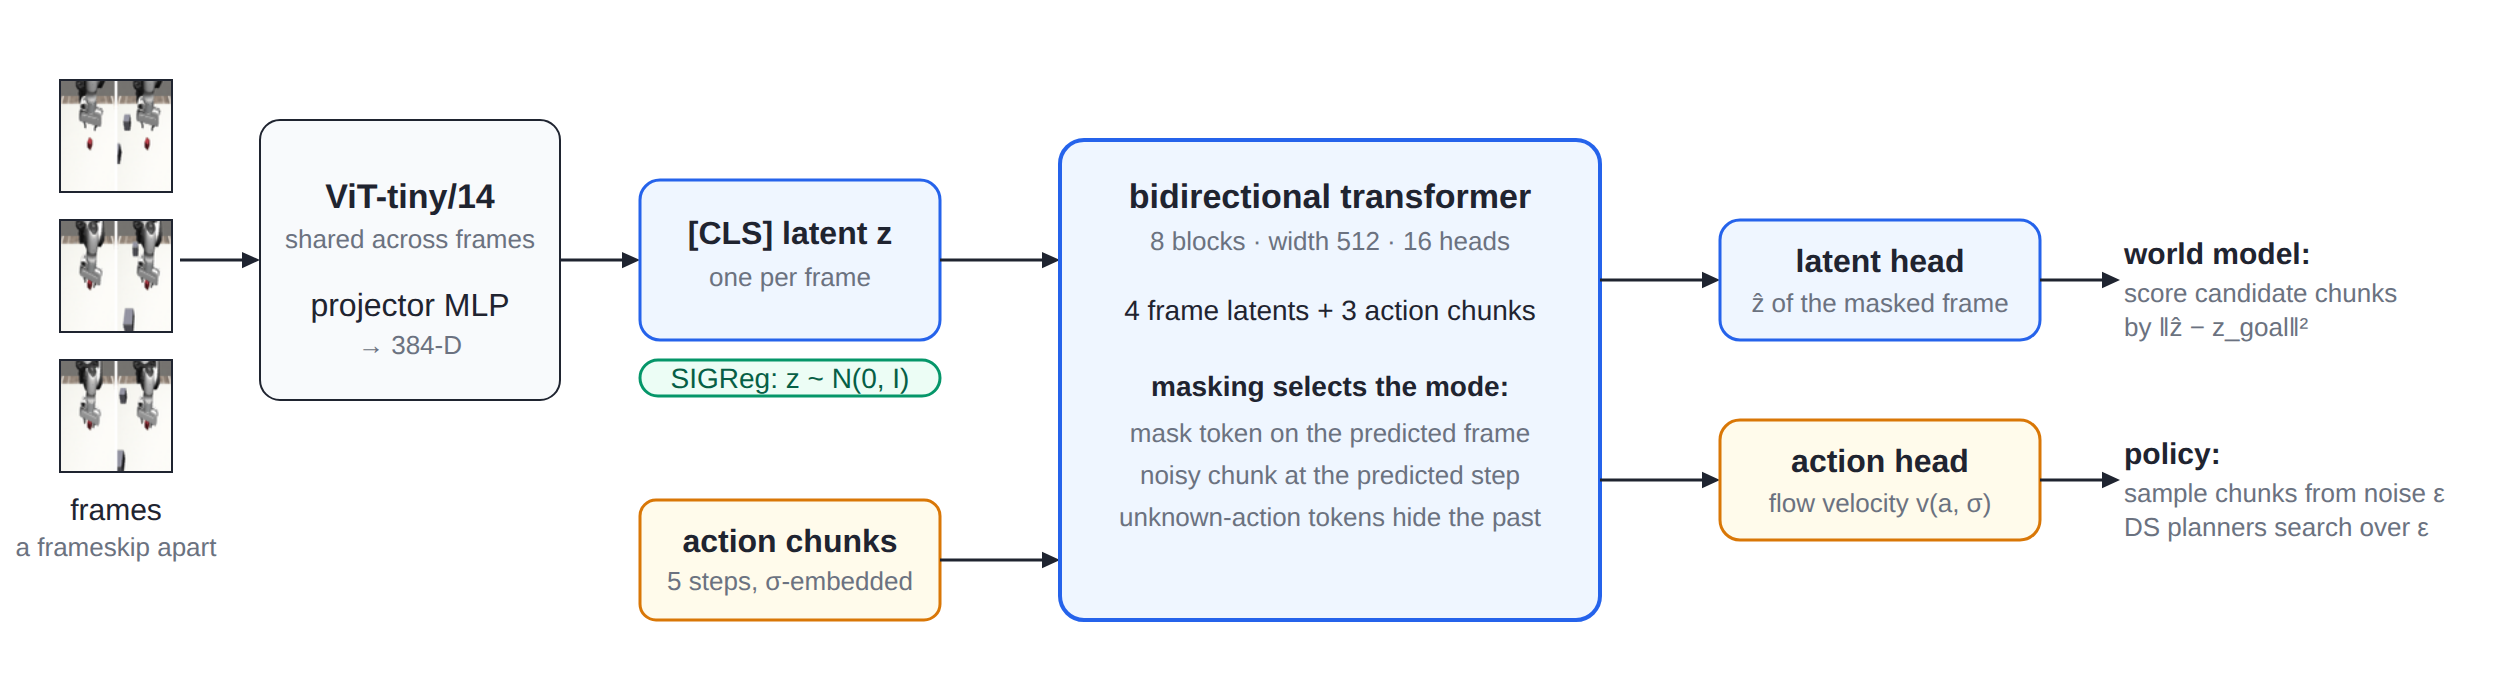
- 1
每帧编码为384维状态并防止塌缩
图2左侧ViT-tiny/14从零训练,将224像素图像经CLS和MLP转为单向量。SIGReg约束批次潜变量向各向同性高斯靠拢;没有EMA目标或stop-gradient,也不使用像素重建损失。
- 2
通过掩码在一个骨干上训练四种任务
一个窗口含4帧与3段各5步动作。遮末帧学习前向、遮首帧学习后向;给目标动作加噪学习逆动力学;同时遮未来和给动作加噪学习策略。策略模式把过去动作换成未知token,减少直接复制示范动作的捷径。每batch四种模式都执行并求和。
- 3
动作流把噪声变成候选动作块
动作按维度标准化,训练预测噪声减动作的流速度;推理从标准噪声用8步Euler生成5步动作块。前向模型再把动作映射为未来潜状态,为规划提供可比较的预测。
- 4
在想象状态下解码每个未来动作
搜索变量变为连续5块的噪声,而非直接动作值。每块先在此前想象的状态上运行策略,再用前向模型推进;最终状态与目标潜变量的欧氏距离评分。目标来自示范中最接近当前状态的帧之后25步。
- 5
投影噪声范数并滚动重规划
每次候选投影到半径√A球面,避免搜索均值缩小范数造成隐含降温。64候选×3轮,CEM/MPPI/CMA-ES只改变分布更新规则;执行最优计划第一块后重新观测。球面位置是启发式约束,不能作为所有候选都处于真实数据支持的证明。
实验与证据
完整阅读44754字符正文、参考文献及附录A–D,视检图2、5、6。核对同名项目作者区别;未运行训练、规划或机器人。
来源证据PushT206人类示范;5个robomimic任务每项200熟练人类示范,90/10分割。像素输入无本体状态,300epoch、5种子、batch128、AdamW5e−5、bf16。 第5节、附录B ↗
我的解读小规模任务专用训练与通用机器人预训练不同;干扰为独立移动的点、条和灰盒,没有改变物理动力学。
来源证据LeWAM41M;LeWM42.2M、RecWAM42.6M另加冻结3.9M VAE、Dreamer43.4M。 附录C ↗
我的解读参数大体对齐,但四模式反向传播、VAE预训练和规划调用成本不同;并非相同完整训练或推理计算量。
来源证据任务状态线性探针平均R²:LeWAM0.80、LeWM0.62、RecWAM0.78;干扰R²约0、约0、0.73。 表2 ↗
我的解读支持所测状态可线性读取且干扰难线性读取,不证明潜变量彻底不存在干扰信息。负R²被截为0,需避免把0解读为严格独立。
来源证据Lift探针R²:LeWAM0.42、RecWAM0.56、Dreamer0.46。 表2 ↗
我的解读任务均值领先不代表每任务表示更好,保留这一例外。
来源证据图5六任务平均标注:策略仅流模型63,LeWAM策略65,DS-CEM68、DS-CMA-ES69;原动作空间规划约3–6。 原图5 ↗
我的解读纵轴将PushT覆盖率与其他任务成功率合并,65不能严格称为统一事件成功率。噪声搜索平均提升有限且增加大量推理。
来源证据Can完整四模式策略82.8±6.1%,DS-CEM78.8±4.5%;Square80.4±1.5%→87.2±4.7%。 表3 ↗
我的解读规划在不同任务方向不同;不能用平均提升覆盖Can退步。Square去逆模型的策略82%还高于完整80.4%,而完整模型的规划更强。
来源证据无/有球面投影:Lift93→97.6,Can23→78.8,Square75→87.2,均为DS-CEM。 表4 ↗
我的解读支持固定范数的重要性,但仍需对比更精确的高斯半径采样及相同时间预算;范数约束不是完整分布保证。
来源证据每种子50次闭环,5种子共250;每次规划64候选、3迭代、5块,流策略每块8步。 第5.4节、附录D ↗
我的解读搜索在世界模型中完成,无搜索时真实环境交互;示范目标检索仍是外部依赖。附录“包含策略候选所以不可能更差”只对模型评分成立,真实成功不受此保证。
开放情况与使用许可
论文没有直接代码/权重入口。检索发现XuejiFang/LeWAM以及le-wam.github.io均为作者和标题不同的同名工作,本轮未核实NVIDIA这篇的实现工件。使用独立稳定id避免覆盖已收录的同名研究。
LICENSE论文和图2采用CC BY 4.0,原图未改动并标注作者来源。该研究代码和检查点许可尚未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
五训练种子、每种子50评估重置,参数规模和训练协议大体匹配;潜变量线性探针与闭环控制分别报告。
三任务去掉球面投影都会降低DS-CEM表现,尤其Can下降55.8个百分点,支持噪声尺度作为规划约束的实际作用。
反方 · 哪些结论还不够
投影到半径√A只控制径向位置,不能保证优化后的方向或想象状态仍属训练支持,也不能保证不利用模型错误。
平均收益掩盖退步:Can直接策略82.8%高于DS-CEM78.8%,PushT规划覆盖率也低于策略;Lift的任务状态探针还弱于重建基线。
基线是约41M规模的作者重实现,Dreamer控制头、RecWAM与原始大型系统不同;不能解释为击败完整Cosmos或普遍否定像素重建。
综合判断
结果支持联合任务表示与策略噪声搜索在这一小型仿真设置的价值,特别是避免原始动作搜索的严重失效。它提供经验上的限制手段,并未解决所有模型误差、分布外规划或实时部署问题。
我会先做的验证
建议实验,未执行:在相同总推理时间而非仅相同候选数下比较动作搜索、单轮候选排序与多轮噪声搜索,加入未见干扰和错误目标,测真实执行收益、模型预测误差、噪声角度集中和时延;以多任务多种子报告规划退步比例。