LILIE:用语言塑造图像损失,同时保留可逆信息
生成模型的训练距离,能否更接近语义而不丢像素?
LILIE训练可逆图像编码器,让其特征支持描述生成,再把冻结特征距离用作扩散训练损失。它属于图像与资产外观生成基础研究,不输出3D网格或PBR贴图;语义改善与细节、计数之间仍存在取舍。
图解主要方法
生成模型的训练距离,能否更接近语义而不丢像素?
- 1
以可逆映射保留图像自由度
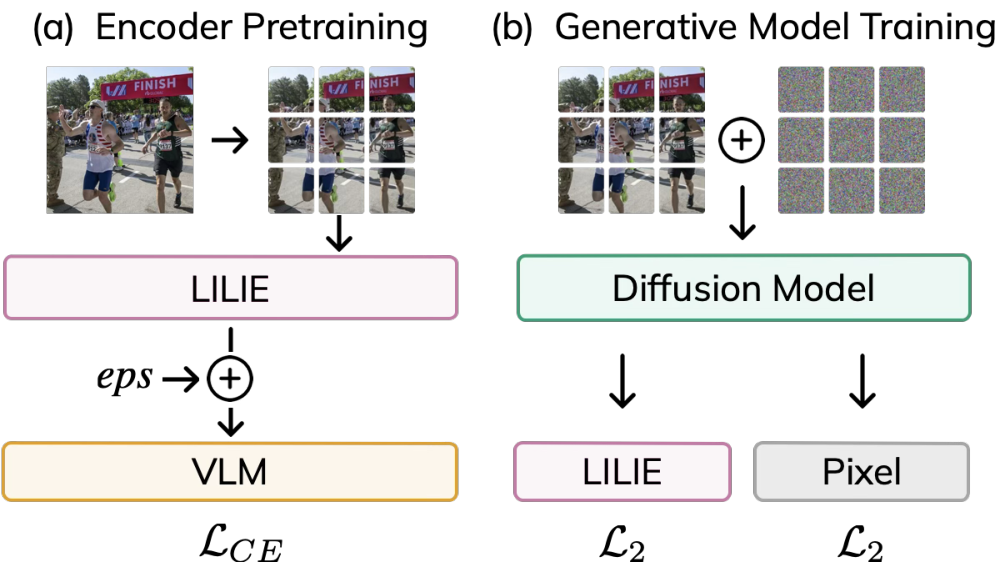
TARFlow式自回归仿射patch模块交替顺序,缩放和平移受限,编码维度与图像相同,没有压缩瓶颈。图3左侧给特征加噪后送给SmolVLM,caption交叉熵迫使可逆特征具有语言可读结构。
- 2
只在预训练阶段借助VLM
采用32M编码器与SmolVLM-256M的LoRA,按图像RMS归一化并注入0.25噪声。caption训练后丢弃VLM;下游使用固定全局二阶矩缩放,避免每图归一化破坏作为可逆距离的接口。
- 3
把特征误差加入扩散目标
图3右侧冻结LILIE,对目标与预测图像计算特征L2,再与像素L2按权重组合。语言监督影响的是训练时的距离形状,不需要每次采样调用VLM,也不表示训练成本为零。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据主要700M对照三种子gFD从66.84±1.72降至53.01±0.27;Pixel+LPIPS为48.65。 GPIC256像素、JiT、390600步 ↗
我的解读相对纯像素有效,但并非所有感知损失中gFD最佳;DINO指标也可能受预训练重叠影响。
来源证据GenEval33.57到36.41,但two-objects28.28降24.24;随机caption结果82.06差于像素80.24。 语义与消融 ↗
我的解读总体语义收益不保证数量组合正确,匹配语言而非任意附加目标是关键。
来源证据编码器预训练约40小时TPUv5e-32,生成器约40小时TPUv6e-16;主要在GPIC、256分辨率与JiT验证。 成本与适用范围 ↗
我的解读不增加推理VLM调用不能解释成免费;高分辨率纹理、UV接缝和可重光照材质尚无证据。
开放情况与使用许可
官方GitHub存在训练与采样实现;HF模型卡声明MIT并列出编码器/生成器权重。GitHub根目录LICENSE返回404,不能据模型卡替整个代码树断言MIT;第三方组件仍独立核查。
LICENSE论文 CC BY 4.0;模型卡标注MIT,代码许可待核
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
可逆表示避免把细节直接压掉,又以语言改变误差的重要性,是资产图像训练损失的可复现方向。
反方 · 哪些结论还不够
训练与评测场景集中;部分对象关系退步;没有证明真实材质参数、几何一致性或去光照能力。
综合判断
适合作为图像生成损失对照,不宜把视觉样例扩展成3D资产质量结论。
我会先做的验证
未执行的验证方案:在同一数据、架构、步数与训练成本下比较像素、LPIPS和LILIE,加入纹理细节、文字、数量关系和固定UV接缝测试。