LiteNWM:用潜在未来筛选导航轨迹,把世界模型搬上机器人
共享视觉编码、四时域预测与保守替换;快于视频模型仍慢于直接策略
LiteNWM给冻结导航策略增加一个潜在空间评估器,比较16条候选与原始轨迹的预测后果,只有满足校准门槛才替换原方案。它避免生成未来RGB视频,在三组离线数据与Go2机器人上改善导航,但仍依赖提案覆盖、标定阈值和预设视觉目标。
图解主要方法
能否通过轻量潜在未来评价改善冻结策略的导航选择,并把完整决策成本降到机载可用范围?
- 1
冻结提案策略并保留原方案
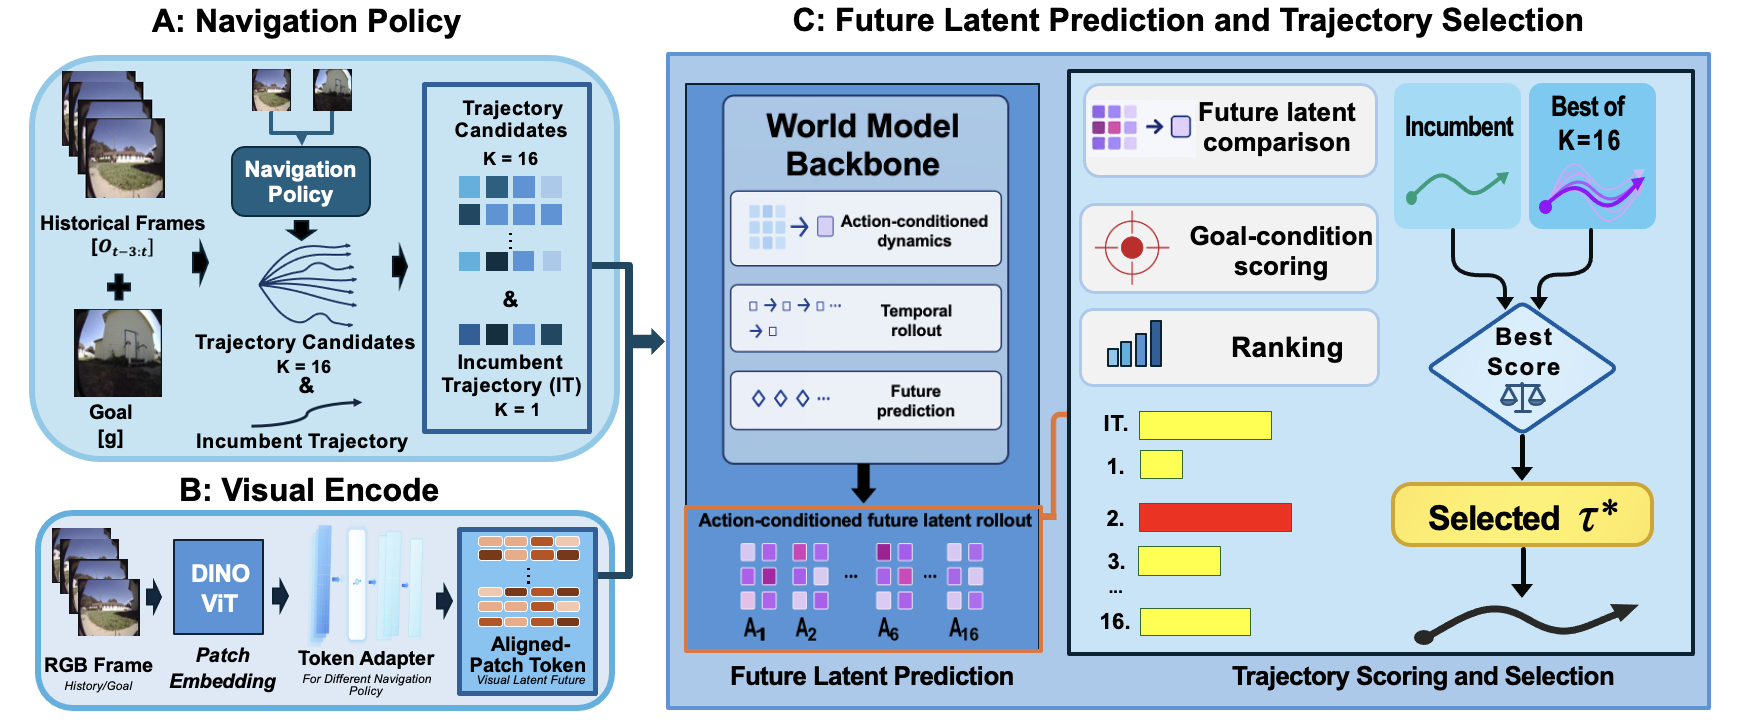
NoMaD根据四帧历史与目标图像给出16条挑战轨迹,再单独保留一条确定性的incumbent,共17条。世界模型只评估候选,不直接替代提案器;候选覆盖决定可选上限。
- 2
共享编码并显式注入动作几何
冻结DINOv3和适配器只编码一次历史特征,各候选共享。动作转为Δx、Δy、Δyaw,累积SE(2)位姿并扭曲最近特征网格,形成带动作与时域嵌入的预测查询。
- 3
联合预测四个未来时域
六个因子化模块用时间与动作因果关系预测H1–H4潜在状态,残差加在扭曲的最新网格上,不将预测结果反复反馈成自回归RGB视频。预测器不输入目标,目标用于提案与打分。
- 4
学习相对原轨迹的收益与风险
三个预测器和三个打分器估计ΔATE、ΔRPE、ΔFDE与组合误差J,融合偶然和模型不确定性。校准温度、置信上界、双收益与有害概率阈值均在独立校准集设置。
- 5
满足门槛才替换并执行短前缀
候选先过物理可行性和提案支持筛选,再要求ATE与J置信上界足够好且风险受限。无合格候选则保留原轨迹;默认离线一次CEM,机载按条件可到三轮,再执行短动作前缀并重新观察。
实验与证据
完整阅读54044字符正文与附录A–G,核对作者主页指向的官方项目、原图2及实验协议。未复现训练或机器人实验。
来源证据RECON、SCAND、SACSoN各100个查询、4个提案种子,共1200状态-种子组合;误差按各数据集路点间隔归一化。 第4节、附录评估协议 ↗
我的解读统计以查询聚类bootstrap保留种子相关性,不能把1200当独立场景;离线SR@1只表示终点误差≤一个路点间隔。
来源证据三域宏平均ATE:NWM-XL 0.5538,LiteNWM固定池0.4617、CEM1 0.4566、CEM3 0.4537。 表VII ↗
我的解读默认相对XL约降17.55%;固定池已保留约94.75%的默认改善,说明重排比额外优化贡献更大。NWM原生H8改H4且目标不同,仍有协议限制。
来源证据匹配诊断中去未来ATE增加0.0158,95%区间[0.0052,0.0256];错配未来增加0.0294 [0.0175,0.0413];动作置乱增加0.0300。 消融与附录诊断 ↗
我的解读支持潜在未来和动作确实参与决策;这些诊断与表II独立训练消融是不同运行,不能混用两表数值相减。
来源证据H4相对H1–H4增加0.0031,区间[-0.0014,0.0065];多预测器/打分器六项比较经Holm校正未显著。 附录匹配消融 ↗
我的解读方向上可能受益,但不足以宣称四时域或集成在全部指标有确定优势。
来源证据CEM3门控把有害替换从23%降到9.92%,替换覆盖率100%降至64.83%;无门控减门控ATE为−0.00409,区间跨零。 附录门控分析 ↗
我的解读有害比例分母是全部查询,并非已替换样本。它体现风险与覆盖权衡,而非已证明平均误差更低或安全有保证。
来源证据RTX5090每状态0.691秒、2459MiB、GPU能耗0.0277Wh;NoMaD+NWM-S 11.653秒,XL 88.449秒。 表III、附录E、官方项目 ↗
我的解读对应16.86倍和128倍,采用表III及项目页数值;论文结论另写18.39/132.02,存在不一致。计时摊入初始化与预热,能耗仅GPU。
来源证据Go2三场景各方法10次:NoMaD 13/30成功,LiteNWM25/30;SPL 0.409→0.810。 表V、官方项目 ↗
我的解读成功需1米内目标匹配、偏航≤60度并保持1秒或正常停止;碰撞与人工纠正算失败。样本规模较小,不能外推所有户外条件。
来源证据机载311次LiteNWM决策平均2.228秒、P95 3.883秒;NoMaD302次平均0.651秒。NWM-S均值235秒来自两次探索运行。 第4F节、附录机载协议 ↗
我的解读NWM-S未参与上述成功率统计,不能将探索视频当等规模胜率对照;长路线演示还使用预设图像路标和里程计进度。
开放情况与使用许可
作者主页链接litenwm.github.io,官方页代码明确标注Coming soon;未确认可下载实现、训练数据处理脚本和模型权重。
LICENSE论文为arXiv非独占托管许可,原图仅用于方法评论;项目网页模板的CC BY-SA 4.0声明不自动代表模型或训练代码开源。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
共享视觉特征与联合四时域预测兼顾计算效率,动作置乱和错配未来会明显降低轨迹选择质量。
官方项目明确披露机载延迟、全部60次两方法试验和NWM探索性试验的不同统计口径。
反方 · 哪些结论还不够
候选池与原策略决定性能上限,98.42%的离线查询存在更好候选,但实际仅49.75%选到更好轨迹。
门控牺牲替换覆盖率以减少有害替换,并未显著证明平均ATE改善;多模型集成各项优势经多重校正后也不稳定。
机载平均2.228秒比NoMaD的0.651秒慢约3.42倍,不能把对视频模型的优势描述成对所有导航策略的加速。
综合判断
它提供了较完整的“潜在预测如何改善决策”证据,适合作为短时域导航评估层;尚不能据此认定获得通用、实时或有安全保证的长程世界模型。
我会先做的验证
建议实验,未执行:固定提案池和总计算预算,跨新楼宇、光照和动态障碍评估校准失效;分别报告无门控、单模型和集成的碰撞率、延迟尾部与任务成功,长路线移除预设子目标后另测。