Looking Ahead:让当前视频表征预测更远的未来
训练时增加未来块预测,能否减少视频模型依赖局部重复?
Future Chunk Prediction 在自回归视频模型的中间层增加辅助分支,要求当前块的表征预测不同距离的未来块,推理时移除分支。Physics-IQ上的一致性提升支持这类训练约束,但结果仍是视频续写指标,不等于获得可控的物理模拟器。
图解主要方法
训练时增加未来块预测,能否减少视频模型依赖局部重复?
- 1
第一步:从当前块提取跨层状态
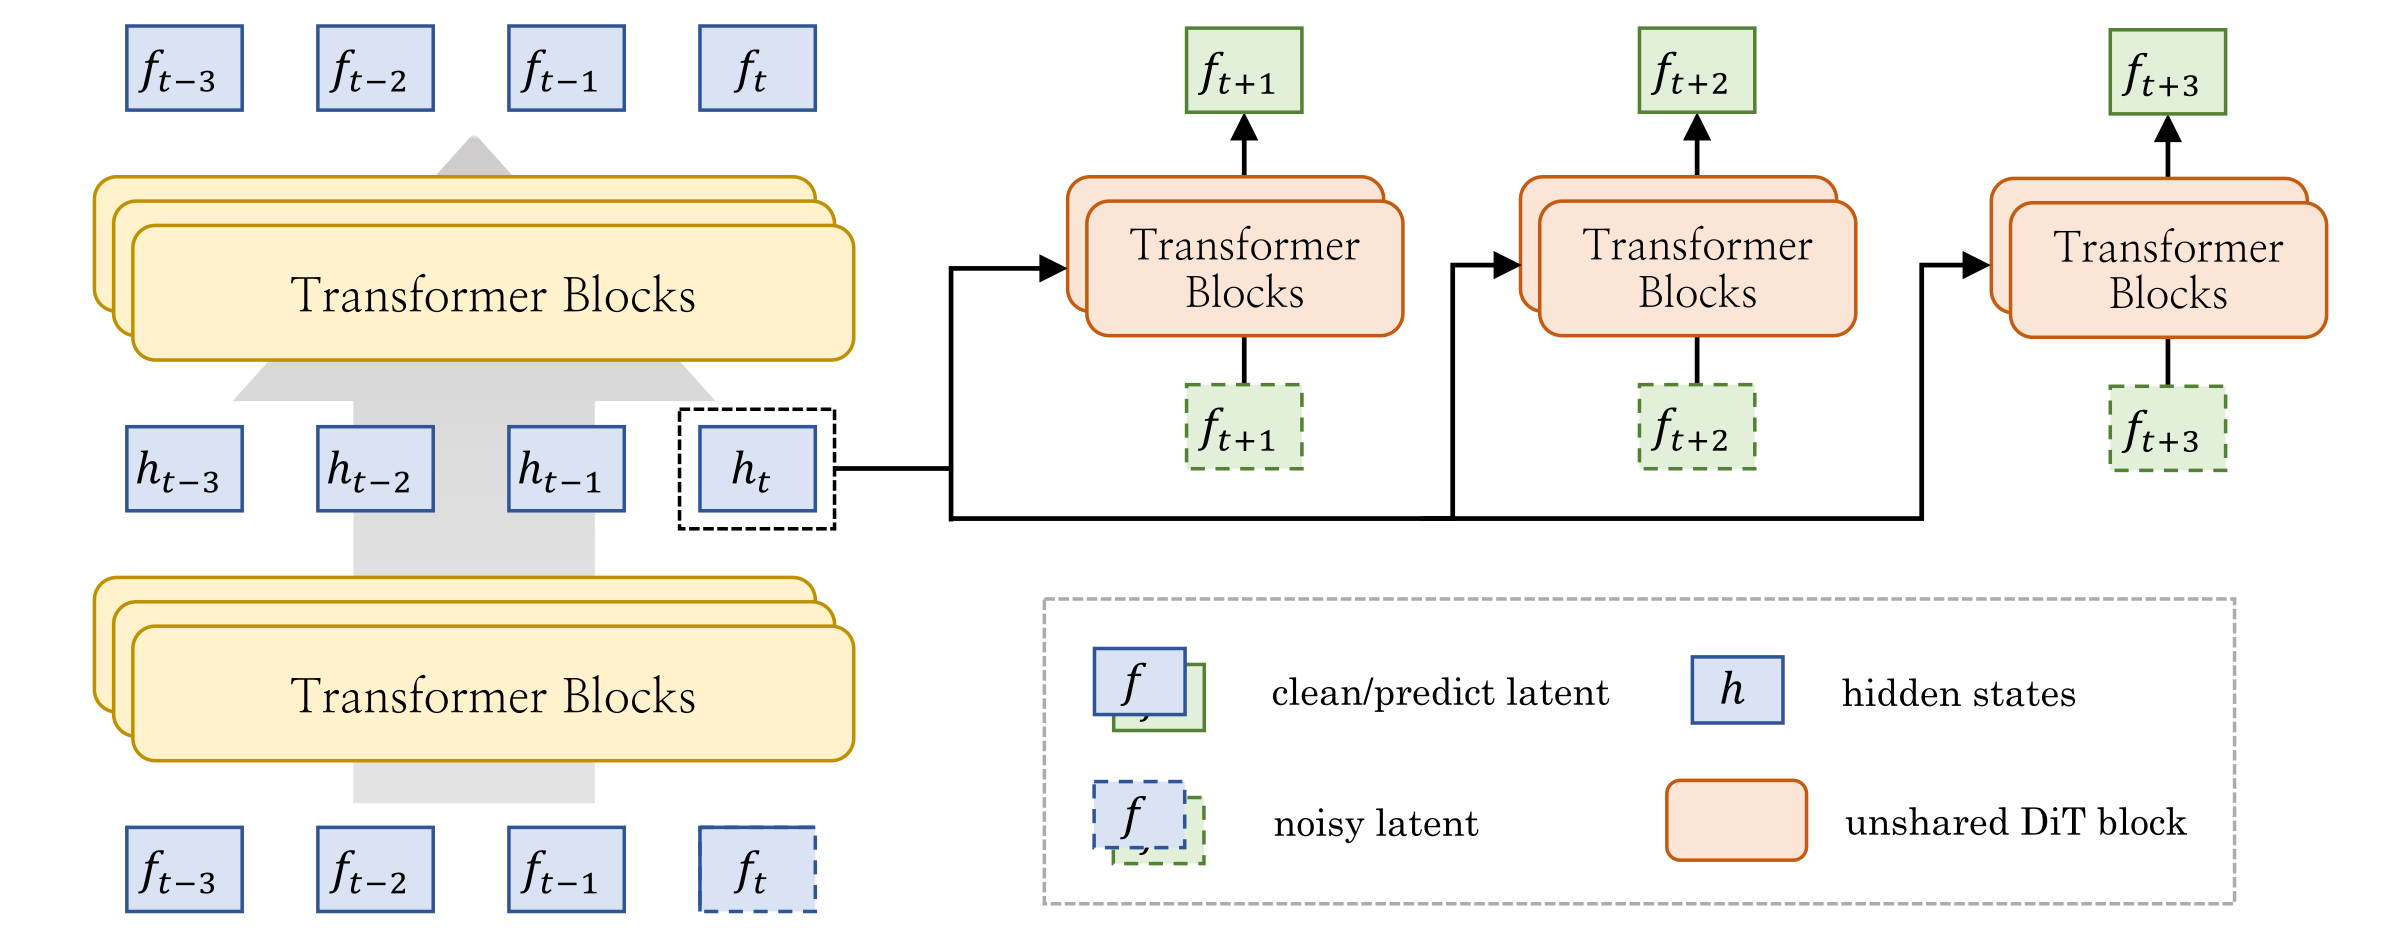
图1下方的自回归主干处理历史干净块和当前带噪块。作者从四个中间层融合隐藏特征,经MLP投影与逐token的AdaLN调制,形成未来预测的条件。这样要求当前表征携带演化信息,而不只借相邻视频帧的冗余还原当前画面。
- 2
第二步:并行预测不同时间偏移的块
图1上方不同颜色的未来目标由独立的三层DiT辅助分支预测,各自读取同一源块表征与目标噪声。辅助分支不额外读文本,也不顺次读前一个未来分支的结果;相比链式预测,这降低了从中间带噪目标泄漏未来信息的可能。
- 3
第三步:用未来监督约束主干,推理时删掉分支
训练将原本的视频目标与辅助未来预测目标共同优化。多个未来偏移可并行计算,仍增加训练开销;完成训练后保留主干、移除辅助分支,按原自回归流程生成。训练期成本与推理期架构开销必须分开,不能把移除分支说成训练免费。
- 4
第四步:用受控续写评估演化是否更一致
模型基于Wan的1.3B和5B设置,输入图像或视频前缀续写。论文用Physics-IQ Verified比较相同基础模型的Teacher Forcing与FCP;附录提出利用辅助预测加速推理的可能性,但没有完成验证,不能当成已实现结果。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据1.3B训练20k步、8 GPU、85帧768×432/16fps;5B训练25k步、32 GPU、121帧1024×576/24fps。数据包含内部视频及WISA约80k片段。 实验设置与附录A ↗
我的解读比较有受控基线,但完整训练数据没有都开放。公开演示数据不能代替原训练分布,复现难度应与代码是否开放分别看。
来源证据198个测试案例,5秒视频、四个种子42–45、50步UniPC。1.3B从27.6到30.9;5B图像续写30.4→33.8,视频续写40.6→44.4。 表1–2,Physics-IQ Verified ↗
我的解读多个条件下改善支持未来监督有效,但分数不是物理定律误差,也不是操作任务成功率。没有动作条件或闭环规划实验支持直接用于机器人控制。
来源证据文中给出按估计FLOPs匹配的训练预算比较,并分析并行与链式分支;更远偏移和组合的收益并非无上限。 图4与附录B–C ↗
我的解读FLOPs匹配不是实测相同墙钟成本。辅助预测带来更好的表征这一解释合理,但不能跳过数据、监督范围与优化差异的作用。
开放情况与使用许可
2026-10-25核查官方仓库含训练与推理实现,Apache-2.0许可;官方模型仓库实际列出1.3B/5B的TF与FCP四份model_ema.pt,模型卡及LICENSE标Apache-2.0。论文复现说明中的源码包范围不能覆盖当前已补放出的权重状态;公开demo数据不等于全部内部训练数据。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把未来预测作为训练时的结构约束,同时保持推理主干不增加分支,适合探索视频模型的动力学表征,不必先设计显式物理状态。
反方 · 哪些结论还不够
评价主要依赖视频一致性基准,内部训练语料限制严格复现;更好看或更符合基准的续写不等于可外推受力、碰撞和干预结果。训练计算收益也未用墙钟直接证明。
综合判断
可作为提升自回归视频物理一致性的训练方案;若用于世界模型规划,还须增加动作干预、状态误差和闭环效果验证。
我会先做的验证
未执行的验证方案:固定相同可公开数据、种子与总训练GPU小时,对照TF、单偏移和多偏移FCP;除Physics-IQ外,构建碰撞、遮挡后再出现及反事实动作测试,记录位置误差、长期漂移和生成耗时。