MA-WAM:用联合世界模型选择多智能体未来
固定策略提出候选,再按团队回报排序;部署需要集中观察
MA-WAM不重新训练部署策略,而让冻结的多智能体流策略提出多组联合动作,再用能交换跨智能体信息的世界模型预测回报,选第一步执行。实验显示排序有价值,但候选生成才是主要延迟,且集中式测试设定不能直接推广为分散机器人协作。
图解主要方法
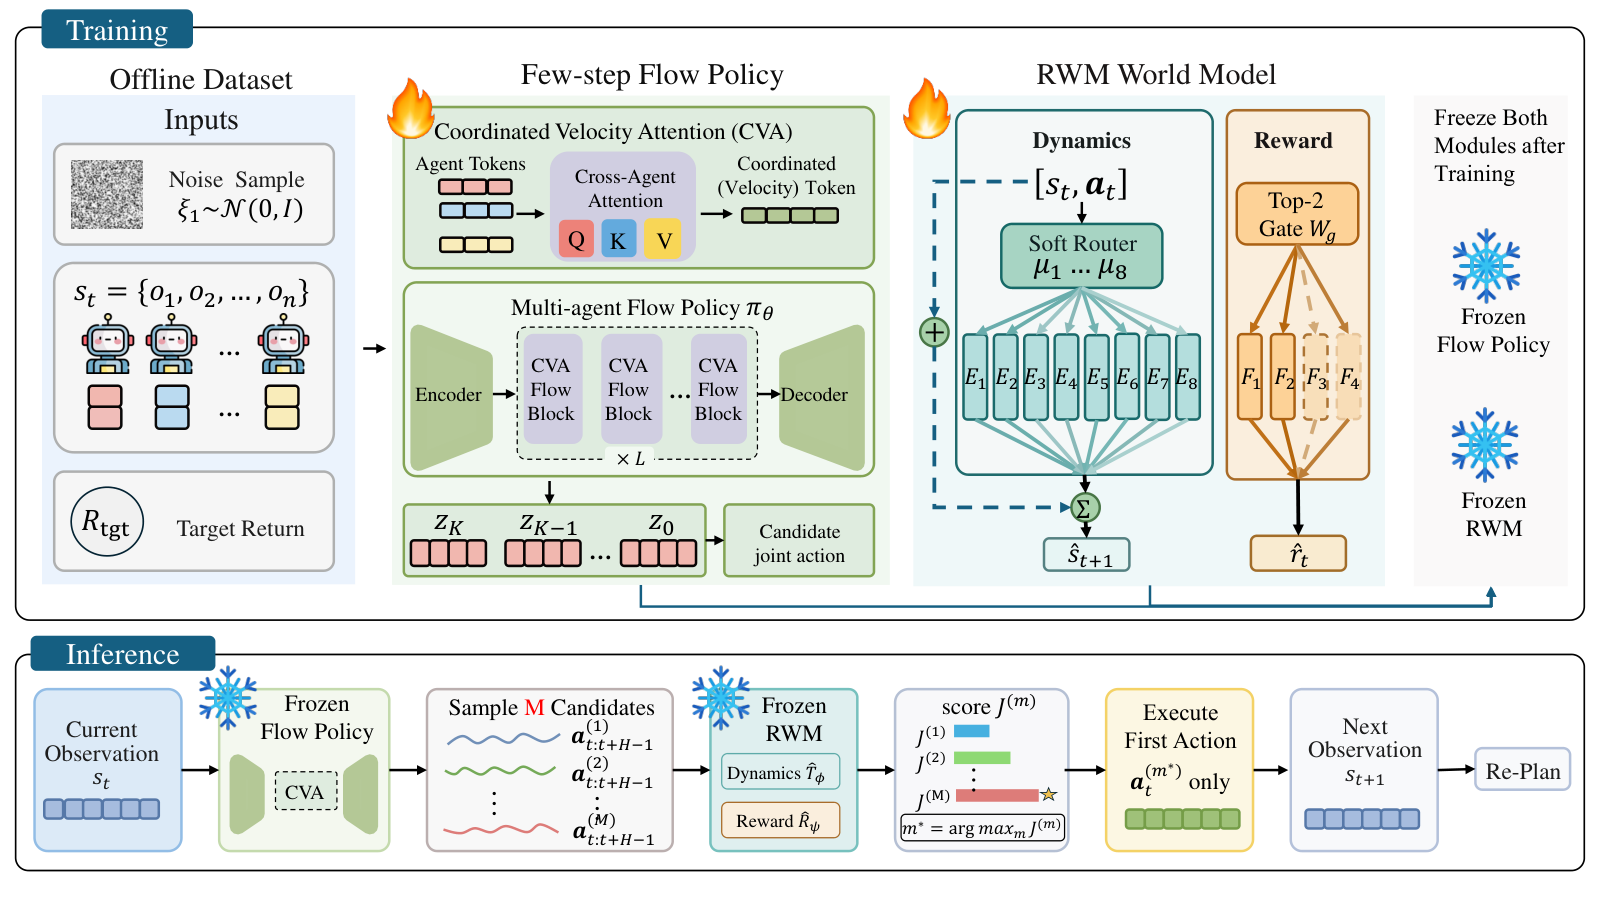
图1如何把联合候选、路由世界模型和真实观察重规划组成闭环?
- 1
用冻结流策略生成联合候选
图左从当前联合观察历史生成M=8条候选。流模型同时去噪所有智能体的预测观察序列,逆动力学头再得到动作;跨智能体注意力协调提议。主要受控实验每候选三次去噪,部署策略参数保持冻结。
- 2
用软路由预测团队状态变化
RWM将每个智能体观察和动作组成token,分配到八个动力学专家、每专家四个槽,聚合所有智能体后再组合为各自状态增量。共享槽显式建模同时动作之间的依赖,不能视为多个独立单智能体模型简单相加。
- 3
用独立奖励路由累计候选分数
奖励分支读取当前观察、动作及停止梯度的预测下一观察;四个专家均计算,仅top2参与混合。奖励损失不回传动力学,另加负载均衡。规划按累计预测奖励排序,默认请求H=8,但部分SMAC任务实际有效范围只有3。
- 4
只执行第一步并重取真实观察
图右执行最高分候选的第一联合动作,再从真实状态重新提议,限制一次想象误差累积长度。实际实验为集中训练、集中执行CTCE,需要联合观察;附录的分散化讨论不是已验证部署结果。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【受控收益】30个离线MARL设置、五种子;M8规划相对M1直接执行平均提升22.0%,26/30设置更高;相同M8预算的随机选择对照提升25.6%,23/30更高。 受控主实验、附录表2/3 ↗
我的解读我的解读:同预算随机对照更能隔离排序价值;均值会被低基线放大,如一个MPE条件相对223%实际约多3.1分。
来源证据【排名可靠性】不同起点片段相关性约0.81;五任务同一起点、每个64锚点的精确候选检查平均相关性0.318、top1命中0.275。 排序诊断与同状态模拟器检查 ↗
我的解读我的解读:跨起点容易区分的好坏片段,不等于同一状态下候选排序同样可靠;后者更接近真实规划需求。
来源证据【延迟】A100顺序生成八候选461.6ms,加RWM评分12.1ms,共473.7ms。 延迟表与批量生成附录 ↗
我的解读我的解读:2.5%是评分占这组总时间的比例,不是规划相对单候选仅增加2.5%;批量生成另有加速配置。
开放情况与使用许可
全文与可用附录已读;未核实作者专属策略、世界模型或训练代码公开,不以公式和伪代码替代实际发布。
LICENSE代码及模型许可未确认;论文原图许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用相同候选预算的随机选择对照检验世界模型排序,并提供同状态诊断,比只展示预测误差更接近规划价值。
反方 · 哪些结论还不够
集中式信息、候选分布上限、弱同状态排序及候选生成延迟限制部署;平均相对增益易被低基线影响。
综合判断
适合离线多智能体短期规划研究;是否划算应由等延迟、等信息条件的闭环效果决定。
我会先做的验证
未执行的验证方案:固定总推理时限,比较M1、随机M8、RWM排序和真实模拟器上界;逐任务报告绝对回报、同状态排序、P95时延,并在受限通信和观察缺失下重测。