MatAnyone-E:先粗查,再精算高分辨率视频抠像
为何只细算少量位置,还必须同时筛掉不相关记忆?
在视觉资产流程中,稳定的alpha边界可支持合成、遮罩和后续局部编辑。MatAnyone-E用低分辨率匹配选择位置与记忆,再用轻量解码器输出完整alpha;这是二维视频抠像,不生成mesh、UV、纹理材质或重光照参数。
图解主要方法
为何只细算少量位置,还必须同时筛掉不相关记忆?
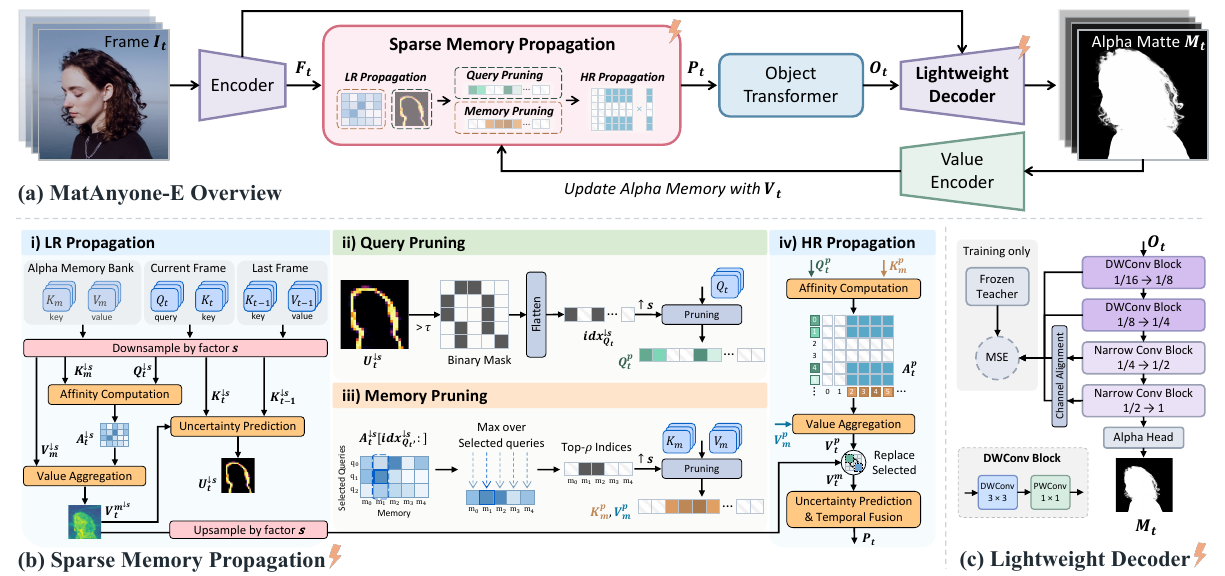
- 1
粗匹配打破选择依赖
图2先降采样query和历史key/value,得到便宜的匹配与更新门。这个“uncertainty”是依赖新记忆的时序融合权重,不是经过校准的置信概率。s=2时粗匹配对数约为原来的1/16。
- 2
两侧都做稀疏筛选
门值超过0.15的位置细算;按选中query对记忆的最大相关度保留15%记忆,当前检索筛选不删除持久记忆库。未选位置保留上采样粗结果,选中位置替换为精细结果,随后正常时序融合。4K采用4→2→1多级细化。
- 3
按实测瓶颈设计解码
低分辨率两级用深度可分离卷积,高分辨率两级缩窄稠密卷积,避免低FLOPs却访存更慢。冻结原解码器作教师,四级特征MSE蒸馏权重0.001,训练后移除通道适配器。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据8张A800训练,batch16、每样本8帧480方形裁剪;1080p三数据集与MatAnyone2的MAD差最多0.04、dtSSD差最多0.07。A800原生4K为8.1FPS/6.08GB,编译后13.6FPS/3.89GB。 表1、表2与训练设置 ↗
我的解读质量量化主要在1080p,4K细节多为可视示例;不同GPU和编译状态必须分列。
来源证据MatAnyone2的4K满5帧记忆溢出,约1.1FPS/79.69GB由较短记忆外推,7.4倍/13.1倍为估计比例。1080p实测73.53→37.59ms,5.47→1.66GB。 附录B与表3 ↗
我的解读实测1080p提速证据更直接;H200编译28.62FPS不能与A800未编译基线拼成同机比较。
开放情况与使用许可
官方仓库目前仅LICENSE、README和assets;代码、检查点、HF demo、ComfyUI节点均在TODO。S-Lab License 1.0限制非商业使用,不能称完整可商用开源。
LICENSE论文 CC BY 4.0;项目 S-Lab License 1.0(非商业)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把高分辨率匹配的query与memory同时减少,并按延迟而非FLOPs选解码结构,具有清楚工程动机。
反方 · 哪些结论还不够
需首帧前景mask;细发丝、透明物和大幅运动可能受粗筛选漏检影响。仍要验证4K量化质量;它不解决UV接缝、PBR去光照和材质可编辑性。
综合判断
适合资产合成前处理的候选加速方案;尚不能依据项目演示直接进入商用生产。
我会先做的验证
未执行的验证方案:固定首帧mask、5帧记忆和GPU,测4K快速运动、细发丝与透明边缘的时序误差;分别报告编译冷启动、稳态延迟和峰值显存。