MC-Sparse:高分辨率3D生成怎样减少注意力计算,又保住细结构?
精确挑选token、相似查询分组与跨步残差补偿;2.32倍仅指去噪阶段
MC-Sparse将稀疏注意力的误差拆成分组限制、选择不准和丢弃尾部贡献三部分。在少量锚点步做精确选择与密集/稀疏差值计算,后续步复用索引及残差、重新计算当前QKV。它在内部3D生成模型上更接近密集注意力输出,但没有验证整个纹理或资产管线的加速。
图解主要方法
怎样在删掉大部分注意力交互后,仍接近原模型的细结构输出?
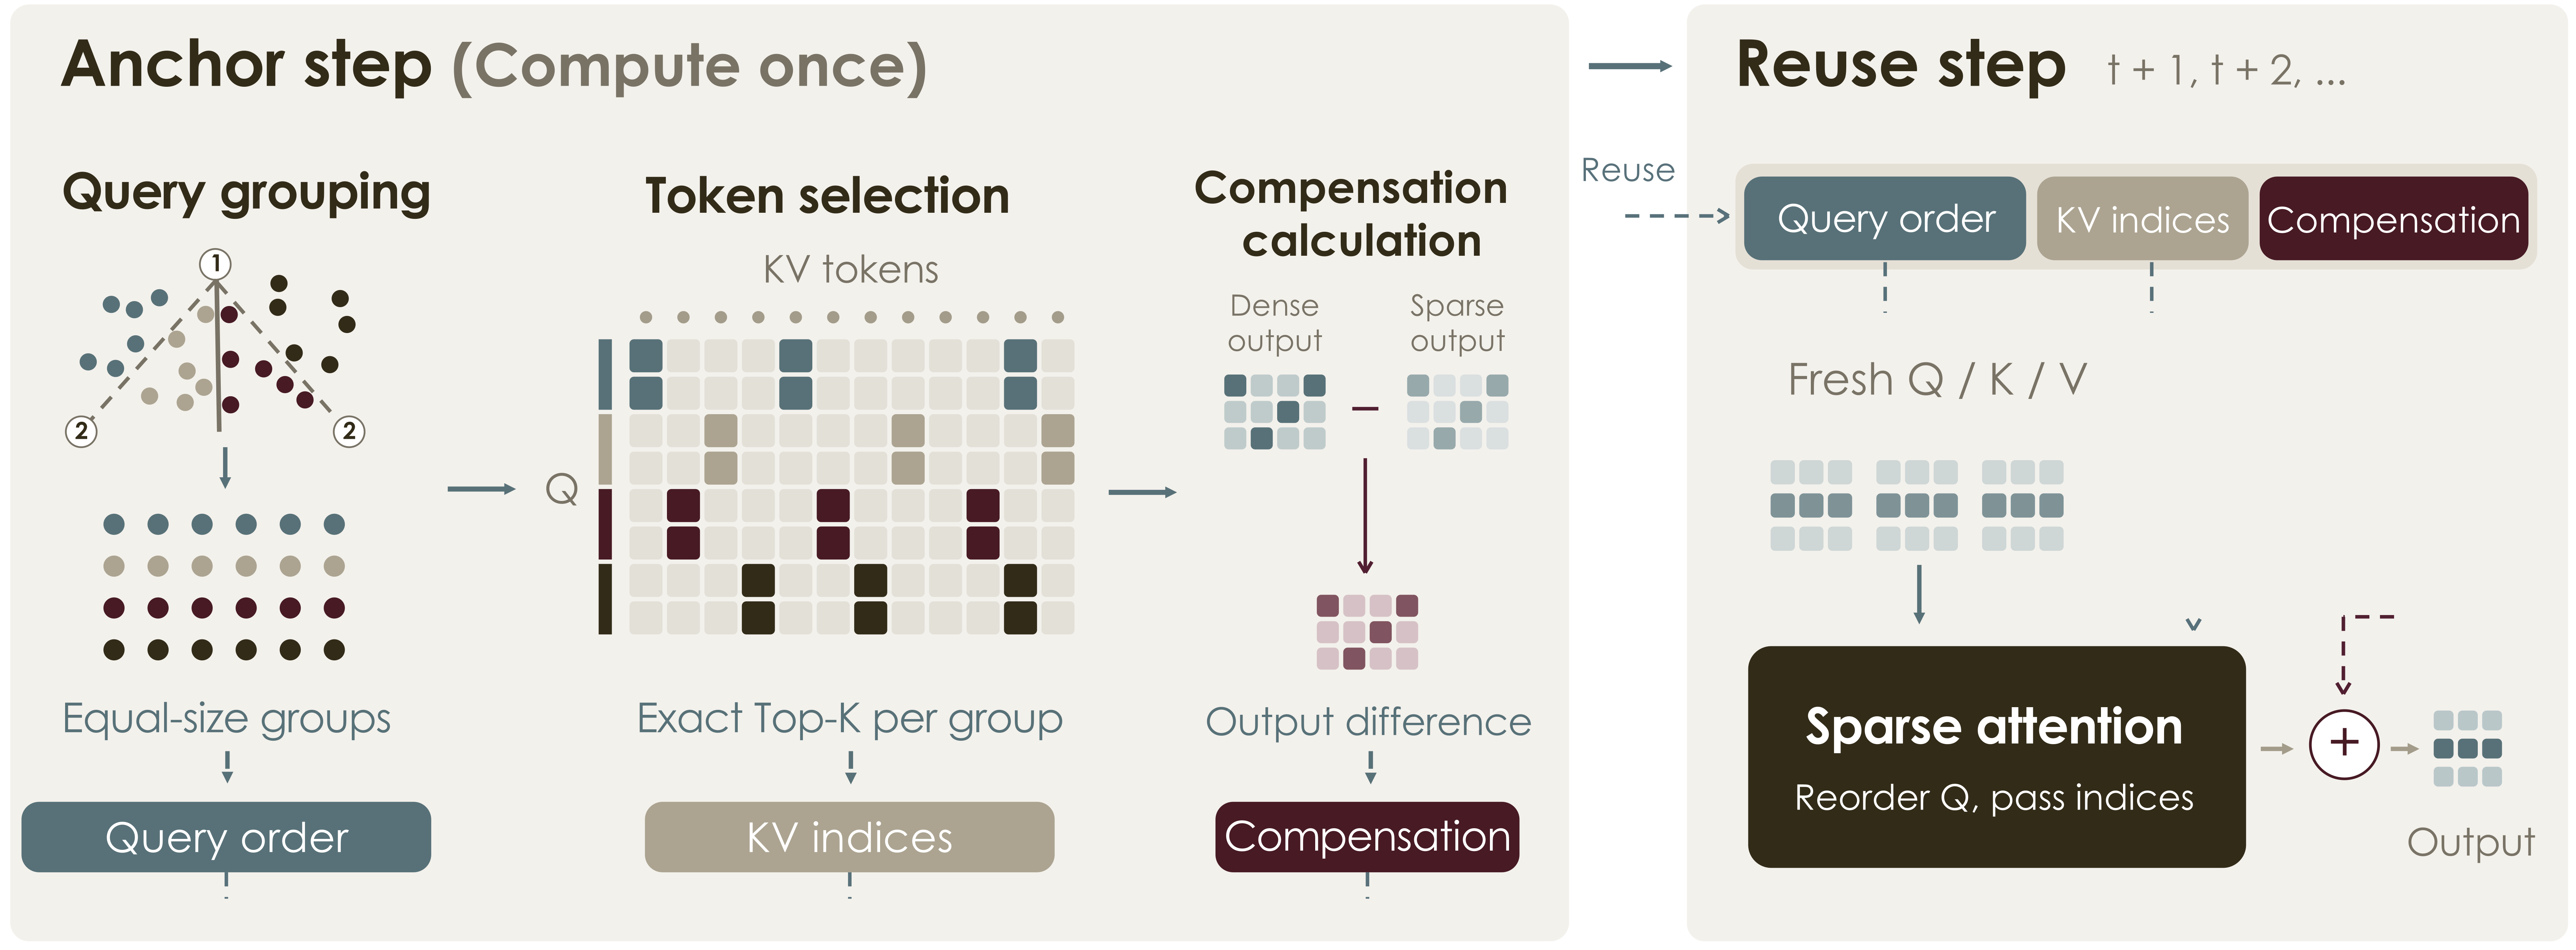
- 1
把相似查询排成等大的GPU计算块
图6左侧Fast PDDP按主方向投影、在中位数递归切分,尽量使每组查询相似且大小与GPU tile一致。它减少同组查询被迫共享索引的误差,但没有做到每个查询各选一套KV。
- 2
在锚点步精确选择单个KV token
先计算密集注意力和每行log-sum-exp,再第二遍计算QK恢复概率,按查询组累加概率后取top-K。选择跨越原有KV块边界,减少为了保留一个重要token而被迫保留整块的浪费。
- 3
缓存密集输出与稀疏输出的差
同一锚点再运行一次稀疏注意力,将密集输出减去稀疏输出得到残差R。即使top-K完全准确,丢弃项仍有非零贡献;R用来补偿这部分及归一化后输出差异。
- 4
后续步复用元数据而非旧QKV
图6右侧复用查询顺序、KV索引和R,但当前步的Q、K、V重新计算。稀疏结果加上缓存残差;遇刷新锚点重新分组和估计,故它是近似跨步补偿,不是每步密集注意力的精确等价。
- 5
用专用内核与预取摊薄额外成本
CuTeDSL内核在线按索引抓取KV,生产/消费warp与矩阵运算重叠;缓存过大时卸载CPU并提前一层预取。锚点需要额外QK和稀疏计算,必须计入总去噪成本。
实验与证据
完整阅读53690字符正文及附录A–B,视检图6,核对官方项目、代码树、README、LICENSE和NOTICE。未运行GPU内核或生成基准。
来源证据HY3D-Internal为1536分辨率、12去噪步,1/40层始终密集、第一步预热并作为唯一锚点;运行于单Hopper GPU。 表9、附录A.2 ↗
我的解读2.32倍对应该内部模型与具体短采样配置,不能直接套到任意混元开源版本、消费卡或纹理模型。
来源证据15%密度时CD0.177、体积IoU82.91、F1(阈值0.001) 96.33;PISA相应0.976、63.22、83.29且密度25%。 表2 ↗
我的解读几何指标对照密集模型生成结果,衡量近似保真。输入一致性Uni3D-I 0.3311与密集0.3309接近,不证明准确重建真实隐藏面。
来源证据视频每任务随机50样本;MiniMax-H3官方API增强提示、345帧约14.4秒,8张Hopper中7张去噪、1张条件与解码。 表1、附录A ↗
我的解读视频1.80倍速度有多卡和特定提示条件;比较的速度只计DiT去噪,含预热但排除条件编码与VAE解码。
来源证据Wan1.3B、25%密度累计消融PSNR21.67→22.63→23.54→24.47→27.35,最后一步加残差;普通BSA加同类残差仅21.67→23.12。 表3、表5 ↗
我的解读残差增益依赖较准确的选择与分组,不能把整个方案简化为任意旧特征相加。PSNR仍是对密集输出的相似度。
来源证据Wan14B注意力内核20%密度4.79倍,但该表排除选择和分组;锚点及辅助开销约相当于额外5–6个百分点密度。 表6、第5.4节 ↗
我的解读理想1/s速度上限只适用于核心稀疏计算,不能用它代替端到端测量。
来源证据缓存每层搬运约2435MB/2710MB,传输47.7/52.9毫秒,小于所测稀疏计算208.8/244.5毫秒。 表8 ↗
我的解读预取在这些带宽和形状上能隐藏传输;更快内核、更低PCIe带宽或多任务争用可能暴露瓶颈。
来源证据PISA原内核不能在HY3D-Internal高效运行,论文用相同密度的Sol-Attn内核估算其去噪速度上界,标为小于1.87倍。 附录A.1 ↗
我的解读这是估算上界而非实测失败或完整基线吞吐;评述应保留该条件。
开放情况与使用许可
2026-10-11核对dodododddo/mcsparse的master提交880f4859faf3621e70ec736546d9839420b76ab4,实际含CuTeDSL token稀疏内核、Fast PDDP、MiniMax-H3集成、CLI和测试。README当前只支持NVIDIA Hopper;公开内容不是论文全部模型集成,HY3D-Internal权重与完整3D复现流程未核实公开。
LICENSE论文与图6CC BY 4.0;仓库Apache 2.0,FA4与CUTLASS派生文件保留BSD 3-Clause通知。基础生成模型权重各有独立许可,内核许可不覆盖内部3D模型。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
逐步消融显示精确选择、token粒度、查询分组和残差补偿都有增益;相同实际执行密度避免把填充开销藏在名义稀疏率里。
内部3D模型15%密度时去噪加速2.32倍,与密集输出F1(阈值0.001)为96.33,表明该配置中较好保留几何。
反方 · 哪些结论还不够
3D参考是同一模型的密集结果;接近原输出不证明更真实,也没有材质和拓扑质量的独立完整验收。
PISA在内部3D模型上的速度是用另一内核估算的上界,非直接实测;视频每任务50样本,3D样本数未充分披露。
只把计算内核4.79倍速度或15%交互比例当成整系统速度,会忽略锚点、分组、搬运、条件编码和解码。
综合判断
这是一种有充分误差拆解和工程实现的注意力近似方法,适合关注3D生成成本的人跟踪。公开代码足以检查机制,但2.32倍内部模型结果的完整复现条件仍不齐备。
我会先做的验证
建议实验,未执行:在可公开复现的3D骨干上固定图像、种子、采样器和硬件,扫描锚点频率与实际密度;同时报告端到端时间、显存/CPU缓存、薄结构连通性和对真实几何的误差。再加入纹理模块验证速度收益能否保留到GLB/PBR导出。