MegaParts补收:给不同部件不同数量的形状token
最多300部件的结构生成,仍需长时间解码和后续材质、关节处理
MegaParts以可截断的因果VQ形状表示压缩部件,再按全局布局、部件包围盒和局部形状顺序生成组装体。8月14日首发,今天补收;它让数百可寻址部件进入单一序列,但部件分开并不自动带来语义关节、UV、PBR或实时资产生成。
图解主要方法
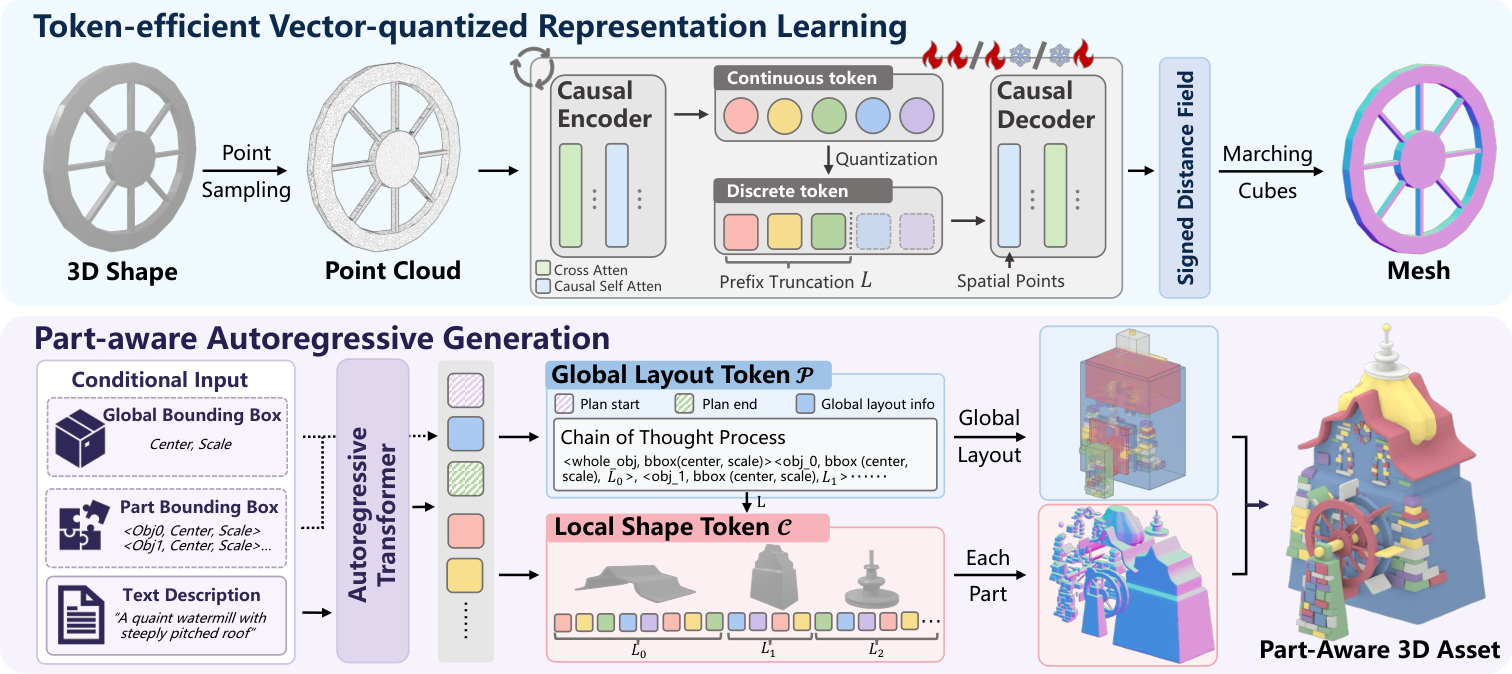
图2的前缀形状编码与全局布局序列如何分工,token节省到底发生在哪个阶段?
- 1
训练任意前缀可解码的形状表示
因果VQ编码器和解码器以16至4096的前缀长度重建部件,随机截断迫使前部token先保存主要结构。模型从Cube初始化,结合分阶段冻结、最优传输及采样策略,避免短前缀和完整重建相互破坏。
- 2
离线按几何误差选择部件长度
对九种长度评Chamfer、法线和包围盒失真,加token率惩罚决定每个训练部件预算。约1.8秒每部件的率失真搜索发生在数据准备,不是生成时对每个候选都重新完整搜索。复杂部件得到更多表示容量。
- 3
先生成整体布局,再逐件生成形状
扩展Qwen3-8B词表,先输出全局盒、各部件盒和长度计划,再串行生成局部形状token;解码SDF经marching cubes得到局部网格,按最大盒边等比缩放并平移组装。布局坐标提供控制,但不保证无穿插或机械连接。
- 4
逐级扩大上下文并保留独立部件
训练上下文32k→128k→256k,约44万资产含34万公开、10万私有来源,约千万部件。连通分量不等于语义部件;独立网格便于选择编辑,却没有自动补齐UV、材质图、质量属性或可执行关节约束。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【生成质量】PartObjTiny法线图FID43.40,对文本TRELLIS为54.81,CLIP约0.27对0.25。 主生成表与评价协议 ↗
我的解读我的解读:这是几何/法线渲染评测,不能解释为纹理或PBR质量领先;输入条件与辅助信息也需区分。
来源证据【规模与失败】单A80080GB的200–300部件组成功率0.77,低部件组约0.99;部分质量指标仅统计成功样本。 高部件规模与内存附录 ↗
我的解读我的解读:“支持300部件”不代表每次都能成功,OOM或长度上限必须计入交付率。
来源证据【真实耗时】高部件组朴素AR生成6735秒、几何解码1076秒,合计约130分钟;300部件示例188k token、峰值71.24GB。 推理效率、长序列示例与附录 ↗
我的解读我的解读:长序列吞吐仍是瓶颈;优化解码能加速,但不能把300部件示例当实时生成能力。
开放情况与使用许可
项目页链接到MeshCoder仓库;实际README明确MegaParts代码将来在此发布,现有训练推理实现主要属于2025年MeshCoder,不能当作MegaParts已开源。未核实MegaParts检查点或完整训练集。
LICENSE共享仓库现有MeshCoder代码为MIT,但不据此推断尚未发布的MegaParts权重及数据许可;本论文图2为CC BY 4.0。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把部件复杂度与token预算对应,扩大显式多部件生成规模,并保留局部寻址和布局控制。
反方 · 哪些结论还不够
长串行解码、失败样本排除、私有训练资产及缺失材质关节管线,限制可复现性和生产即用性。
综合判断
适合作为大型部件组装的几何生成前端;后续仍需语义清理、连接检查、UV/PBR与关节资产工程。
我会先做的验证
未执行的验证方案:按部件数分桶固定总时限,与统一token和分件生成后组装比较;把失败计入均值,测部件语义一致、穿插、薄结构、编辑局部性以及补UV材质和关节所需人工时间。