MeshMosaic:用边界条件拼出高面数艺术网格
基础研究回顾:局部分块提高细节,十万面仍可能需要数小时
MeshMosaic将参考形状拆成局部片,逐片生成三角网格,并用已生成边界和全局点云协调拼接。局部量化让细节不受整物体同一网格精度限制,能够扩展到十万面以上;它输出几何,不能自动代表带UV、材质和绑定的生产资产。
图解主要方法
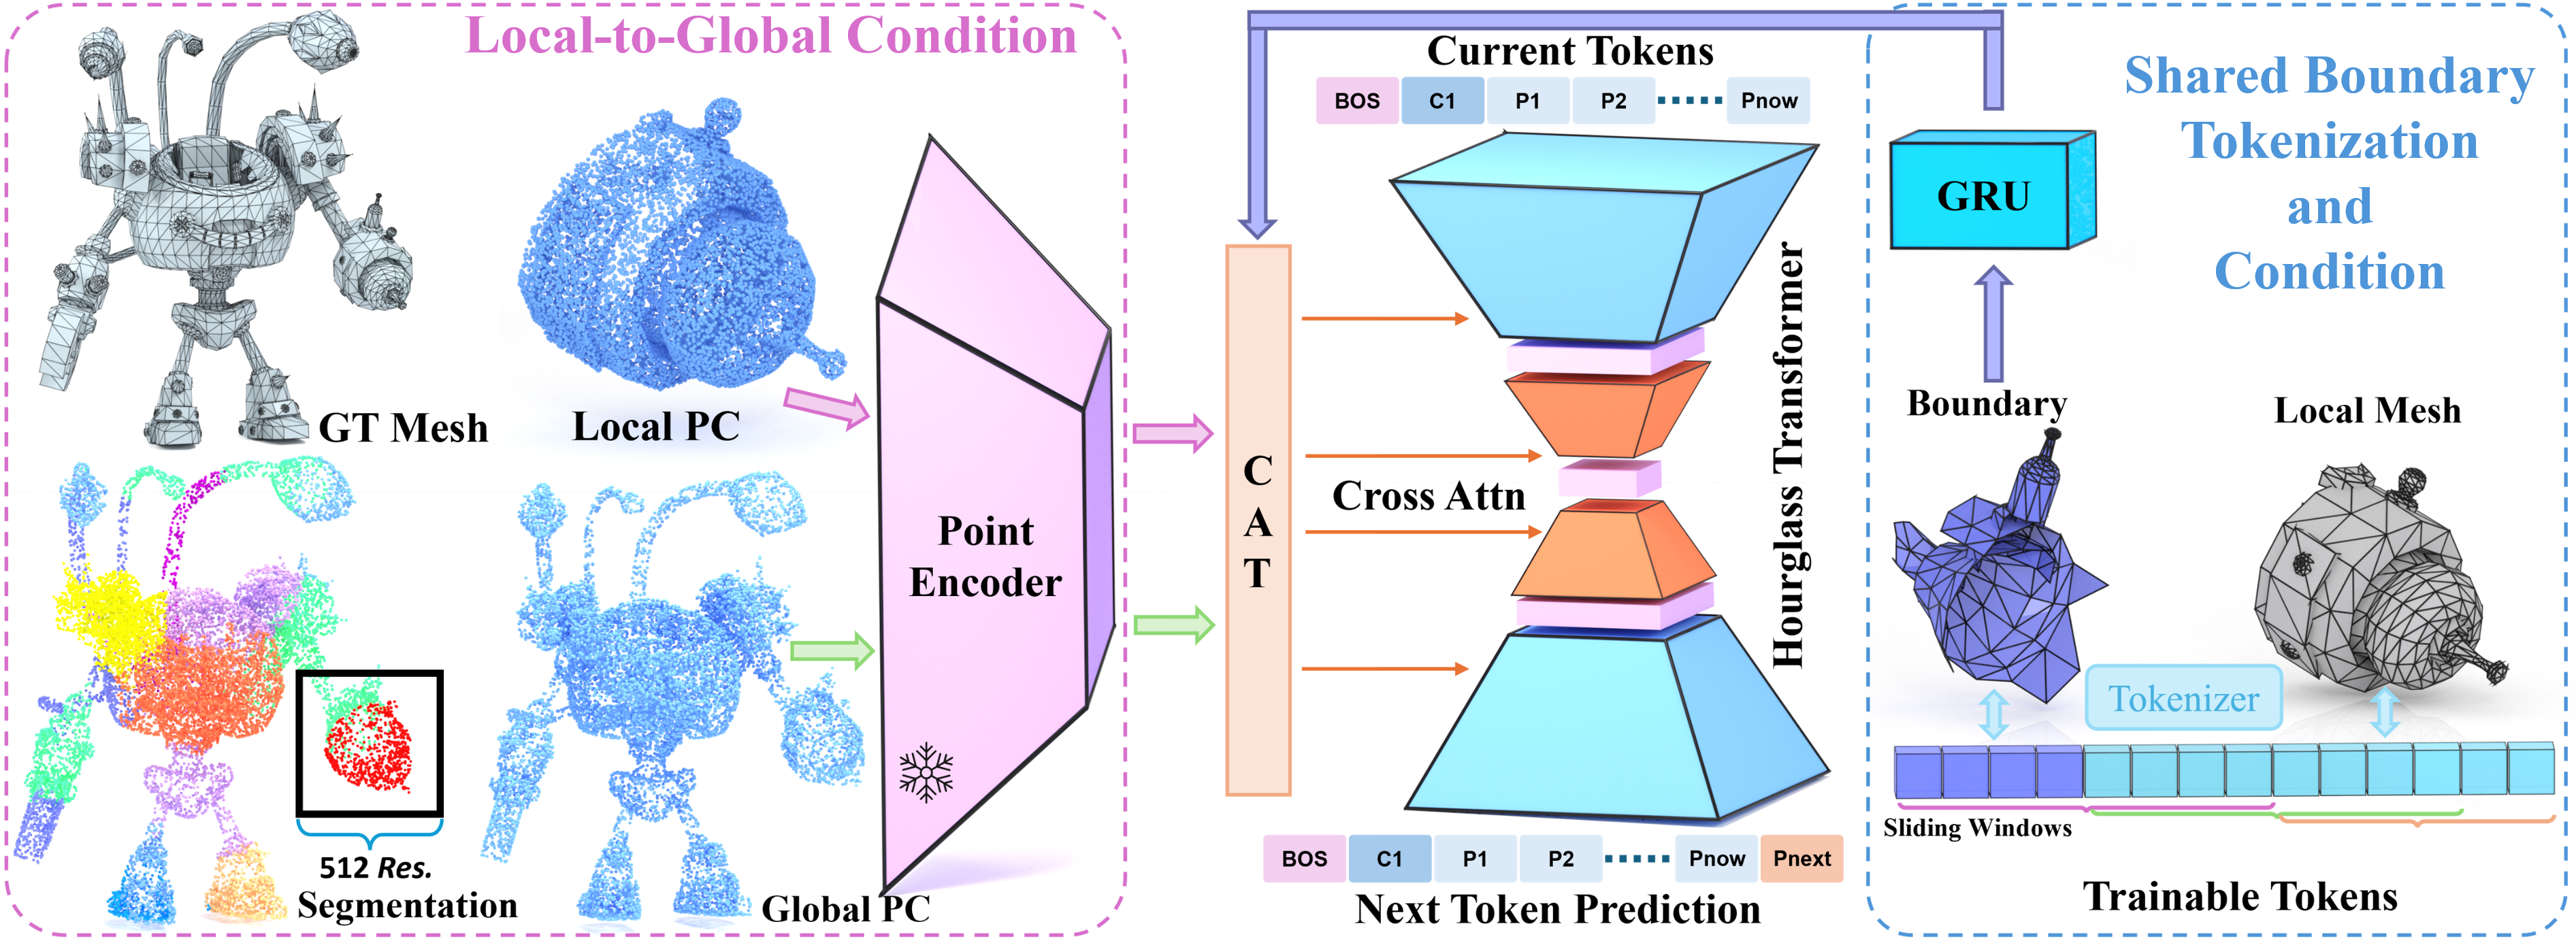
图 7 中局部点云、全局点云和两种边界条件为什么都需要?
- 1
先分块并确定生成顺序
整体流程用PartField语义分块,按从最低位置开始的BFS顺序生成,使新块通常邻接已有块。训练主要随机Voronoi分块,另用连通组件子集,避免昂贵语义标注限制多样性;推理分块也会影响拓扑整洁度。
- 2
同时读取局部形状与全局结构
图7左侧冻结Michelangelo编码当前块和完整形状的点云,拼成条件。每块都用16384点并独立缩放至512³量化,所以全模型有效分辨率和总条件信息都变多,不能把收益只归于网络结构。
- 3
把已有边界以两条路径传入
图右选择已有块最近的最多512个三角形,编码为边界token;GRU把它们压成条件,同时原边界token作为自注意力前缀,配合hourglass自回归模型生成当前块。第一块用终止符占位,后续才能传递实际边界。
- 4
补偿量化位移再拼接
独立量化可能让共享边界发生轻微平移,方法用参考边界与原位置之间的位移补偿当前块并复用边界三角形。局部连续不等于远处对称、无自交、适合变形绑定;论文也展示双臂轻微不对称失败。
实验与证据
以下为作者报告;已阅读 v2 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【数据与规模】0.5B DeepMesh基础、310K训练网格,训练输入500–32000面,32张H20约七天;可推理超过100K面。 实现与附录 A.1 ↗
我的解读我的解读:局部生成可跨越训练时整物体面数上限,但不是零成本扩展;点云采样总量与生成token都随块数增长。
来源证据【几何评估】ShapeNet、Thingi10K、Objaverse各100对象;后两集明显改善,ShapeNet中BPT的HD0.017优于本法0.037,部分距离指标也更好。 表 1 ↗
我的解读我的解读:细节和F1优势不代表所有几何距离占优;需按目标资产选择面数、边缘与最坏误差指标。
来源证据【编辑与效率】27位专业参与者对10模型按前3名打分,本法偏好领先;每token约0.024s,但>100K面复杂网格需要数小时。 表 2、附录运行时与局限 ↗
我的解读我的解读:视觉整洁偏好不是实际编辑、绑定或减面耗时;每token接近基线不能推导总生成时间同样快。
开放情况与使用许可
2025-09-24 首发,v2全文与附录回顾补收。已核实推理脚本、模型代码及HF final.bin;README仍列数据预处理和训练代码待发布。
LICENSE仓库根LICENSE为AGPL-3.0;HF检查点卡标MIT,上游组件另有许可。原论文图7为CC BY-NC-SA 4.0;这些范围不可相互替代。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把长序列分解成可控片段,并显式传递边界条件,使局部精度与跨块连贯性能够共同建模。
反方 · 哪些结论还不够
总推理慢、远处对称弱,分块质量影响结果;三角网格精细不意味着可直接用于动画、UV或PBR生产。
综合判断
适合离线高细节网格重建与再网格化研究,生产使用需要再验收拓扑、接缝、UV和部件编辑成本。
我会先做的验证
未执行的验证方案:固定点云采样总预算和输出面数,比较整形状生成、独立分块、边界GRU/前缀两种消融;测裂缝、非流形、自交、对称误差、UV展开失败率及完整GPU时间。