MeshOctave:按空间分辨率分裂顶点、重连网格
层内并行的原生拓扑生成,连接矩阵仍有短程自回归
MeshOctave不按一次边坍缩定义一个生成步骤,而把空间网格分辨率逐次减半建立确定层级。逆过程对每个父面预测子顶点占据与内外连接,再用掩码提案和均匀噪声修正迭代生成下一层。这样能够并行细化层内各面,但逐层依赖和局部连接解码仍存在,粗拓扑错误也无法回退。
图解主要方法
怎样让多尺度原生网格生成层内并行,又同时明确子顶点与连接?
- 1
按网格分辨率坍缩
同一粗体素的细顶点合并、继承连接、去重面但保留退化面,直到单体素。层级由原网格与空间网格确定,不依赖边坍缩调度。
- 2
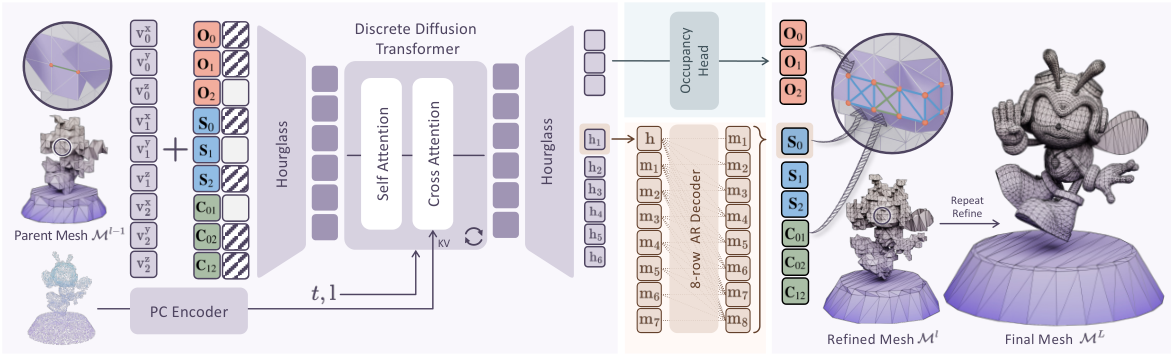
以九个结构槽逆向细化
每父面三顶点各有8位子体素占据,另有三内部和三跨父顶点8×8邻接矩阵;绝对八分体索引,解码用占据屏蔽无效边。悬边(A,B,B)与孤点(A,A,A)暂留退化面供下层继续细化。
- 3
用尺度条件Transformer预测
九槽与父坐标嵌入相加,hourglass按9/3/1面token压缩展开,时间与尺度adaLN、点云交叉注意力和顶点锚定3D RoPE。占据为256分类,邻接矩阵八行仍用小自回归MLP。
- 4
交替提案与修正
掩码路径只监督被遮槽,均匀噪声路径监督全部槽,以focal loss应对约92%空邻接行;置信头对主干停止梯度,并混入模型自生成错误。
- 5
逐层执行可反复改写的去噪
算法2每轮覆盖全部槽,再均匀修正,按置信度和0.2→0.9调度重新遮挡;并非揭开后永久冻结。每层20步,10层到1024³,层内并行但跨层顺序。
实验与证据
全文60610字符及附录A.1–A.7、算法1/2读完;v2正文与v1差分仅标点;原图3视觉核验,实际检查项目与GitHub内容。
来源证据35万网格,最高15000面、135000槽,8张H800 80GB训练七天;624M主干另加193M点云编码器。 4.2 ↗
我的解读模型与条件编码器都应计成本,不能只报主干。
来源证据500个测试网格:300个ObjaverseXL/Toys4K和200个模型生成;每对采4096表面点。CD-L2 0.0392对LATO.2 0.0406,HD0.0645对0.0665,绝对NC0.8478对0.8333。 表2;第5节 ↗
我的解读有几何优势但没有区间;绝对法线一致性不检测所有方向与流形错误。
来源证据消融全模型CD-L2 0.0430,连续0.0512、无Uniform0.0453、无AR头0.0496、无3D RoPE0.0469。 表3 ↗
我的解读消融Full与主表0.0392不同,应按各自表内比较,不混成同一实验数值。
来源证据约8秒/尺度、十尺度约90秒;选定自回归5000面约15分钟。 5.1;附录A.7 ↗
我的解读层数少于面数顺序步骤,但每层token与注意力仍随复杂度增加,不能解释为渐近计算量恒定。
来源证据5000–10000面基线未在此范围训练,虚线仅测到该面数的耗时,不验证输出有效;作者方法各面数箱有实际样本。 附录A.7 ↗
我的解读高面数速度对比不是同等质量可用资产的对照。
来源证据粗网格采点后无需重训即可细化并改变局部拓扑。 5.4 ↗
我的解读这是几何编辑能力展示,未证明UV/绑定可继承,也无量化材质与重光照结果。
开放情况与使用许可
GitHub MayMhappy/MeshOctave实际仅README和assets,无训练/推理实现、权重或LICENSE;项目页的Code按钮不构成代码已开源。
LICENSE论文arXiv非独占托管许可;图3必要评论署名引用;仓库与权重未核实开放许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
确定的网格坍缩和逐面结构token,清楚分离尺度与顺序操作。
同一模型比较无均匀修正、无连接自回归、1D位置编码等消融,支持各部件作用。
反方 · 哪些结论还不够
主表优势主要是几何指标,不能直接推出拓扑有效率或艺术家可用性领先。
基线VertexRegen与ARMesh重训用20万、低于5000面的网格五天,主模型35万、最高15000面七天,数据算力未严格匹配。
约90秒对15分钟是选定自回归比较,超过5000面基线仅计解码耗时且输出有效性未验证;不能称全部方法十倍加速。
综合判断
提供了可信的按空间尺度并行建网格方案,证据支持几何重建与层级控制;完整资产可用性、拓扑保证及公平计算预算下的优势仍需验证。
我会先做的验证
建议实验(尚未执行):统一训练集合、面数和GPU预算,按复杂度报告延迟/显存、流形率、自交和空洞;加入UV与绑定继承、LOD切换误差及人工修复工时,不只看Chamfer。