MHWA:用慢上下文与稀疏专家缓解世界模型漂移
世界模型的层级结构什么时候有用,什么时候只是增加复杂性?
MHWA保留JOWA的视觉token和离线价值学习接口,在上层按步长取样上下文、下层按当前状态动态路由专家。三种子匹配实验支持其在14款Atari上的效率与成绩优势,但长程稳定性只测到50步外推,也没有验证真实连续控制。
图解主要方法
世界模型的层级结构什么时候有用,什么时候只是增加复杂性?
- 1
把层级定义在交错token流
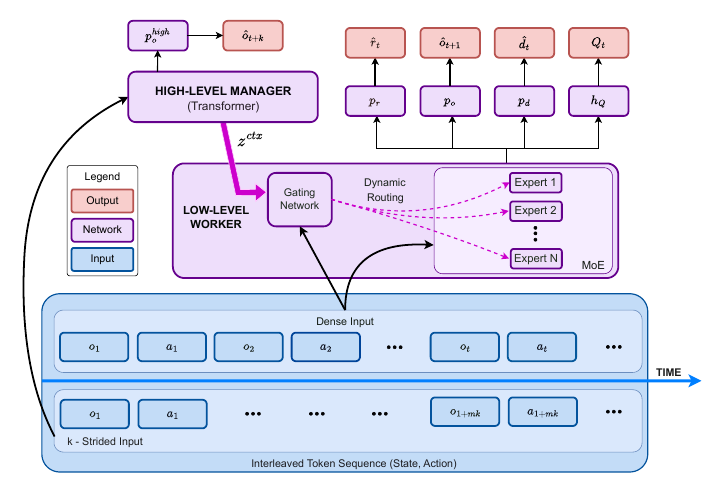
每帧36个VQ-VAE视觉码加1个动作码,8帧构成296token上下文。上层每隔4个token取样,并预测下一采样位置;这是token级步长,不是每4个完整环境帧才决策。
- 2
隔离上层梯度,广播慢上下文
上层4层Transformer的隐藏状态先stop-gradient,再经可训练投影器广播。低层损失训练投影器、路由器和工作层,不直接改上层;上层由跨步预测辅助目标训练,避免被即时重建误差牵引。
- 3
让专家选择同时看上下文与当前状态
下层4层Transformer用4专家Top-2替换FFN,门控拼接当前token与上层上下文。上下文在窗口内固定,但路由每token变化,保持局部反应;不丢弃超容量token。
- 4
联合学转移、结果和离线价值
观测、奖励、终止用预测损失,Q头用分布式TD与CQL,另加跨步损失和专家负载正则。论文用硬选择频率写KL正则,实际可微梯度实现仍需代码确认,不能只由公式推定训练细节完整。
实验与证据
已阅读正文1–5和附录A–H,包括逐种子结果、全部消融、条件性误差推导,核对实验条件与原图;未独立复现。
来源证据MHWA 77.27M参数的seed-by-game IQM为0.884,95%区间0.736–1.031;重训JOWA70M为0.529,区间0.459–0.602。表1的0.867是先算每种子IQM再取平均。 表2、附录D:匹配三种子、14游戏 ↗
我的解读两种聚合口径不同,不是冲突。JOWA150M的0.833来自已发表结果,没有同条件新置信区间,不能称统计显著超过它。
来源证据每序列48.199 GFLOPs,对比70M84.238和150M165.524;训练两张A40共21.6 GPU天,batch1024、0.875M步以匹配token曝光。 附录B:统一输入的训练计算量 ↗
我的解读70.88%节省是相对150M的前向加反向FLOPs,不是等比例墙钟时间或推理延迟节省;batch与步数变化也会影响优化。
来源证据完整IQM0.564,无Manager0.445,无MoE0.450,无当前状态0.359,步长1为0.214;有辅助目标时去stop-gradient降至0.533。 表3–4、附录F:44M六游戏消融 ↗
我的解读控制容量支持组合设计,但子集消融不能直接外推14游戏全部效果。没有辅助目标时固定权重Manager仍提供依赖轨迹的特征,不等于移除了层级。
来源证据五个未见游戏各用5000专家转移微调,IQM DNS0.643±0.007;固定数据动作下从4帧滚至第54帧,仍最终偏离数据流形。 附录E、G:迁移与长程预测 ↗
我的解读这是少样本微调,不是零样本迁移;像素稳定性不等于规划安全,Robotank等任务仍弱于参考模型。
开放情况与使用许可
论文CC BY 4.0;附录称补充代码将提供获取说明,但当前全文未发现可核实发布仓库,不标实现开源。数据和tokenizer沿用上游条款。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
提供匹配70M重训、多种子区间与较完整层级消融,能具体讨论架构偏置如何补偿参数规模。
反方 · 哪些结论还不够
只验证离散动作Atari,复用预训练tokenizer且保留任务标识;理论要求慢上下文误差加窗口漂移不超过平坦模型误差,是条件性解释而非普遍保证。负载正则的可微实现与完整代码尚待核对。
综合判断
有价值的世界模型架构实验,适合研究token序列上的慢快分工;当前证据不足以宣称通用长期物理一致性。
我会先做的验证
未执行的验证方案:复现相同token曝光和墙钟预算对照,逐游戏记录长滚动误差与价值偏差;对突变动力学、连续动作和无任务标识环境测步长失效点,并核查路由正则梯度。