MIST:物体没有被重新展示,不能先怪视频模型忘记了
把布置、遮挡泄漏、揭示动作与物体匹配分开评分。
视频记忆测试常把开盖失败和物体遗忘混成一个错误。MIST将它们拆开,M3-Agent只改当前失败动作的提示。主要结果揭示了评测瓶颈,同时也提醒:带答案改提示、用最终评分择优,不能证明模型真正记住了对象。
图解主要方法
把布置、遮挡泄漏、揭示动作与物体匹配分开评分。
- 1
将记忆任务拆成可观察条件
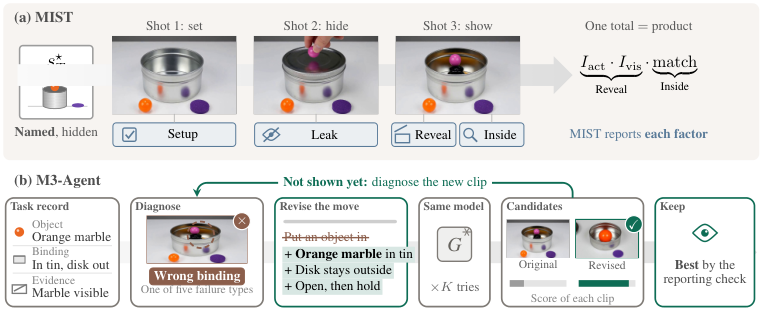
图3上排先建立对象,再遮挡,最后重新展示。分别检查初始布置、隐藏阶段是否泄漏、揭示是否执行,以及显示内容是否匹配;若盖子从未打开,就没有足够证据判断内部对象记忆。
- 2
诊断失败动作而非重写全部场景
M3-Agent读取生成末帧和任务记录,指出错误绑定、开盖不足等问题,只改失败动作,并在同一冻结生成器上采样。MIST主要设定保留前两段,只调整第三段,从而减少前置场景变化。
- 3
明确候选选择使用了什么信息
图3下排同时保留原视频与改写候选,按报告用评分选最优。这是oracle keep-best而非已部署的盲评选择器;答案进入提示、分项分别取优和选单条完整视频必须分开报告。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据41例基线没有开盖;保留结果的reveal从0.147到0.492,setup约0.852到0.851。 MIST:43例、3段各5秒、Wan2.2-TI2V-5B ↗
我的解读主要是执行可见性改善,不能用reveal直接代表记忆准确。
来源证据best-of-5可到0.763但使用答案提示;answer-only为0.684,无答案改写0.174低于通用开盖提示0.268。 改写与选择消融 ↗
我的解读帮助来自多种信息和采样因素,不能全部归因智能体理解隐藏状态。
来源证据WRBench40例T为0.452到0.570;MBench-T30例分项U为0.292到0.446,单条视频为0.443,23例仍保留基线。 跨基准与盲选择 ↗
我的解读盲8B末帧选择没有可靠区间收益证据;不同生成器的主要失败模式也不同,需报告每个门槛。
开放情况与使用许可
官方仓库存在videomist实现、脚本和测试,但README明确“无公共许可证”;因此记作代码可见、许可未开放。HF数据页存在,数据及生成器应分别核对使用范围。
LICENSE论文 CC BY 4.0;代码未附公共许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把未发生的揭示动作与记忆错误分开,能避免在错误问题上优化世界模型。
反方 · 哪些结论还不够
样本有限、部分评估利用答案或最终评分,缺少足够人工验证;高揭示率并不建立隐状态持久性。
综合判断
最值得采用的是诊断协议,自动修复的部署收益仍需盲测。
我会先做的验证
未执行的验证方案:隐藏真实答案,对所有方法固定采样数,以独立人工裁判评判完整单条视频;同时报告布置、泄漏、揭示和匹配的联合通过率。