MLE-World:先预测程序运行结果,再决定是否真跑
语言形式的执行世界模型,何时能省掉昂贵的机器学习试验?
MLE-World 将Python程序、环境和预算映射成异常、终端输出与验证指标,作为机器学习智能体的执行预测器。它属于程序环境世界模型,不是物理视频生成;代理仍需真实执行候选来确认结果。
图解主要方法
语言形式的执行世界模型,何时能省掉昂贵的机器学习试验?
- 1
先学习带结果的执行转移
Qwen3.5-4B在497056条程序执行记录上监督微调。输出先给82类异常token,再给终端输出、指标及提交文件状态;首token概率被用作粗置信度,并非已校准的正确概率。
- 2
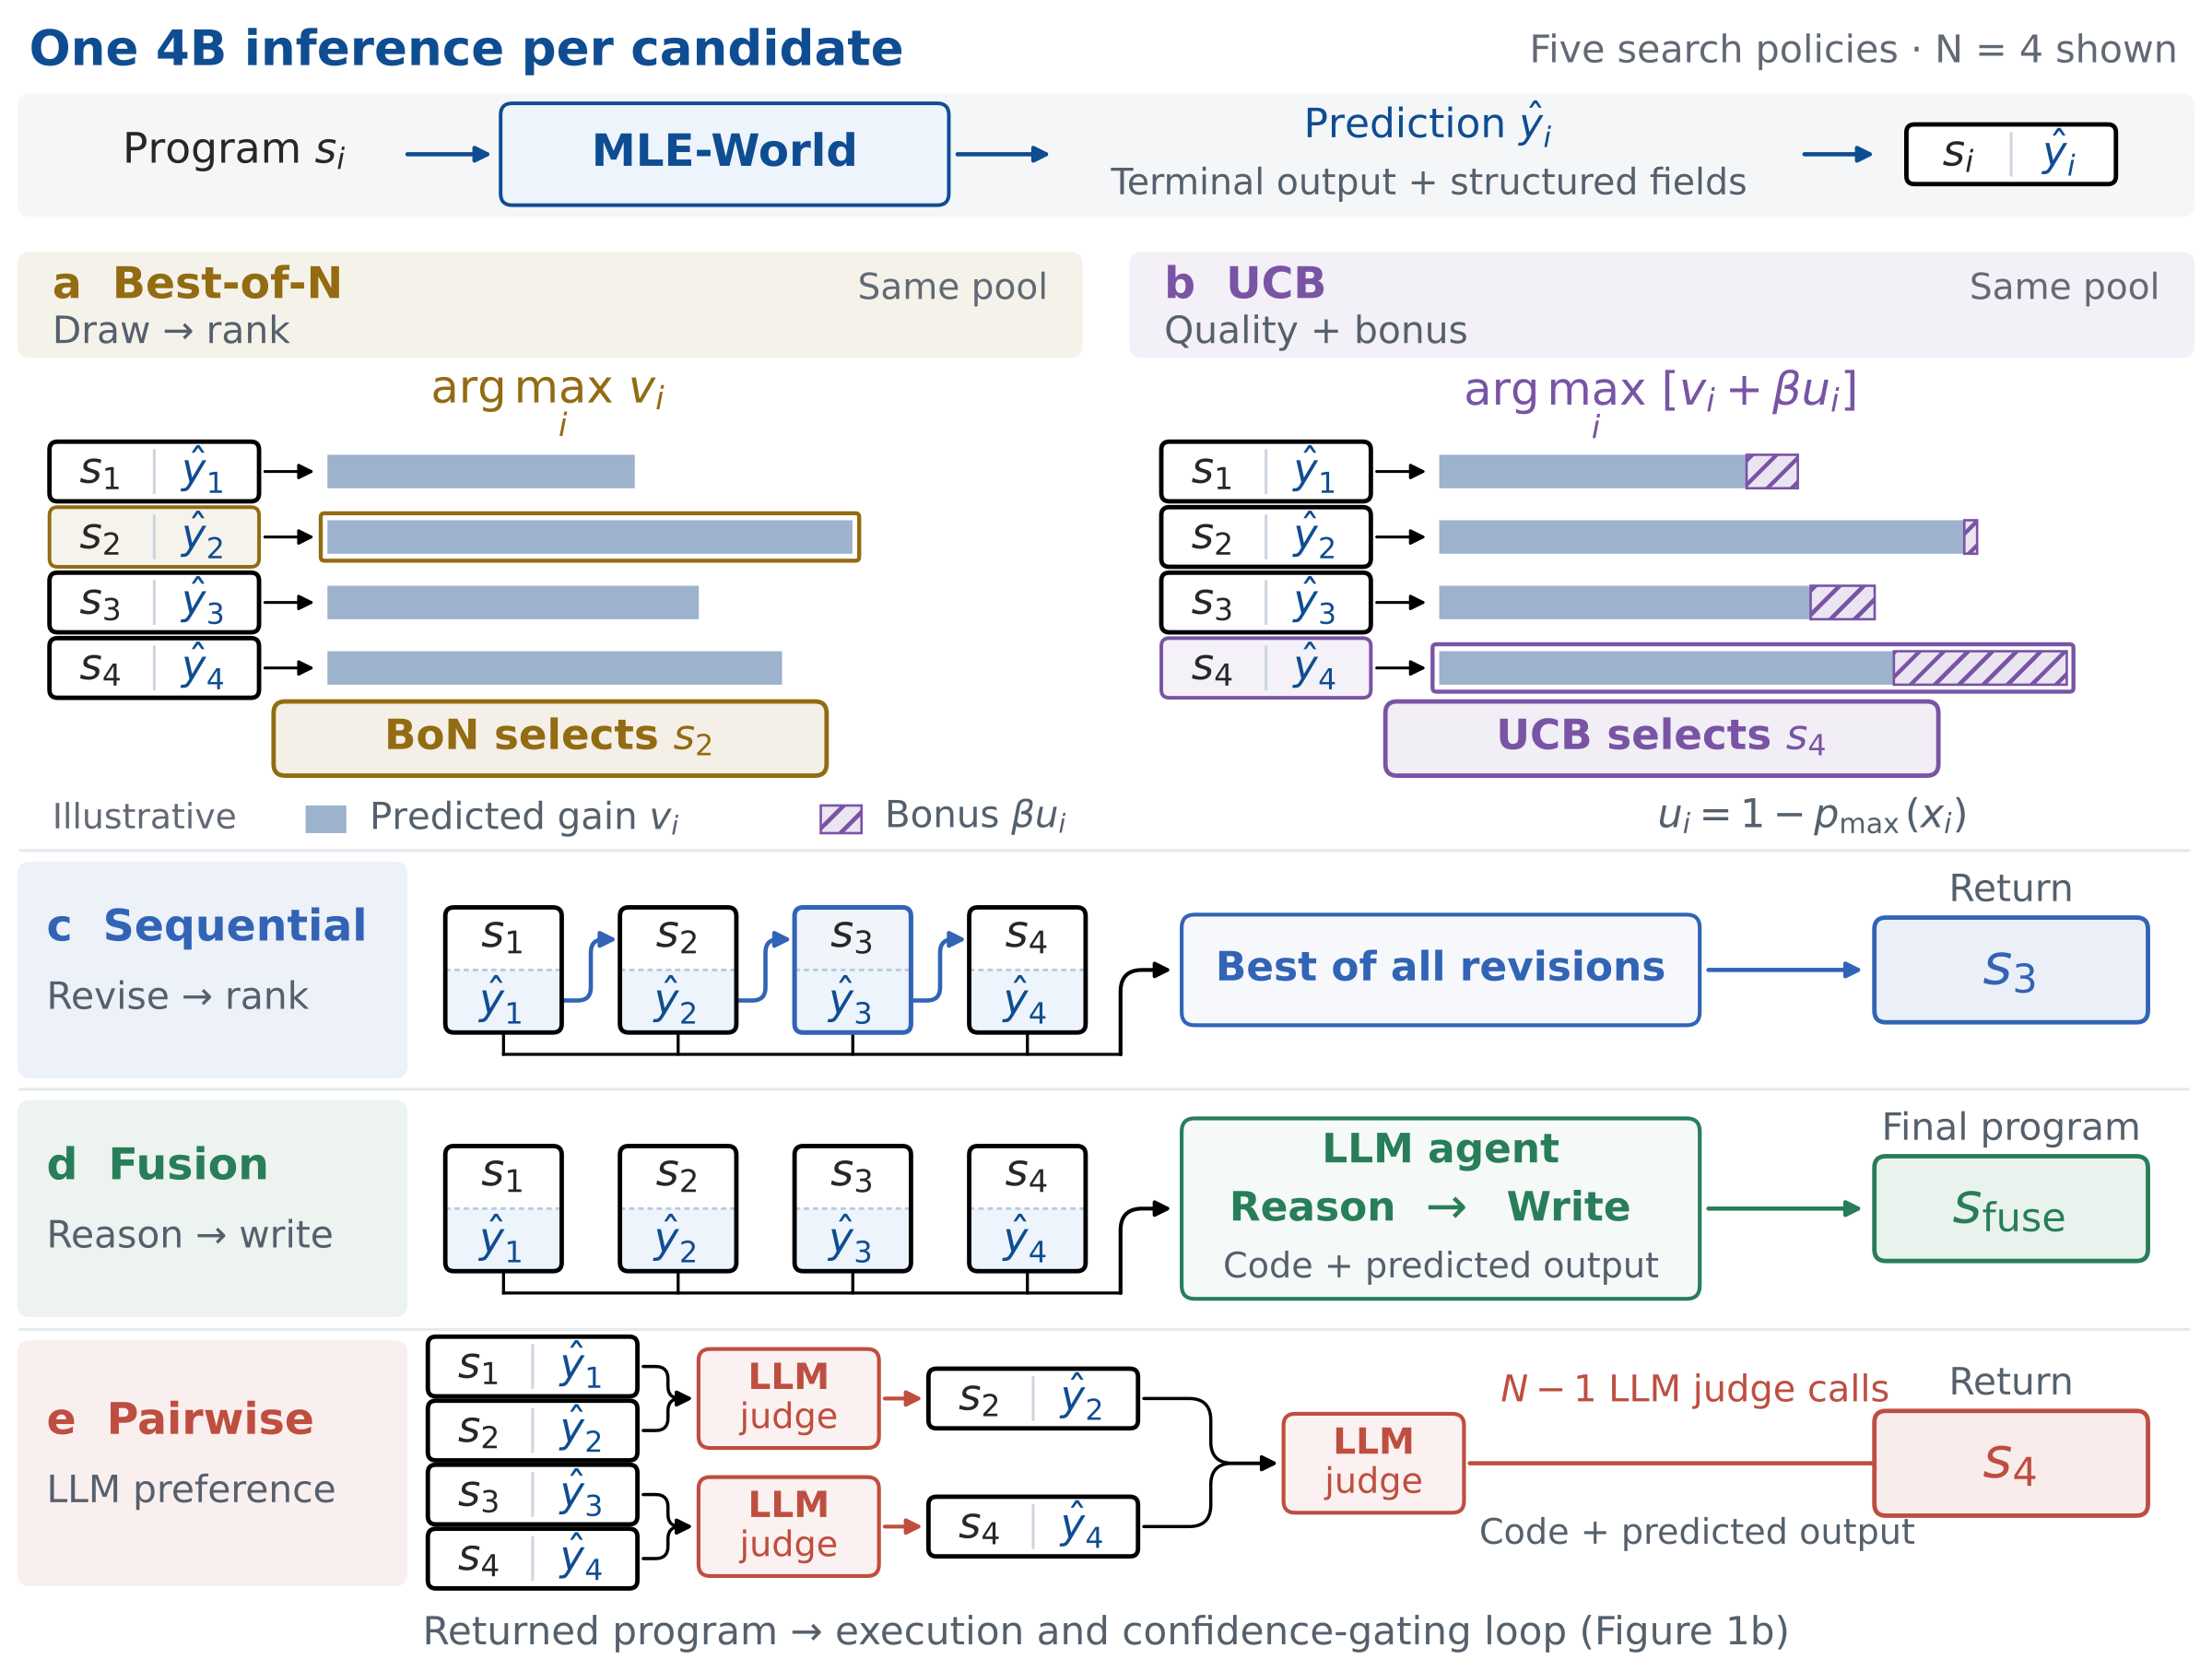
图2:用同一预测器比较五种搜索
Best-of-N按预测指标排序;UCB加上不确定性奖励;还比较逐次修改、两两比较与融合。图中UCB奖励是经验探索机制,不能宣称拥有一般多臂赌博机遗憾界。
- 3
只跳过合适的执行,最佳候选仍实跑
低置信或信息缺失就调用真实环境,新预测最佳指标必须执行确认;预测超时则跳过。成功和失败采用不同阈值,开发集调阈值与最终评测须分开。
实验与证据
已阅读全文正文与附录M门控阈值选择,核对实验条件与原图;未独立复现。
来源证据1700条程序留出样本与训练不重复,但来自相同17任务;终端结果准确率77.9%,提示式DeepSeek对照41.1%。三种子、12小时搜索中AIDE平均百分位45.4,门控Sequential55.4。 正文实验:17个MLE-bench任务 ↗
我的解读55.4比45.4是+10个百分点或约22.1%相对提升,不是增加22.1个百分点;主要结果不是任务级完全未见泛化。
来源证据门控可减少约30%—40%真实执行时间,但UCB平均百分位也可能从52.1退到51.1;阈值在相同17任务的3小时开发运行选择。 执行成本与附录M ↗
我的解读节省执行时间不等于同幅度节省总GPU成本,尚有模型推理与近50万条数据收集成本;12小时UCB阈值改动使该比较仅具描述性。
开放情况与使用许可
官方仓库有agents、运行脚本和MIT许可;模型卡标注Apache-2.0,数据卡提供Parquet路径但未明确统一数据许可。本文区分代码、模型卡声明与训练数据使用条件,未下载大权重独立复现。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
昂贵试错前先预测错误类型和可能收益,是让世界模型服务于软件研发的具体接口。
反方 · 哪些结论还不够
预测器易沿既有任务和环境分布过拟合;把真正有希望的程序误判超时会造成搜索盲点。三项新任务的额外测试不足以证明广泛泛化。
综合判断
适合固定环境里的执行筛选,跨数据集或库版本部署前必须重新校准并保留实跑审计。
我会先做的验证
未执行的验证方案:按任务整体留出训练数据,报告程序筛选的假阴性、错跳超时与总GPU小时;用随机门控作等成本对照。