Momentum:先让世界持续演化,再让相机进入
通过多相机参考状态协调时间与视角,避免每条相机轨迹各编一个未来。
Momentum 把世界更新与观察者画面分开:多组全景相机持续产生参考视频,目标相机从同一时刻的参考生成视图。这样多条观察轨迹共享一个动态背景,而非只依赖静态记忆。论文报告动态语义一致性相对翻倍,但绝对分仍低,且不等于物体身份或物理运动正确。
图解主要方法
通过多相机参考状态协调时间与视角,避免每条相机轨迹各编一个未来。
- 1
1 · 用空间相机图存放动态世界
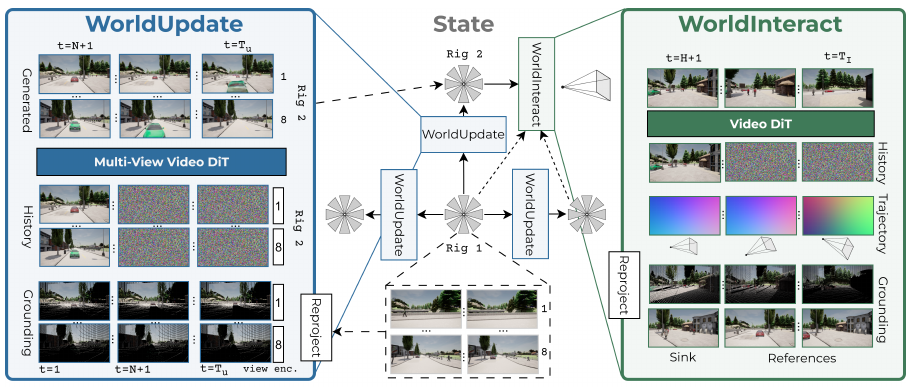
图2中间以多个rig为节点,每个rig有8个共位置、相隔45度的视角。世界状态是这些同步视频,不是显式刚体和动力学参数;不需逐物体跟踪,但也没有物体级守恒保证。
- 2
2 · WorldUpdate协调参考未来
图2左侧多视角DiT联合生成8路视频,利用深度反投影与邻接rig重投影作为几何条件。沿图分层传播,同层可并行;保持历史并用已有邻居的新帧提供跨节点一致性。训练底座为Cosmos Predict2.5-2B。
- 3
3 · WorldInteract响应相机轨迹
图2右侧把Plücker相机轨迹、时间对齐的重投影视频、语义参考和前瞻sink共同条件化目标生成。相同世界rollout可服务不同目标相机,因此世界变化与观察轨迹不必绑定。
- 4
4 · 区分生成参考与真值参考
组件实验可输入真值参考视频,用来测WorldInteract上限;端到端Momentum则从静态初始图像自行生成参考。测试中距离目标超过25米的rig暂停更新,这一工程约束限制了“全世界独立持续演化”的范围。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据CARLA 6城训练;30个已见城新路口及30个新城场景,生成30秒/300帧。动态SCS已见城0.086→0.198,新城0.084→0.190,相对分别130.2%与126.2%。 表4 · 端到端生成 ↗
我的解读相对提升来自低基数;仍约0.2,不能写成动态预测准确率翻倍。
来源证据SCS按SAM类别掩码并集IoU、2fps抽样,排除两边都空的帧;已见城平移误差0.060→0.080更差,新城0.048→0.040更好。 指标定义与位姿结果 ↗
我的解读语义重叠不测单个车辆身份或碰撞;位姿估计按短块归一化,不应解释为绝对米级定位精度。
来源证据冻结参考的对照可能在PSNR甚至动态语义分上更好,但运动量与真实视频的差距更大;论文同时报告静态程度差距。 附录静态退化诊断 ↗
我的解读单一一致性指标可能奖励少动;应同时测运动、身份和长期重访,不能只取最好一列。
开放情况与使用许可
论文全文及公开附录已核,作者写明模型和代码将公开;当前所核arXiv记录未提供可验证实现/权重链接,检索未找到可确认的官方发布,不把未来承诺记为已开源。
LICENSE论文与原图 CC BY 4.0;代码/权重尚未核实公开
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将“世界怎么变”与“相机看见什么”解耦,是持久世界模型可复用状态的重要设计。
反方 · 哪些结论还不够
训练主要合成驾驶场景;参考图规模、深度误差和25米激活策略限制外推。没有碰撞守恒或对象身份评测,公开视频的视觉一致性不足以证明可靠的交互动力学。
综合判断
支持共享动态参考改善多视角生成,但世界状态仍是生成视频,物理一致性需另验。
我会先做的验证
未执行的验证方案:让两相机在不同时间重访同一路口,统计车辆身份、速度连续性与碰撞;控制运动量后比较语义分,并移除25米冻结策略测误差和计算扩展。