OmniShowcase:把物体法线转台作为展示视频的几何条件
四张参考图能否让转动镜头中的物体保持同一结构?
OmniShowcase 用四视图重建的法线转台约束视频生成,减少物体在镜头转动时变形、长出多余部件的问题。它面向资产展示视频,输出并非可直接编辑的网格、UV或PBR材质包。
图解主要方法
四张参考图能否让转动镜头中的物体保持同一结构?
- 1
先合成保持主体的训练视频
从3D资产渲染主体和参考图,再用视频修补生成背景,保持主体像素。4千条视频来自2593资产;多道VLM筛选排除主体变化和不合理支撑,背景与主体的光传输仍不一定一致。
- 2
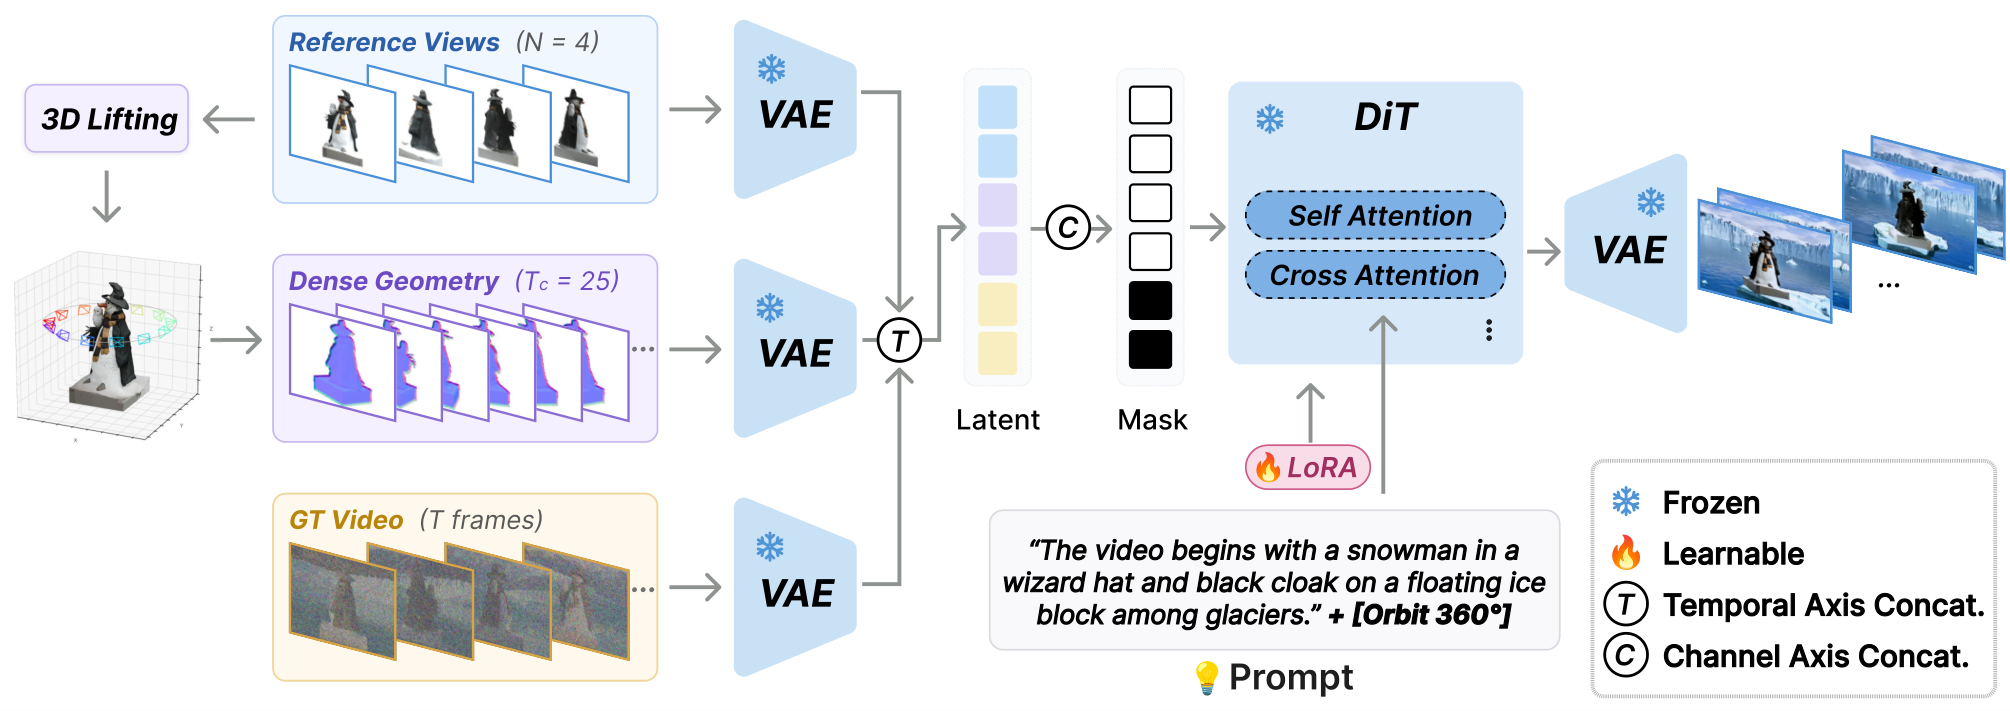
图4左侧:训练与推理都重建粗几何
从四张参考图估计点图并融合Gaussian,渲染25帧固定转台的深度再转换法线。训练不直接拿完美源网格当条件,因此避免把推理时拿不到的信息偷偷加入。
- 3
图4右侧:法线与目标视频是不同时间段
四参考图独立编码,25法线帧压成7latent,80目标帧压成20latent,合计31段沿时间轴拼接。条件保持干净,只对目标加噪并算流匹配损失;法线转台与目标镜头不逐帧对齐,镜头轨迹仍靠文字要求。
实验与证据
已阅读全文正文与附录C实现、G数据、H失败分析,核对实验条件与原图;未独立复现。
来源证据Wan2.1 I2V-14B冻结基座、rank128 LoRA,4张B200训练33000步约50小时。50个未见合成主体与35个NAVI真实主体上,GT-CD分别.0824/.0975,优于对照;所有主对照用相同四张参考图。 表2及附录C ↗
我的解读GT-CD先独立居中、半径归一化、刚体ICP并移除最外3%点,不是原尺度工程尺寸误差。
来源证据去掉法线条件,合成集GT-CD从.0824恶化至.2092;但审美分.574低于MAGREF-MV的.614。非刚体参考会融合成错误静态姿态。 表3与失败分析 ↗
我的解读几何约束带来一致性收益,未解决背景材质、光照交互和动态物体;不能把所有视频质量维度都写成领先。
开放情况与使用许可
作者仓库目前只有README与assets,训练数据、基准、推理代码、训练代码清单均待发布;项目页宣传不能替代实际文件。原图论文CC BY 4.0,数据资产各有许可,不能统一推定可商业使用。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
对商品或游戏资产展示,先重建再生成比仅靠参考图相似度更能约束背面和转动过程中的形状。
反方 · 哪些结论还不够
仍依赖参考视图覆盖与重建质量;不能输出有部件层级、UV接缝控制、去光照反照率或可重光照PBR贴图的最终资产。训练资产含非商业和相同方式共享条款。
综合判断
是几何辅助视频展示的有效候选,不是通用3D资产生成器。
我会先做的验证
未执行的验证方案:在带镜面、透明材质和可动部件的资产上,固定镜头与参考数量,评估几何一致性、文字轨迹遵从及独立照明下的外观稳定性。