OuroReward:几何和纹理奖励互相牵制时,先决定优化顺序
依赖图调度与动态提示选择有互补收益,模型引用和成本披露仍有缺口
OuroReward不在每一步平均所有三维质量奖励,而用短预热估计奖励之间的有向依赖,选择兼容性最高的环,再展开为一次顺序优化。配套AdaSelect从提示池中挑选与当前能力相近、组内结果有区分度且较少被重复选中的样本。
图解主要方法
多种三维质量奖励发生干扰时,能否通过优化次序而非同时加权改善训练?
- 1
AdaSelect先用轻量采样筛提示
每5个RL步从8000训练提示随机抽800个候选,以半数采样步、半组大小、半渲染分辨率和视角数生成结果。能力分取奖励向量接近当前均值的程度,区分分取组内奖励标准差,再加方向相似和低重复频率,选200个供接下来训练。
- 2
预热估计奖励的有向依赖
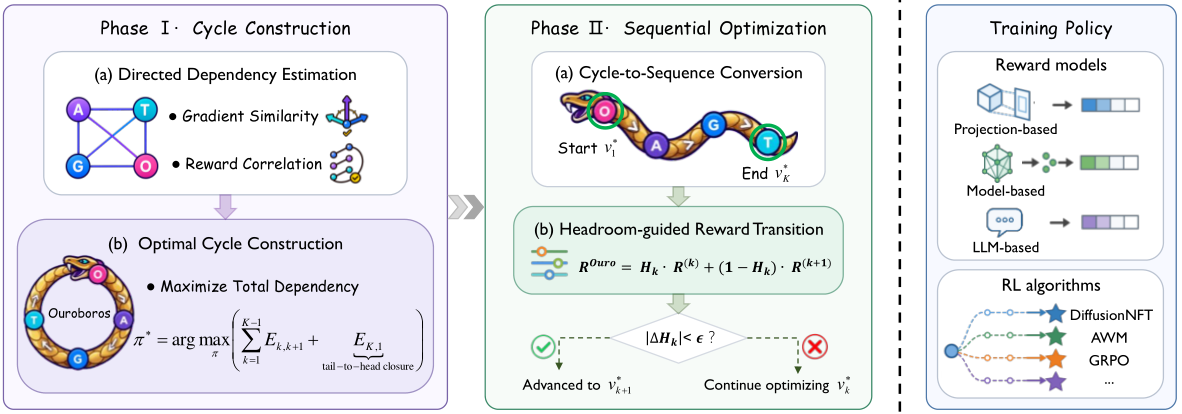
图4左侧对对齐、几何、纹理、总体质量各从同一起点独立优化5步,记录梯度余弦和验证集奖励变化相关。虽然余弦本身对称,在不同奖励引导的轨迹上估计会得到不同有向边;它是经验依赖,不是因果或无干扰证明。
- 3
最大化整环兼容性,再选择起点
枚举奖励环,将首尾边也纳入总兼容分;以向其他维度兼容性总和最大的节点起步。论文得到总体→对齐→几何→纹理,随机、反向和移动起点用作消融;四节点易枚举不代表任意多奖励可低成本扩展。
- 4
用剩余空间平滑切换奖励
先把奖励归一化,按综合奖励的Gibbs权重估计当前维度剩余空间H;训练奖励由H乘当前奖励、1−H乘下一奖励构成。H变化小于0.05时推进,完成末维后回到首维并训练至结束,并非无限循环轮训。
- 5
接入现有优化器和生成骨干
图4右侧说明调度独立于具体RL优化器;实验重点是DiffusionNFT和GRPO,不能把图中列出的AWM当作已完成等量验证。Hunyuan3D是图像条件模型,论文先用Hunyuan-DiT将文本转参考图,各方法共享同一图像。
实验与证据
完整阅读85306字符正文、参考文献和附录A–C,视检方法图4及附录数据构造提示图S10。未复现训练、奖励模型或用户研究。
来源证据由既有提示清洗扩展为10000条,随机8000/1000/1000分割;测试每提示8个结果。300个提示的生成结果由每提示10位参与者排序。 第IV-A节、附录B ↗
我的解读图S10给的是构造提示与回答示例,不是数据文件或实际去重审计。随机分割不能保证组合语义不泄漏;排名汇总胜率也不等于逐对成功率。
来源证据8张RTX4090,LoRA rank32、alpha64,150步、batch8、学习率3e−5;训练8个rollout、12采样步、6个512像素视角。 第IV-B节 ↗
我的解读依赖预热为4次各5步,候选筛选也额外生成;只对齐150主训练步无法证明计算公平。
来源证据TRELLIS+DiffusionNFT以Rank2Score训练时,基线Rank2Score/CLIP/ImageReward/Uni3D为4.253/0.216/0.483/0.253,联合方法为4.525/0.233/0.678/0.267。 表I及IV ↗
我的解读跨评估器同向提升支持收益,但这些模型可能共享视觉偏好,不能单独证明几何或PBR正确。
来源证据同一设置只加AdaSelect为4.374/0.221/0.567/0.258,只加OuroReward为4.496/0.230/0.635/0.262。 表IV ↗
我的解读两个模块均有作用,调度贡献更大;联合值不能全部归于其中任一模块。
来源证据反向次序纹理→几何→对齐→总体的Rank2Score4.361、Uni3D0.253,低于带AdaSelect的平均奖励4.374/0.258;所选顺序4.525/0.267。 表VI ↗
我的解读顺序优化本身并不必然改善;合适顺序和起点才是此设置里的实证贡献。
来源证据TRELLIS第150步平均梯度相似度由平均奖励0.555升至OuroReward0.649,奖励变化PLCC由0.824升至0.873。 表II ↗
我的解读相关和梯度夹角是干扰代理量,不证明以后所有步骤、所有提示无负迁移。
来源证据Hunyuan3D+DiffusionNFT、Rank2Score奖励下,Qwen评估6.993升至7.412,表内用户胜率0.043升至0.583。 表I与模型引用 ↗
我的解读用户胜率属于对应4方法比较组;引用不匹配的Qwen具体版本仍待核实,不能据此跨论文比较绝对分数。
来源证据附录称HyperScore与Rank2Score按维度重新训练,单样本评估约0.1秒;但没有足够的训练和计时细节。 附录A ↗
我的解读同名原始评估器不能直接替代文中再训练版本;评分效率不包含整套生成、渲染与选样开销。
开放情况与使用许可
论文未给出作者实现、训练数据下载或模型检查点入口;检索尚未核实官方代码和权重。本文仅确认论文公开,不把上游TRELLIS或Hunyuan3D的开放状态移植到新方法。
LICENSEarXiv非独占托管许可;方法图4仅为必要评论引用,版权归作者。方法代码、奖励模型和权重再利用许可尚未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
AdaSelect与OuroReward各自消融都改善多个评分,两者联合更好;改变奖励次序和起点会削弱收益,支持调度本身的作用。
测试包含未直接作为训练奖励的评估器和300提示的用户排序,比只报告代理奖励更能支持可感知收益。
反方 · 哪些结论还不够
表中GPT-5.6引用GPT-4系统卡,Qwen3-VL引用Qwen2.5-VL及Qwen3报告,附录若干ULIP/Uni3D条目引用其他模型;真实评估检查点需作者代码澄清。
预热依赖、动态选样和奖励模型重训练均有成本,150步相同不等于总算力相同;也未给多种子置信区间。
奖励空间的剩余差距并非真实参数梯度方向;静态兼容环不能保证全过程无干扰或无奖励投机。
综合判断
实验支持按依赖顺序训练与能力匹配选样的组合价值,但复现证据和评估器身份尚不完整。适合作为后训练调度候选,不宜宣称普遍消除多奖励冲突或直接得到可用PBR资产。
我会先做的验证
建议实验,未执行:固定总GPU时与奖励调用数,对比平均、FocalReward、随机顺序及OuroReward;公开精确奖励检查点和分割,在语义去重的外部提示集上测盲评、几何连通性、UV接缝、PBR重光照误差,并重估训练中期依赖图检验次序稳定性。