PhysCanvas:世界模型也要预测接触,而不只画得像
统一视觉、触觉与任务状态后,能否更准确评估和改进机器人策略?
PhysCanvas 把RGB、光学触觉、标记位移和任务状态排成同一画布,利用视频模型共同预测,再以场景、跨模态和结果一致性校正。四个真实双臂任务上,模拟与真实成功率的相关性提高,想象空间后训练也提升了真实平均成功率;但触觉事件指标并非全部改善。
图解主要方法
统一视觉、触觉与任务状态后,能否更准确评估和改进机器人策略?
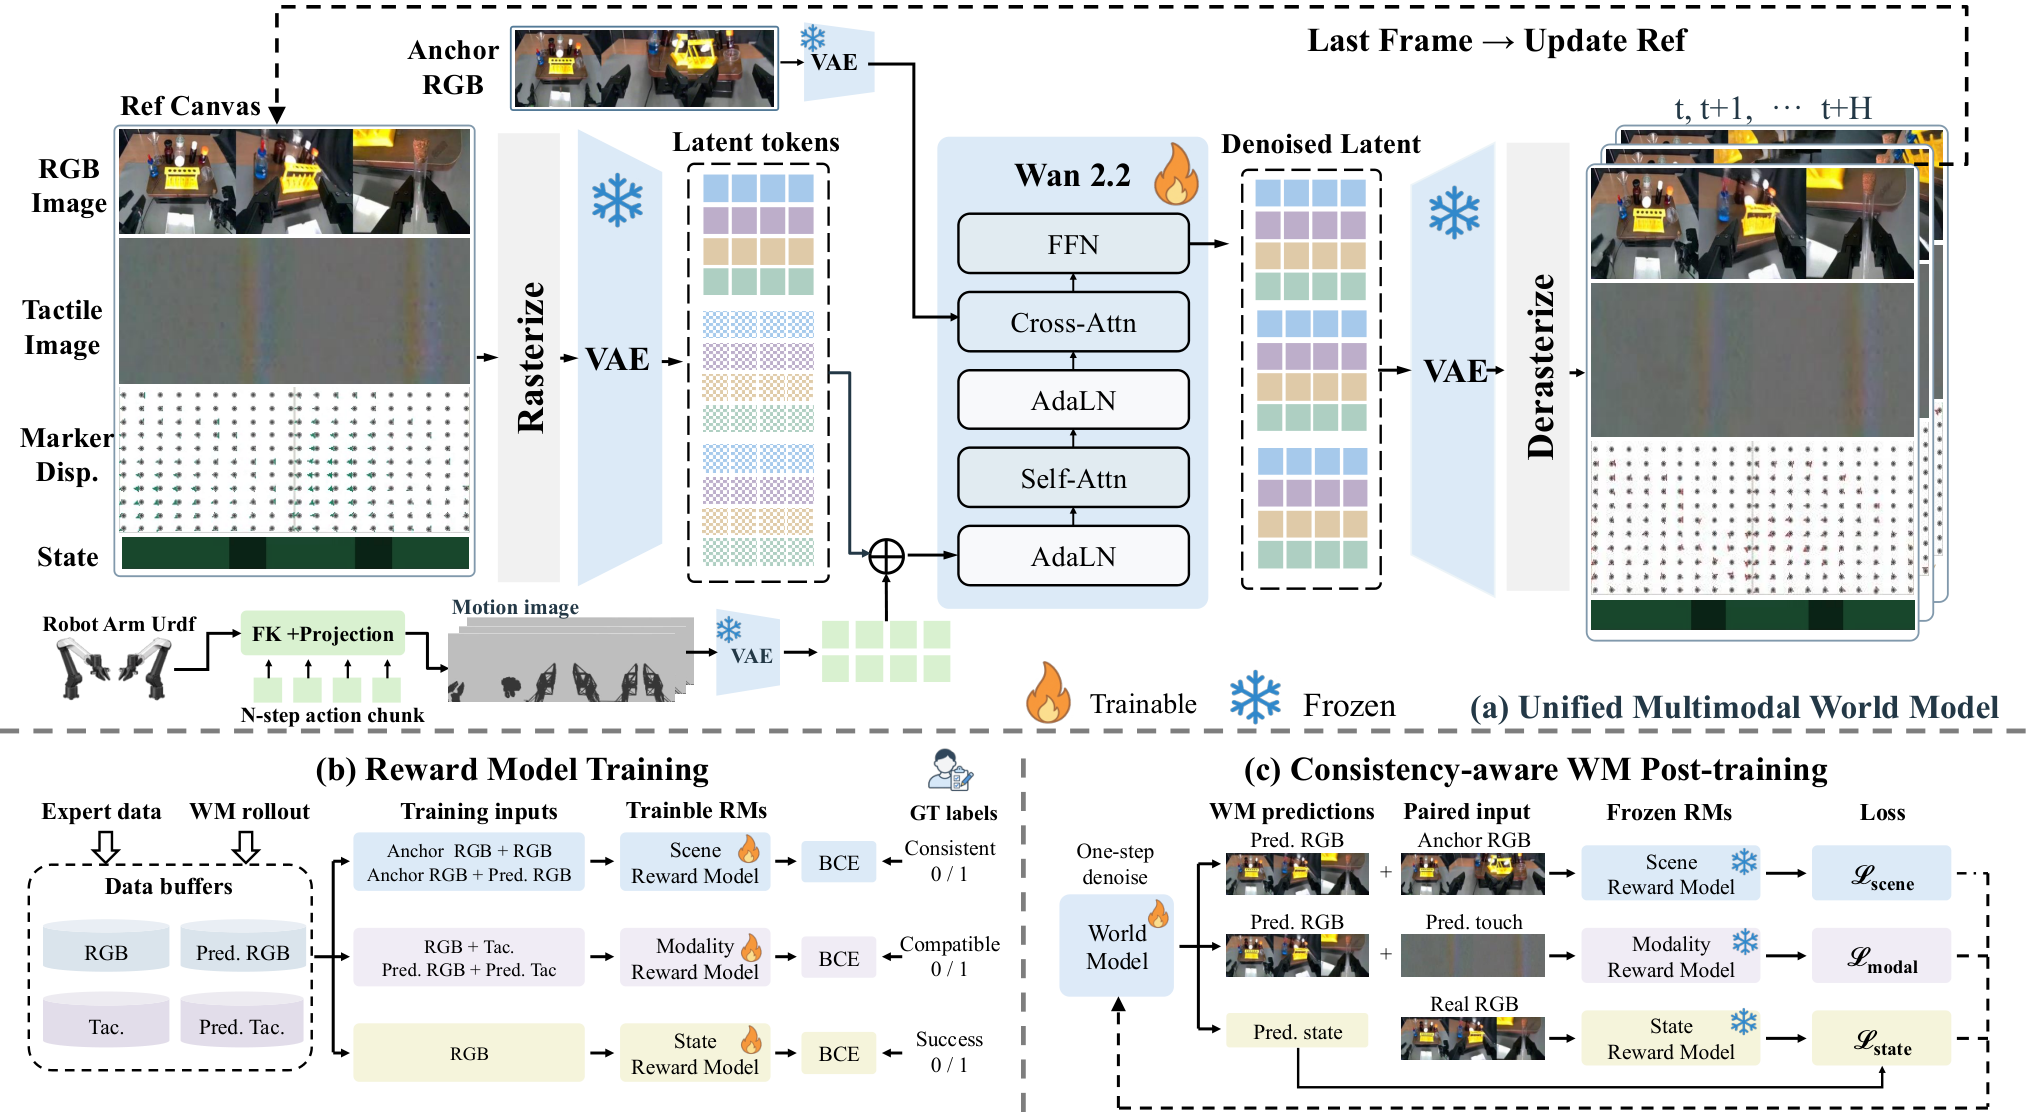
- 1
1 · 将异质信号排成同一画布
图3左侧横排三个RGB视角,纵向加入触觉图、将XYZ标记位移映射为RGB的区域和任务状态色纹区域。共享冻结Wan VAE和Wan2.2-TI2V-5B骨干,不另训练触觉编码器。位移编码s=0.06是缓存单位归一化尺度,不是力或米的物理量保证。
- 2
2 · 用可投影动作驱动未来
URDF与正运动学把双臂目标关节配置投影到相机,动作图潜变量逐位置加到画布token;任务状态区域不直接叠加动作。固定初始RGB锚帧保持场景,上一块末帧更新当前多模态参考,逐块生成8帧并递归推进。
- 3
3 · 用三种冻结评审校正生成
图3下方场景评审检查初始场景是否漂移,模态评审检查RGB与触觉是否相容;状态评审在真实轨迹上学完成标志。状态损失匹配真实成功或失败,不能一律推向成功,否则世界会骗策略。仍保留flow损失维护画质。
- 4
4 · 在生成环境里更新策略
从真实初始观测出发,策略只读生成的RGB/触觉,状态图不直接输入策略;每组8条想象轨迹由状态评审终帧概率≥0.7给二值奖励。组全成功/全失败被过滤,以GRPO只更新策略,世界模型和评审保持冻结。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据3805条真实策略rollout训练,四任务各80条留出测试;三相机、四Xense触觉垫、10Hz。世界模型64张PPU-ZW810E训练300轮约3天,训练四块递归上下文,推理每块5步。 数据与附录训练配置 ↗
我的解读数据包含失败有助于评估器学习反事实边界,但仍集中于一套硬件和四类桌面任务。
来源证据每任务ACT/FM/π0.5各3批20场景,9个成功率点;加入状态监督,任务内Pearson相关系数的算术平均0.602到0.885。 图8 · 策略评估 ↗
我的解读这不是逐episode预测准确率,也不是所有场景合并的一条相关系数;高相关不代表成功概率已经校准。
来源证据π0.5平均真实成功59.1%→普通世界RL67.5%→一致性世界RL70.8%;Bottle却90.0%降至86.6%。模态监督让Contact MAE0.02491→0.02278,但事件F1 0.4550→0.4455。 表3、4 · 真实策略与触觉 ↗
我的解读均值进步与个别任务退步并存;逼真触觉图不等于接触事件完全正确。FM的Test Tube和Rubik两任务仍为零。
开放情况与使用许可
官方项目页已核论文、示例与实验说明;其GitHub链接指向网站模板FlexiTac,并非PhysCanvas训练实现。未核得本工作代码/权重的独立下载与许可,保留待开放状态;页面模板CC BY-SA不覆盖研究媒体。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把世界模型是否保留真实失败结果作为训练目标,比只比视频画质更贴近机器人策略评估。
反方 · 哪些结论还不够
状态评审同时参与世界训练和RL奖励,可能被策略利用;四任务、固定硬件、短动作块不能覆盖开放世界。Rubik任务仅单面旋转复原,不是通用魔方规划;触觉图也不等同准确力学。
综合判断
提供有真实转移验证的多模态模拟路线,但仍需独立结果判定和分布外接触测试。
我会先做的验证
未执行的验证方案:用从未参与奖励训练的人工/几何判定器评估新物体与摩擦条件,报告校准误差、假成功、碰撞、滑落与真实成功率;对RGB-only、加触觉、加各奖励分别等预算比较。