World Models’ Last Exam in Physics:让视频接受可测量的物理检验
40项实验把视觉连贯与物理关系分开,评分仍受观测与阈值限制
该基准用40个受控图生视频任务测试九类物理现象,通过跟踪、分割、几何与时序测量,把周期、角度、液位等量与明确物理关系比较。VLM只负责一致性/可观测筛选,物理分独立测量,再经过门控形成总分;它提供诊断证据而非通用物理正确性认证。
图解主要方法
如何把生成视频的视觉连贯、证据可测和物理关系正确分开评价?
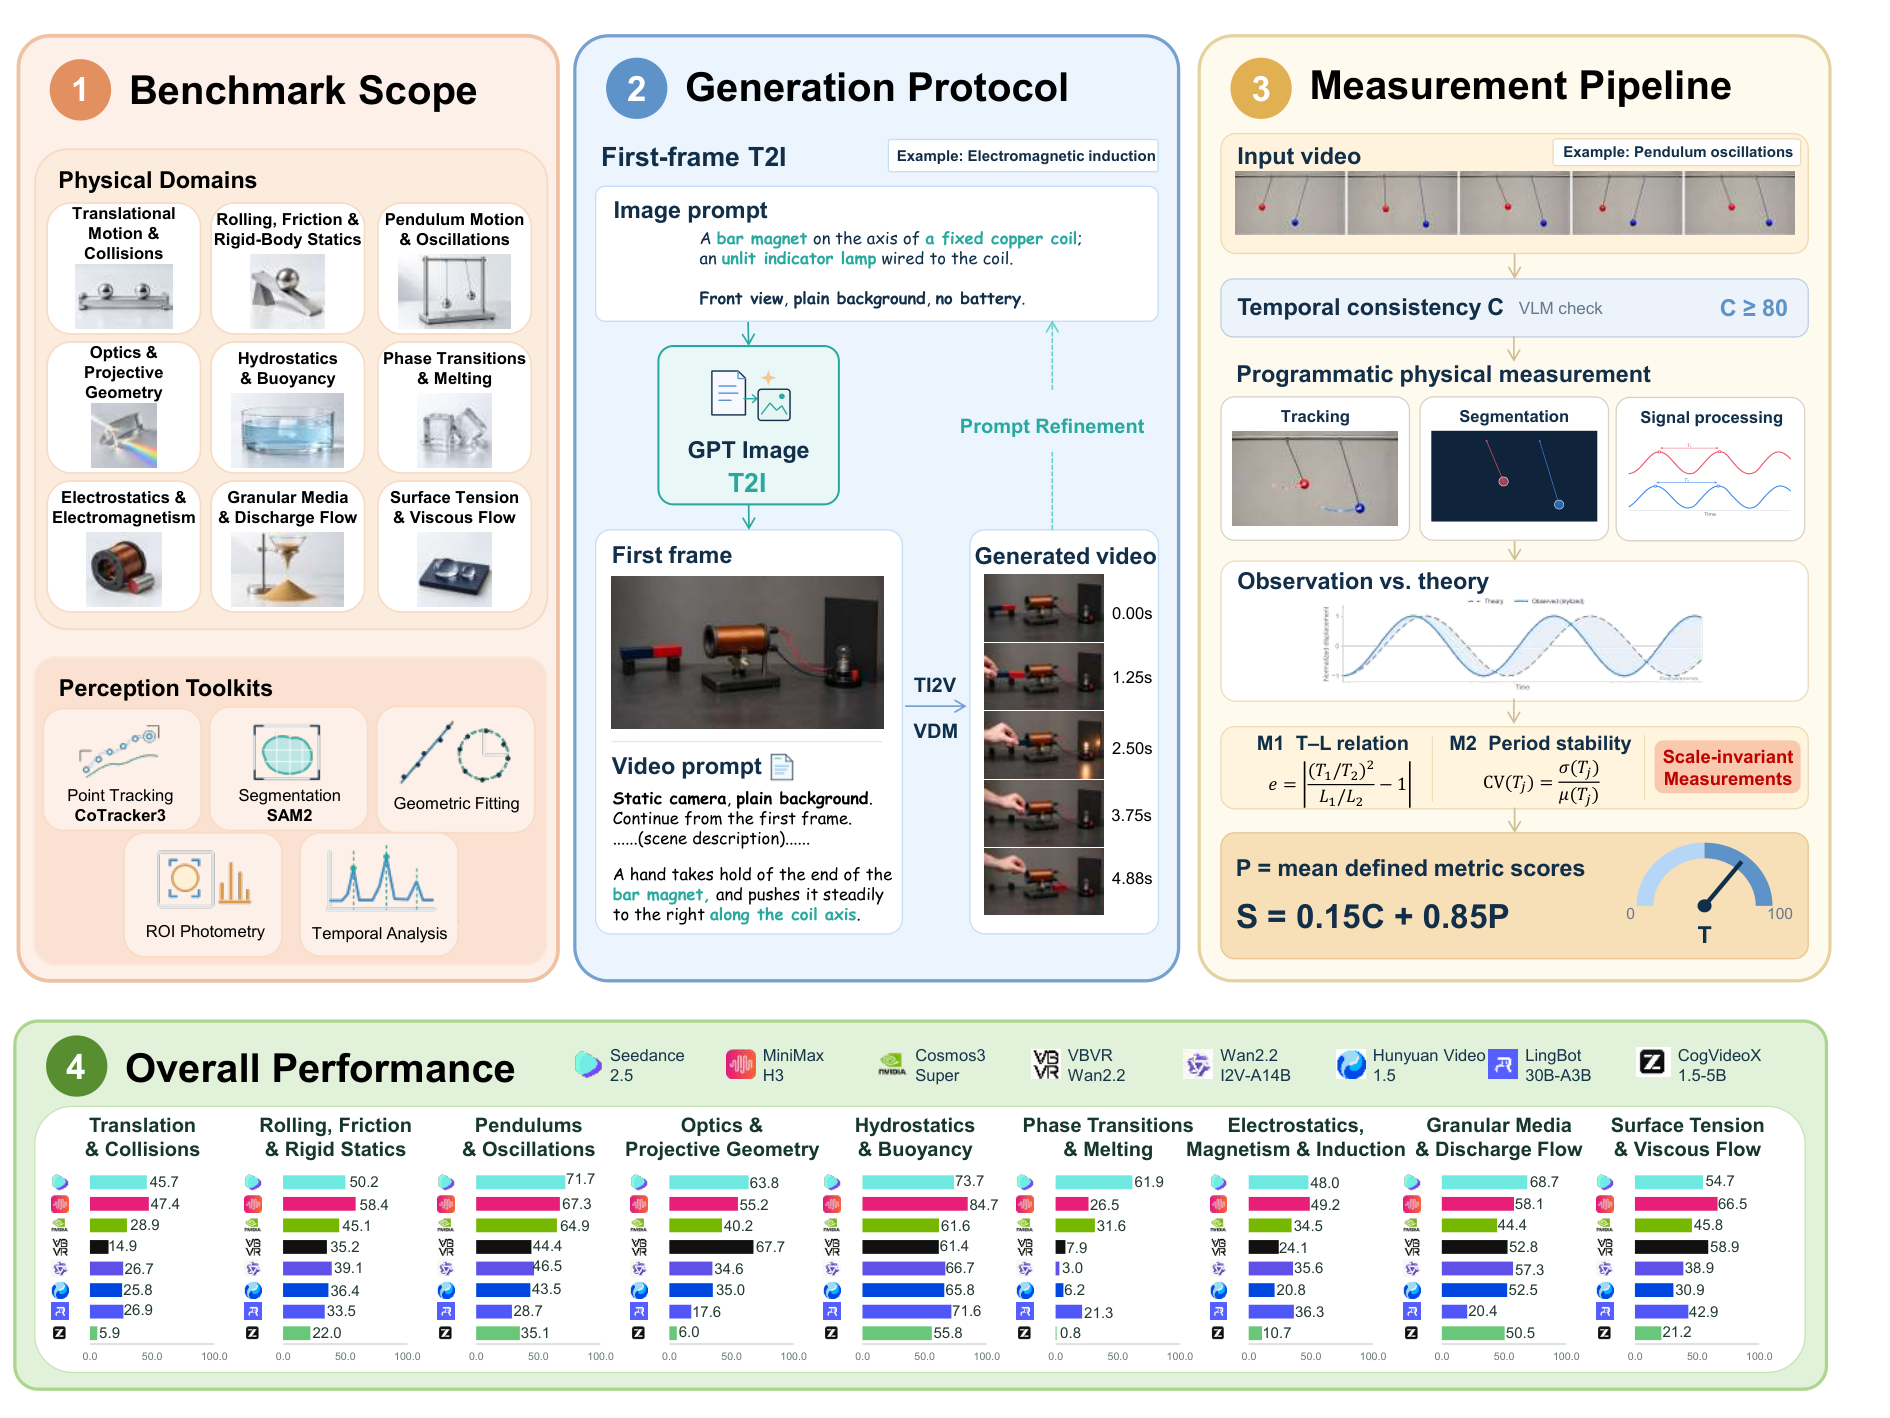
- 1
设计受控且可测的任务
为40任务写明材料、初态、相机和物理假设,生成并人工审查首帧/提示;用周期比、位移比等消去共享尺度,但透视畸变和非匀速时间仍需控制。
- 2
相同输入生成四个样本
八模型接收相同首帧和任务描述,支持时固定种子42–45;总1280视频,帧数81–129、分辨率不同,不能当计算预算完全相同。
- 3
分开一致性筛选与物理量测
Qwen3.6-27B给可观测/连贯分C,独立对所有视频用CoTracker3、SAM2及专用几何/事件程序量测,不先删除C低的视频。
- 4
将残差映射为指标分
65指标含每题主指标和25题辅助指标,常用1/(1+误差/尺度a),a表示半分误差而非通过阈值;另有方向二值与事件证据,按题内定义求均值P。
- 5
逐视频门控后聚合并验测量器
S=.15C+.85P,仅C≥80且P有记录时物理项贡献;先逐视频门控再平均。以受控动画和盲人评比较量测器,同时保留原始测量、未解项及错误状态。
实验与证据
全文及附录A–C、40任务65指标和全量分表读完,图1核验;官方项目、README、evaluate.py及递归目录实际查看。
来源证据最高Seedance2.5 S57.76,MiniMaxH3 54.89;Seedance平均C98.25、独立P51.11。 表2、4 ↗
我的解读三分数含义不同,57.76是人工定义加权综合分,不是通过率;八模型的40题总体不能外推所有真实物理。
来源证据自由落体所有视频通过一致性门控,跨模型S26.61、P13.88;石头冰块融化P26所有模型P0。 表2、4–5;附录B ↗
我的解读可见连贯不保证动力学正确;P0可能是测不到所需终态/液位变化,不能笼统说所有视频已被测出物理违例。
来源证据连通器任务各模型S93.09–99.01;其液面差按不小于整帧高度归一,误差尺度a=1。 P21指标;表2 ↗
我的解读高分同时受宽松归一化影响,并非已经通过精密液位平衡测量;跨题得分难直接等价。
来源证据P18反射角误差a=90度;P6两块都静止可得指标.7;P30确认磁铁进入而指示灯不可读可得.5下界。 附录B.2、B.4、B.7 ↗
我的解读这些设计可解释部分分数,却也说明“物理分”混合准确度与任务证据,不能统一当严格物理判定。
来源证据480个已知正确关系的二维合成视频、每题12个,绕过一致性门控后平均P97.53。 第3.2节 ↗
我的解读支持受控外观下测量器响应正确,不检验完整VLM门控,也未证明对所有物理错误具有相同敏感度。
来源证据320人评视频构成1120题内配对,排除203不可评后917对:本文473/917=51.58%,直接VLM43.40%,人际56.60%。 图4;第3.3节 ↗
我的解读匹配平局才算一致;配对不独立,论文按任务给区间,不能把917当独立受试者。
来源证据160直接配对确认一致85/160=53.12%,VLM73/160=45.62%,人际58.54%。 第3.3节 ↗
我的解读无多数判断仍留分母且不计一致;+7.50点不是分类准确率,仍低于人际基准。
开放情况与使用许可
GitHub确有生成/评测入口、easy/medium/hard任务、文档和脚本,并非空仓库;递归目录未见LICENSE/COPYING,故表述为代码可查看,尚不能认定标准开源许可。
LICENSE论文CC BY 4.0;仓库代码许可未核实,模型及生成服务条款独立适用,不能把论文许可套用所有实现与视频。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
每题公开物理假设与指标,所有视频独立尝试量测,保留中间证据和门控前分数。
提供480个受控合成正确视频与320个人评视频验证,不仅报模型排行。
反方 · 哪些结论还不够
合成正确视频主要验证正例能得高分,不能充分证明复杂画面上的假阳性率与错误识别能力。
部分指标只是方向/对称性:毛细上升不检验完整反比定律,等质量碰撞未单独评分弹性,不能把题目覆盖等同全部定律验证。
不可测项的操作性零分与真实违例混入总分;人评一致性仍约52–53%,应保留测量复核。
综合判断
是有用的可解释物理诊断集,证据强于纯印象打分;最高57.76并非57.76%视频物理正确,跨任务总分和模型名次仍依赖门控、量测覆盖与指标尺度。
我会先做的验证
建议实验(尚未执行):补充已知错误强度的负例与真实标定视频,扫门槛80和15/85权重、误差尺度;区分测量失败/已证违例,匹配视频时长分辨率并对模型差做任务级置信区间。