PhysInsert:让图像插入同时改变物体与周围光影
反事实渲染和几何分支怎样约束阴影、遮挡与摆放?
以相同场景有物体/无物体的重渲染对训练图像编辑器,联合几何特征、物体/环境影响图和空间语言对齐。改善位置与光影整合,但输出仍是二维合成图;逼真阴影不是可重光照的PBR材质或可编辑三维物体。
图解主要方法
反事实渲染和几何分支怎样约束阴影、遮挡与摆放?
- 1
先做真正反事实的场景数据
在完整BlenderKit场景中删除目标物体,固定相机、灯光与其余配置,重新计算阴影反射,而非只把物体像素擦掉。InsertWorld含12951对场景、1710物体及275310参考图;每物体七种光照、23视角。训练与400例受控测试场景分开,避免直接记住背景。
- 2
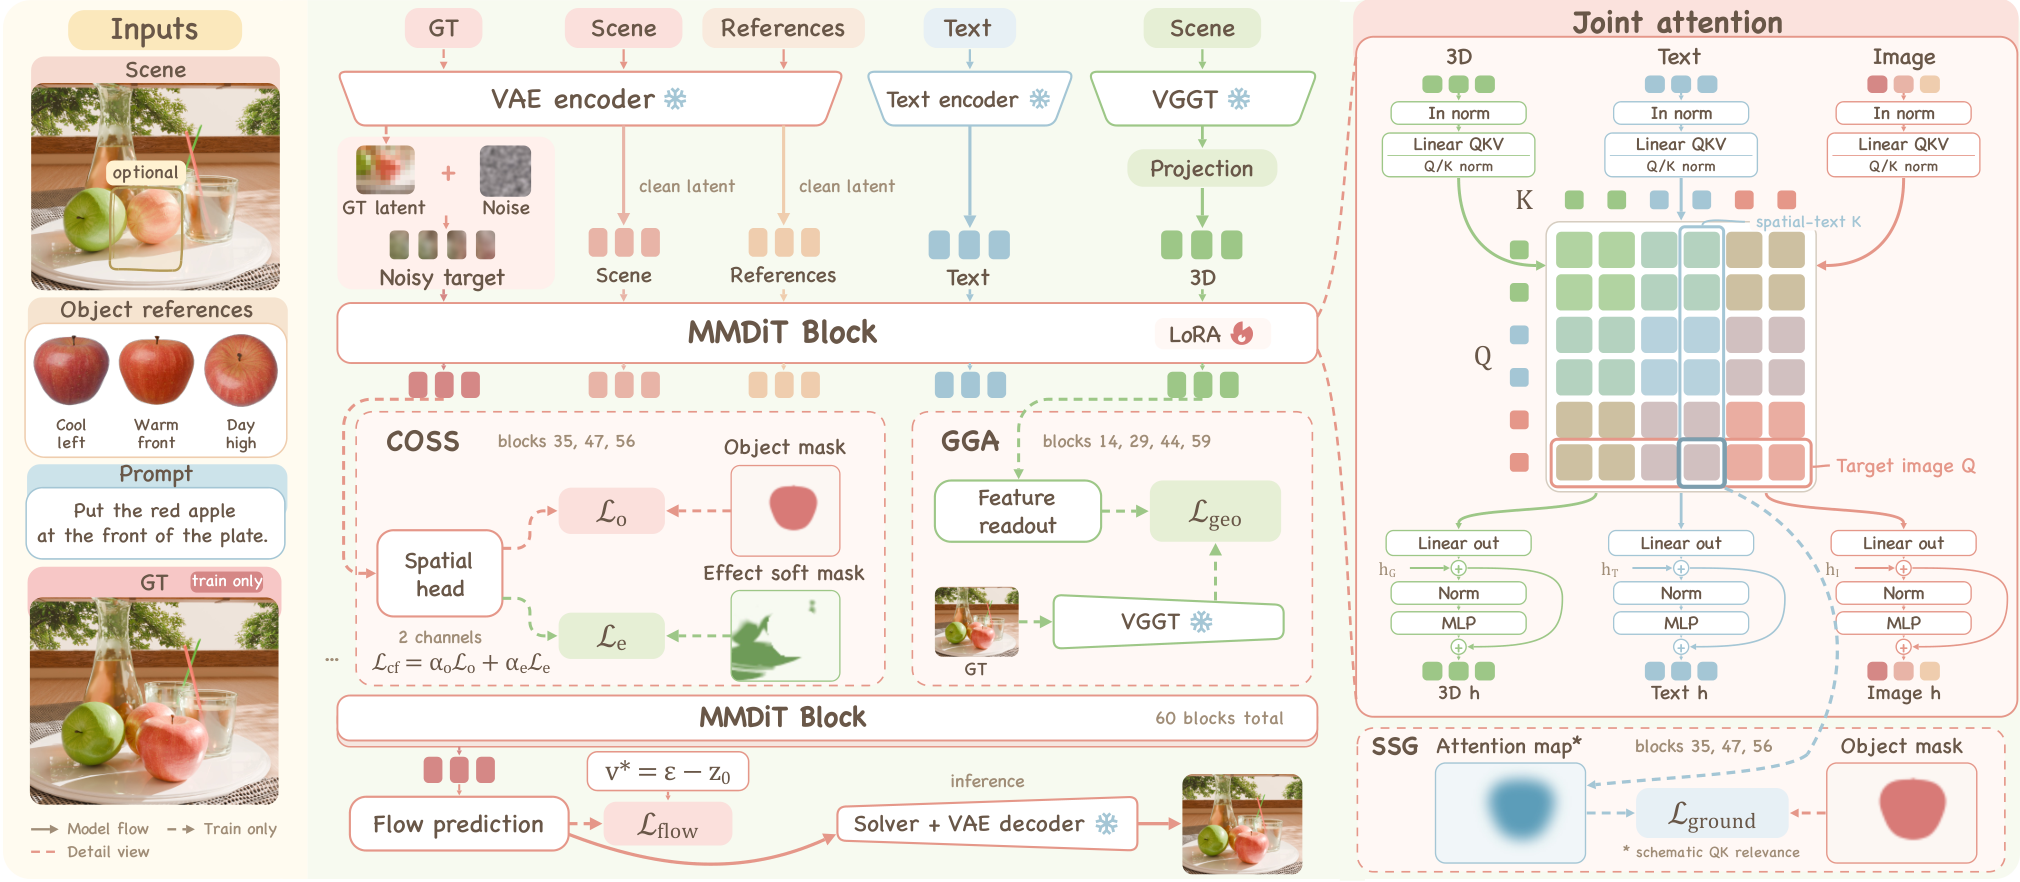
图3:在图像和文本之外加入几何流
Qwen-Image-Edit-2511的冻结VAE编码背景、参考与训练目标,VGGT从背景提取几何特征,经投影进入第三条DiT流,三流联合注意力交互。训练时读取更新后的几何状态去预测目标图VGGT特征;目标特征只做监督,不在推理时偷偷注入目标。
- 3
COSS区分物体占位与外部影响
软物体掩码监督占位;有/无物体图的绝对差,经平滑阈值化并排除膨胀物体边界,形成外部影响图。平衡BCE与Dice防止背景像素压过小区域。这只是阴影、反射等可见变化的代理,不是每种光学效应的物理解耦。
- 4
SSG把空间词落到位置上
从指令中定位空间描述,聚合相应文本—图像注意力,并与归一化物体软掩码作KL对齐。辅助头只用于训练;推理给背景、参考和指令,可选框,无需真值掩码。LoRA rank32、8张L20X、约16000步;框引导版本再训练4000步,不能忽略额外预算。
实验与证据
已阅读全文正文及附录E方法、F训练、G效率、I数据和K用户研究,核对实验条件与原图;未独立复现。
来源证据180光学、220空间/机械案例,来自103留出场景;单参考文本引导mask IoU56.08对Qwen44.14,PSNR24.4对19.34。Phy-VLM3.52±.11,Nano Banana Pro3.48±.09。 受控400例与训练条件 ↗
我的解读我的解读:位置改善明显,但两组物理评分区间重叠,不能断言显著领先;部分DIRECT对照使用真值辅助姿态,输入条件并不完全相同。
来源证据野外50例、DreamBooth40例;野外DINO .7784低于Nano .7881。另27位参与者对25例盲测,综合约4.04/5;区间按参与者bootstrap,案例固定。 真实图与用户评测 ↗
我的解读我的解读:身份保持并非所有指标都领先;人类主观偏好支持观感而不证明物理正确,真实集合较小,移除背景还涉及编辑模型生成。
来源证据L20X、1024×1024、batch1、40步、CFG4,同种子条件,五例暖机后完整调用平均120.13秒,对基座79.40秒;峰值60.80GiB对55.92GiB,不含加载和文件I/O。 附录G端到端推理效率 ↗
我的解读我的解读:几何约束有明显计算代价;这里包括在线VGGT与未融合LoRA,不能凭参数只增加4.48%就认为推理开销也只增4.48%。
开放情况与使用许可
论文与作者项目页已公开;本次未核实完整实现、模型权重及InsertWorld可下载包的许可,不将数据规模描述或项目展示视为已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:让训练目标同时解释插入物体和它对环境的影响,比局部粘贴更适合产品展示、概念场景和视觉资产预览;反事实数据设计有明确因果控制。
反方 · 哪些结论还不够
VGGT特征和VLM评分都是代理,不能保证真实照明规律。输出没有UV、部件、PBR或光照分离,无法把二维阴影直接拿去引擎重光照;参考重建与背景修复会引入额外误差。
综合判断
应作为二维场景合成研究收录;适合概念预览,不等于生成了可编辑三维资产或完成物理仿真。
我会先做的验证
未执行的验证方案:冻结背景、物体与指令,逐项关闭几何流、COSS、SSG;在可控灯位的实拍配对数据测物体位置、接触阴影方向、背景保持与身份一致性,再由盲测评审判断,和VLM分数分开报告。