世界模型该保留多少信息?搜索与最后选择需要不同答案
一比特可保住最后决策,却可能在早期搜索中丢掉好候选
论文把物理机制、候选结果和最终决策需要的信息分开:粗决策可能不需要完整预测,但搜索好动作往往需要更丰富反馈。碰撞、双摆、Push-T和PushCube实验支持按规划阶段分配信息,并把目标引导候选与目标无关的物理预测分开。
图解主要方法
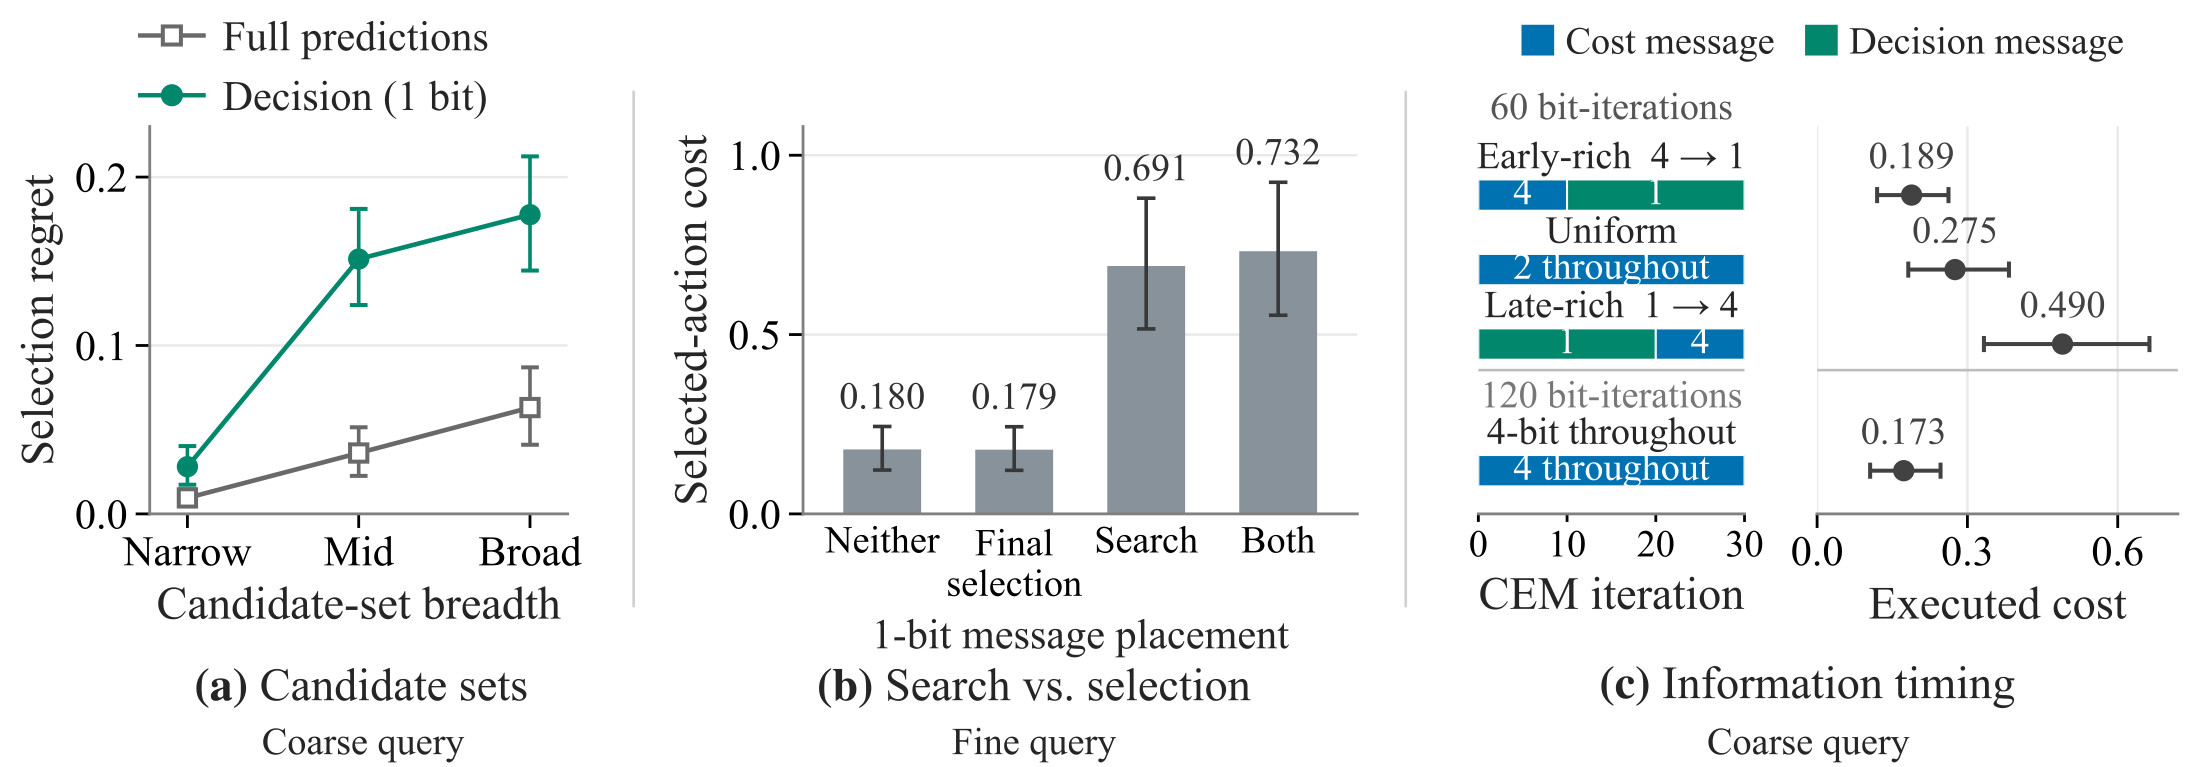
图4为什么出现“最后一步只用一比特几乎无损,搜索时却明显变差”的结果?
- 1
固定目标与候选,定义信息层级
相同动力学必然给相同代价向量,再以固定平局规则得到相同最优动作;反过来不成立。所有候选代价误差≤ε时,所选动作后悔值≤2ε。该保证依赖固定候选及统一误差界,不意味着实际学到的一比特表示普遍足够。
- 2
在离散瓶颈后使用匹配读出器
碰撞和双摆把观察编码为可变长VQ消息,再冻结编码器、重训共同评分器,分离表示与输出头差异。报告的是实际编码流平均比特,依赖分布、熵编码和插值,不能称为单次物理场景的普适信息下限。
- 3
区分CEM搜索与最终候选选择
图4b交叉使用完整预测或一比特消息:同一批最终候选可只保最优索引,但CEM更新需要精英集合,MPPI还需要相对权重。早期排序出错会改变后面采样分布,最终再恢复精确信息也救不回未找到的候选。
- 4
把目标放进提议,保留可复用物理预测
图4c先富后简优于先简后富,提示按搜索阶段分配容量。进一步用目标条件提议器寻找方向,物理模型只看观察和动作,结果可按不同目标重评分;这是完整接口比较,Joint还改变训练动作暴露,不能只归因为是否输入目标。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【搜索/选择】64个匹配Push-T开发回合:完整搜索/完整选择代价0.180,完整搜索/一比特选择0.179,一比特搜索/完整选择0.691。 图4b、附录D ↗
我的解读我的解读:压缩是否可用取决于放在哪一步;这些是冻结预测器和特定CEM设置,不是任意世界模型通则。
来源证据【时序预算】相同60 bit-iterations名义预算,先4比特后1比特代价0.189,反向0.490,恒2比特0.275;全4比特120预算为0.173。 图4c、附录D.5 ↗
我的解读我的解读:支持早期搜索保更多信息,但bit-iterations不是实际GPU时延或总系统通信量。
来源证据【容量反例】128未见场景三种子,一比特Hybrid后悔值0.272优于Value0.448;八比特时Hybrid0.306反而差于Value0.229。目标引导PushCube八候选成功30.83%,盲提议128候选28.19%。 附录F表10、PushCube实验 ↗
我的解读我的解读:规划监督收益集中于紧瓶颈;更多容量会改写排序,候选提议与最终挑选也应分别验收。
开放情况与使用许可
已读v1全文与附录A–H;未核实专属实验实现及训练模型公开。
LICENSE实现许可未确认;论文图4为CC BY-NC-SA 4.0,保留原图及来源。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
明确区分找到好动作和认出好动作,提供压缩位置、目标条件与规划阶段的受控证据。
反方 · 哪些结论还不够
主要为仿真、特定CEM及冻结预测器;经验码率不是理论最小值,接口参数量与训练暴露不完全匹配。
综合判断
世界模型压缩应先问规划器在哪一步使用信息,再决定保哪些细节;低像素误差或低消息比特都不能单独代表好决策。
我会先做的验证
未执行的验证方案:固定总FLOPs和延迟,比较早期/晚期压缩、CEM/MPPI及闭环真实接触任务;分别测候选集最优质量、选择后悔、预测缓存命中和换目标复用,加入容量与训练暴露匹配对照。