VPM:让视频世界模型同时预测三维点轨迹
多视图视频生成能否用持续的三维点身份约束运动?
Video-Point Model 在Cosmos3-Nano上联合学习多视图未来视频和三维点轨迹,并扩展到动作预测。点轨迹给生成过程增加几何监督,实验显示运动指标和部分机器人得分改善;但校准相机、较重推理和非商业许可仍是部署条件。
图解主要方法
多视图视频生成能否用持续的三维点身份约束运动?
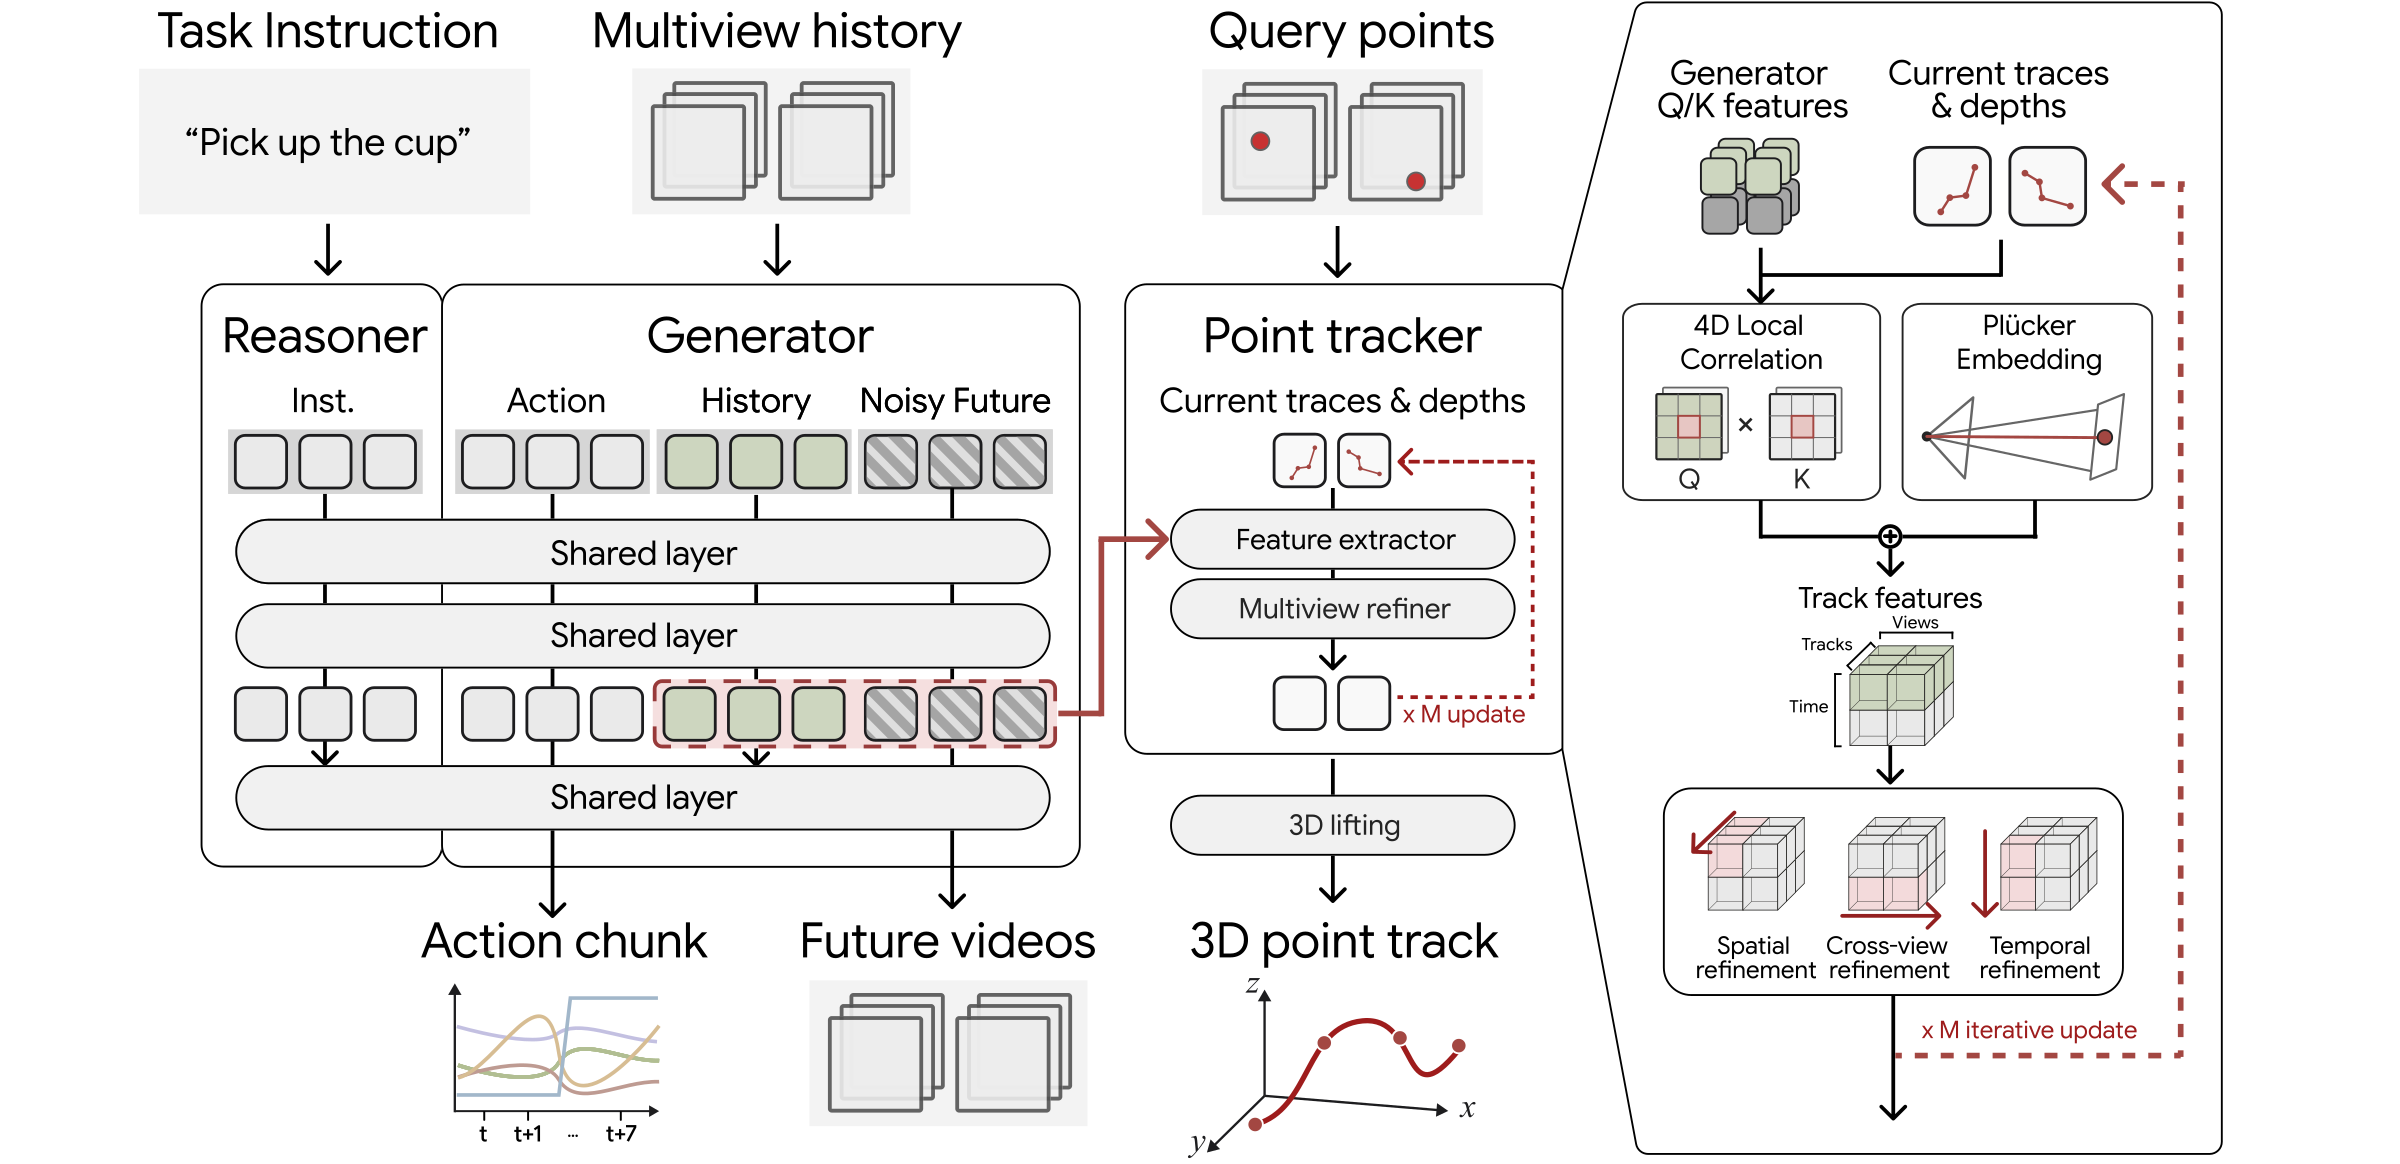
- 1
第一步:把校准多视图历史送入视频主干
图2左侧输入任务指令、多个相机的历史视频与相机参数。冻结推理模块,给生成模块加入Plücker相机嵌入、Q/K旋转和额外视图位置编码,使同一时刻不同相机的token能建立几何联系。主基准没有提供未来相机位姿,但需要历史相机标定;另有未来相机条件实验,二者不能混报。
- 2
第二步:从注意力相关性读出持续点轨迹
图2右侧从第18层Q/K特征提取局部相关,四轮细化结合时间、视图与空间关系,预测查询点的二维位置、深度与置信度,再通过相机参数提升到三维。训练每样本使用512个查询点,截断Huber误差和跨视图约束保持点身份,输出的是运动轨迹而非可编辑网格。
- 3
第三步:分阶段联合训练视频与轨迹
先用5k步适配视频生成和相机条件,再2k步预热轨迹头,最后5k步联合优化,使用32 GH200。完整训练混合约604913样本,包括DROID、Molmo等来源;新发布VPM-Data的10K仿真片段只是其中一部分,不应把全部能力归因于这10K数据。
- 4
第四步:从视频预测扩展到动作,但单独验收
模型可并行生成动作块与视频,作者也探索以点轨迹结合逆运动学控制。后者仅给出不够稳定的零样本示例,未形成可靠量化结论。当前公开VPM-DROID是三相机、16帧/16步动作的专门检查点,不等于主论文所有64帧世界生成模型都已同样发布。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据1200片段分为500仿真机器人、500仿真通用、100真实机器人、100真实通用。真实机器人V→V+T的FVD由296.83到255.19,三维轨迹δ指标由50.83到64.75。 VP-WorldBench与表2 ↗
我的解读主表轨迹指标用MVTracker+MoGe2从生成视频估计,不是直接读取模型轨迹头;附录直接头67.22属于另一测量。连真实视频的跟踪管线也有误差,不能把δ当精确物理状态真值。
来源证据每任务24次真实试验,按无碰撞成功1分、有碰撞成功0.5分、失败0分计;香蕉任务得分58.3→79.2,杯子64.6→70.8,方块43.8→54.2。 机器人实验及附录 ↗
我的解读这些是带半分的平均奖励,不能换算为严格成功次数。RoboCasa附录还出现每任务200次与5场景各10次的数量表述不一致,本刊不把该部分当无歧义成功率证据。
来源证据GH200、batch1、BF16、35步、480p、64帧、四视图设置含VAE耗时:VPM约102.3秒,Cosmos对照63.5秒;相比不带轨迹头的VPM约多0.9秒。 附录表27,推理成本 ↗
我的解读轨迹头的边际成本小,不代表整体模型便宜或实时;总耗时约为Cosmos对照的1.61倍。主基准多视图设置与公开DROID动作检查点的输入尺寸、帧数不同。
开放情况与使用许可
2026-10-25核实官方训练/推理实现、VPM-DROID七个safetensors分片、VPM-Data与VP-WorldBench实际数据文件。代码、VPM权重及所核数据卡为CC BY-NC 4.0,限非商业;Cosmos衍生部分还需遵守随附OpenMDW 1.1。论文及原图CC BY 4.0不覆盖这些资源的商业使用。完整混合训练集与全部实验检查点不据此视为齐备。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:持续点身份让“未来看起来合理”多了一层可检验的几何约束,多视图共享监督也比独立视频生成更适合研究空间一致性。
反方 · 哪些结论还不够
收益仍受相机校准、外部跟踪器误差和训练混合数据影响;机器人得分不是纯成功率,推理成本不满足一般实时控制要求。点轨迹也不等于拓扑、UV、PBR或部件级资产。
综合判断
值得用于离线世界预测与几何监督研究;实际控制需专门测试动作检查点的延迟和闭环稳定性,商业应用还需另行确认授权。
我会先做的验证
未执行的验证方案:固定相机与数据预算比较视频-only和视频+轨迹,加入标定误差、遮挡与相机移动;分别报告直接轨迹头误差、外部跟踪评估和人工运动检查。机器人同时报告严格无碰撞成功率、分级奖励、P95延迟和接管次数。