Position Forcing:让几何潜变量逐步告诉模型自己在哪里
单阶段位置自条件生成;训练真值坐标与推理预测坐标的差异是关键
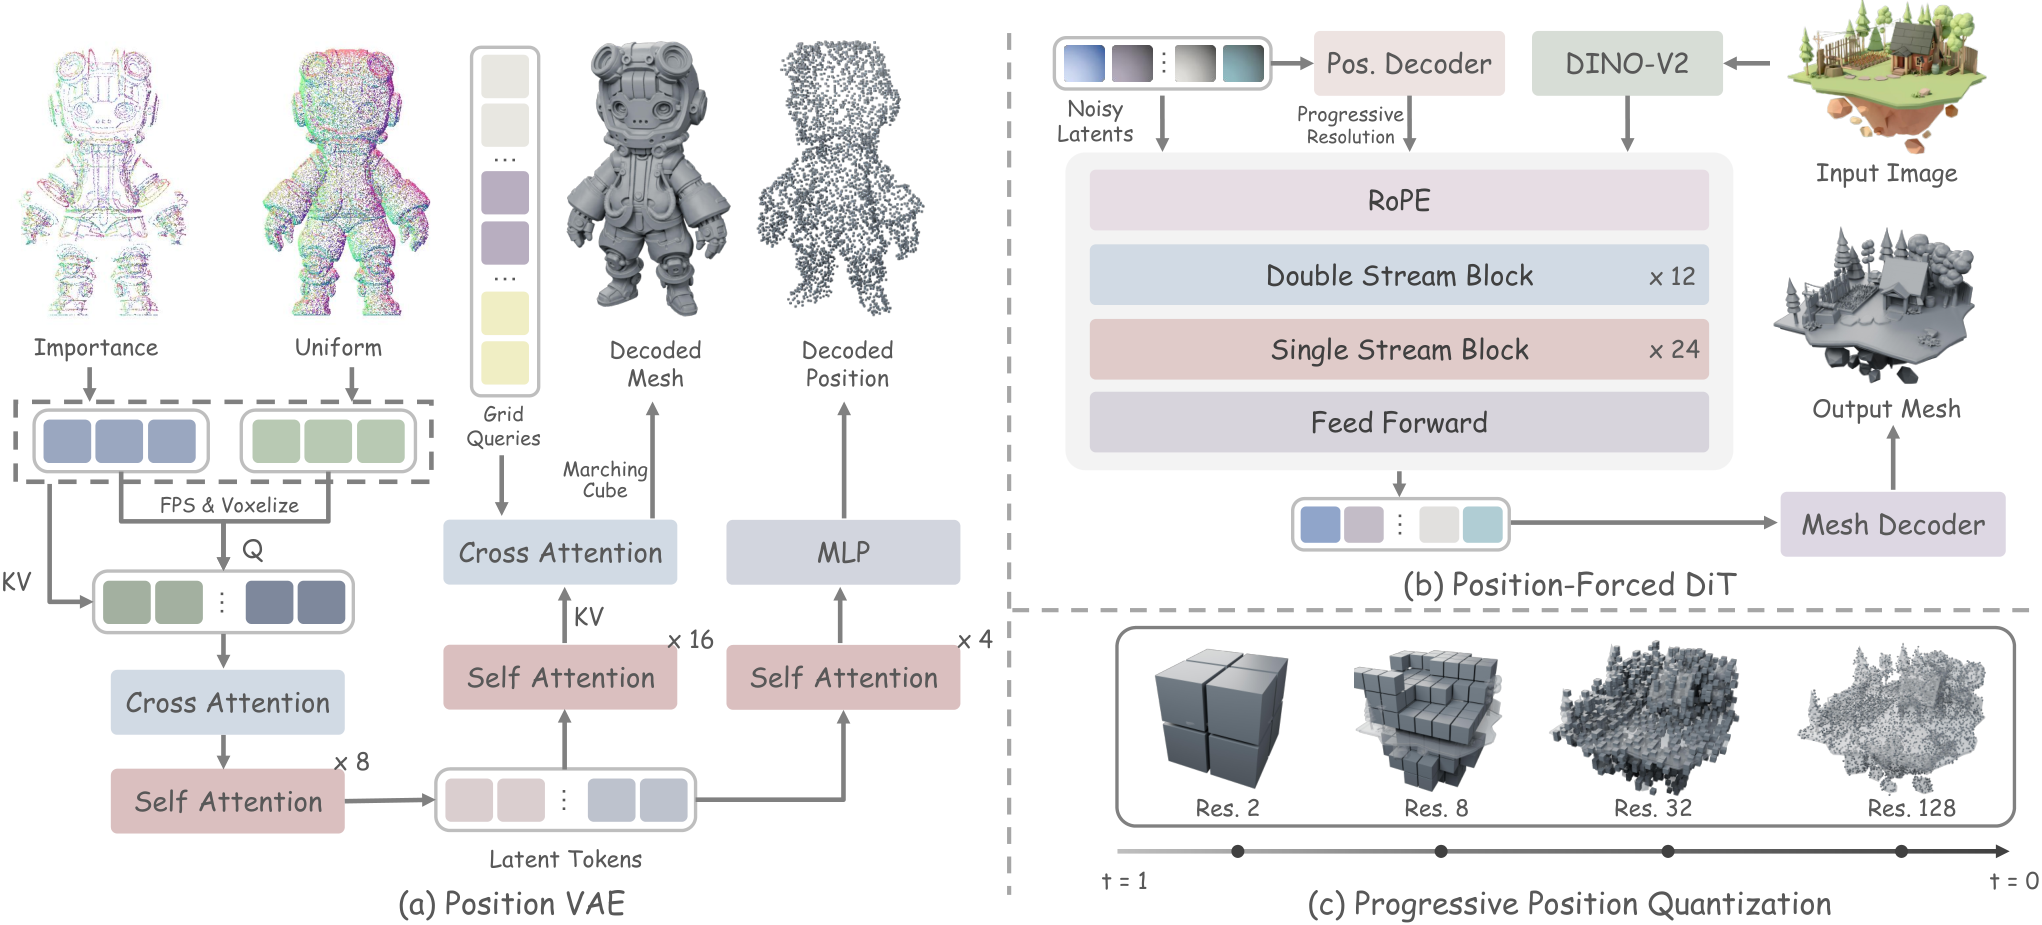
Position Forcing 在单阶段图生3D中为无序几何 token 增加位置解码器。生成时先从速度预测得到干净潜变量估计,再恢复坐标、由粗到细量化,并通过3D RoPE反馈给下一步。它避免另训结构生成模型,但仍需联合训练位置感知VAE和图像条件DiT;现有证据主要覆盖几何重建与语义相似度。
图解主要方法
无序几何token如何在一次生成轨迹里获得逐步可靠的空间位置?
- 1
先让token同时保存几何与位置
VoxSet编码器以带抖动的空间query产生64维latent。先冻结原VAE,只训练4层Transformer位置解码器,以query坐标作逐token L1监督;再联合优化几何TSDF重建、位置损失与权重10⁻⁶的KL项。几何编码器/解码器为8/16层。
- 2
训练时用真值位置,而不是展开自条件轨迹
冻结Position VAE,用DINOv2-Giant图像特征与几何token进入12个双流、24个单流块的DiT。Flow matching每次只抽一个时刻,位置来自VAE query真值,不来自前一步模型预测。量化后半数样本加入每轴−1/0/1扰动;单格阶段不扰动。
- 3
先预测干净latent,再反馈下一步
推理从纯噪声与统一位置开始;每步速度v得到z₀估计=zₜ−tv,再经位置解码器恢复坐标。将坐标量化到下一步网格,并通过3D RoPE条件化下一次速度预测。图2画法较简化,准确的数据流以正文公式11–14和算法1的干净态恢复为准。
- 4
逐步细化空间格并抽取几何
R(t)=clip(2^floor(9−10t),1,128),各级坐标映射至128参考坐标系。训练先4096后6144个token,推理12288个token、1022²输入、50步Euler、CFG5、BF16;条件和无条件分支共享位置。最终在512分辨率用dmc模式抽取零等值面。
实验与证据
完整正文、附录A.1–A.5、算法1及作者项目页已核对;未独立运行模型。
来源证据表2:8192 token下CD为6.37、F1为93.83;混元2.1为8.28/90.99,TripoSG为16.61/94.19。 表2;§4.1 ↗
我的解读CD更优不意味着F1也胜过所有对照;测试集和指标定义缺项,不能直接横比其他论文数值。
来源证据表3:ULIP-T/I为0.077/0.130,Uni3D-T/I为0.257/0.321;混元2.1为0.075/0.125、0.250/0.320。 表3;§4.2 ↗
我的解读四个表内分数最好或并列最好,但绝对差小;这是语义表征相似度,不能证明网格可制造或有正确材质。
来源证据图4同输入、随机种子和采样设置;e/f共享query条件检查点,c/d共享预测位置条件检查点。 图4;§4.3 ↗
我的解读e→f的改善较大,c→d较小,说明干净态反馈与训练条件联合作用;d→f的Uni3D-I反而0.323→0.321。
来源证据附录训练图像518²、4096→6144 token;推理1022²、12288 token、50步Euler。 附录A.1–A.2 ↗
我的解读训练与推理长度、图像分辨率不同。没有各基线统一硬件/预算信息,单阶段不自动意味着更快。
开放情况与使用许可
作者项目页提供交互几何示例和采样轨迹。核查时未见代码仓库、模型卡或权重下载链接,不能称已开源模型。
LICENSE论文与所引原图为CC BY 4.0;项目页模板的CC BY-SA 4.0不等于模型或演示资产许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
联合微调把干净latent的128³网格位置命中率从67.4%提高到99.9%,20%噪声下从23.0%提高到92.5%。
同一query条件DiT检查点,用干净态而非当前噪声态恢复位置,ULIP-I从0.095升至0.130,支持推理位置来源确实重要。
反方 · 哪些结论还不够
渐进量化消融不是所有指标都上升:固定到渐进时ULIP-T由0.076降至0.074、ULIP-I由0.127降至0.124,而Uni3D指标改善。
最终模型Uni3D-I为0.321,低于另一消融配置0.323;不能把全方案描述为每项指标都最佳。
图5比较中间位置与模型最终位置的一致性,不是与真实几何位置的一致性,粗网格天然更易命中。
综合判断
位置反馈机制及配套消融有解释力;当前结果支持几何生成方向上的改进,但未建立效率优势、统计显著性或资产生产可用性。
我会先做的验证
建议实验(尚未执行):固定训练集、模型规模、采样预算与随机种子,比较无位置、噪声态和干净态反馈;同时报告配对置信区间、延时/显存、非流形率、薄片和背面误差,并经过重拓扑、UV展开、PBR贴图与重光照检查。