PWM:把世界事实交给程序,把画面交给生成模型
持续状态、3D 包围盒和视频渲染之间的接口
Programmable World Model 用可执行规则维护实体、血量和事件等持续状态,再把 3D 包围盒编译成视频模型的空间条件。它改善了画面与规则的一致性,但状态正确由外部程序保障,不能据此声称视频模型自行学会了完整游戏逻辑。
图解主要方法
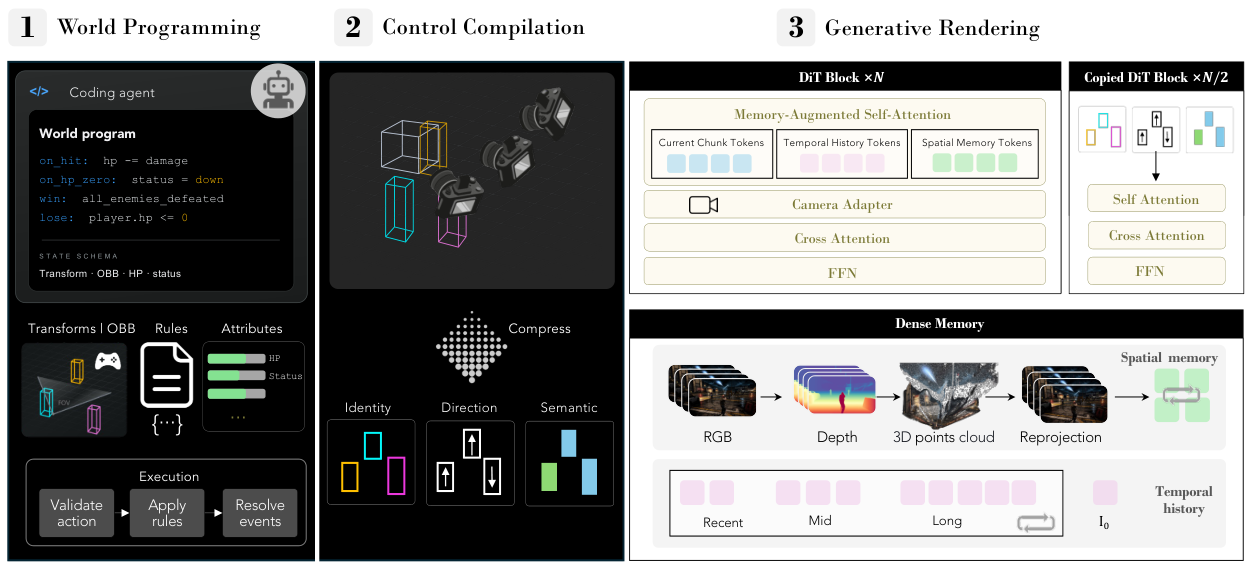
图 3 的程序、编译器与生成渲染器各自负责什么?
- 1
图 3①:把自然语言变成可执行世界程序
初始图像先检测可见实体和 3D 布局;编码智能体按持久 ID 指定血量、阵营、交互关系与事件规则。轻量引擎验证动作、执行规则、解决事件,维护视野外实体及不可见属性。程序本身若写错,画面逼真也不能修正逻辑。
- 2
用状态增强的 3D OBB 规定控制边界
每个实体用中心、尺寸、朝向加 ID、类别与状态表示。它比二维框可跨视角投影,又不要求引擎生成精细骨骼、网格和材质;姿态细节及次级运动仍交给视频先验。因而可编程的是显式状态与粗几何,不是每一处像素或接触动力学。
- 3
图 3②:确定性编译成三类像素对齐条件
在目标相机下投影 OBB,深度缓冲处理遮挡;身份槽固定跨帧对应,语义编码提供类别,方向编码把世界速度转换到相机坐标并量化为七类。静止实体即使因相机移动在画面上位移,方向仍为静止,以减少相机运动与物体运动混淆。
- 4
图 3③:冻结视频主干,训练结构控制分支
以 LingBot-World-v1 为基础,保留相机条件,增加 Structured Spatial ControlNet,逐层向冻结主干注入实体控制。它负责将程序状态变成视觉结果,但生成器仍可能不服从条件;外部事实正确和画面正确是两件事。
- 5
图 3 下:分块生成与几何记忆维护长程外观
块内双向去噪、块间因果传递;近期历史保留更细分辨率,远期历史更粗,并保留初始帧锚点。已完成帧经深度和相机信息提升为世界空间记忆,再重投影到未来视角。只使用已完成块,避免未来信息泄漏;深度估计错误仍会污染外观记忆。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【表 1】CombatStateBench 为 50 段,Count Accuracy 在每段 8 帧共 400 帧上计算,为 94%;State Accuracy 为 98%。 §5.1–5.2,表 1 ↗
我的解读后者只要求一次死亡事件之后抽取的三帧中至少一帧出现死亡角色,不要求认出是哪一位。因此 98%不是完整实体身份与所有状态全程正确率。
来源证据【评价设置】Qwen3.6-27B 仅看生成 RGB;基线 LingBot-World-V2/YUME 通过提示切换表达状态,本方法接收结构控制。 §5.2,基线与评价 ↗
我的解读这是系统接口能力比较,控制信息不对称;不能全部归因于视频主干更强。还缺少人工评审与 VLM 计数误差的充分交叉验证。
来源证据【图 5】展示 897 帧自回归序列、转身后显露离屏角色及不同题材场景。 §5.3,图 5 ↗
我的解读这些是定性样例,不等于 897 帧逐实体状态准确率已量化,也不证明碰撞、接触、资产拓扑或物理一致。
开放情况与使用许可
已打开作者项目与 GitHub;核验时仓库仅有 README 和 assets/teaser.png,没有训练/推理实现或权重,不能视为已经开源模型。
LICENSE论文 CC BY 4.0;占位仓库未确认软件 LICENSE 或模型许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
离屏状态不再依赖有限视频上下文记忆,程序日志提供了明确的正确性参照。
反方 · 哪些结论还不够
世界状态的一致性主要由外部引擎维护;宽松死亡判据和不对称条件限制了数字的解释范围。
综合判断
重要的是状态与渲染的接口设计,当前证据尚不足以证明通用、物理可靠的世界模拟。
我会先做的验证
未执行的验证方案:建立逐实体 ID、血量、物品和离屏事件日志;人工核验长序列中回到旧视角后的对应关系,并与同样控制信息、去掉几何记忆的消融比较。