PVBench:把视频物理可信度拆成对象级测量
画面像真的,是否意味着对象持续存在、动量和能量也合理
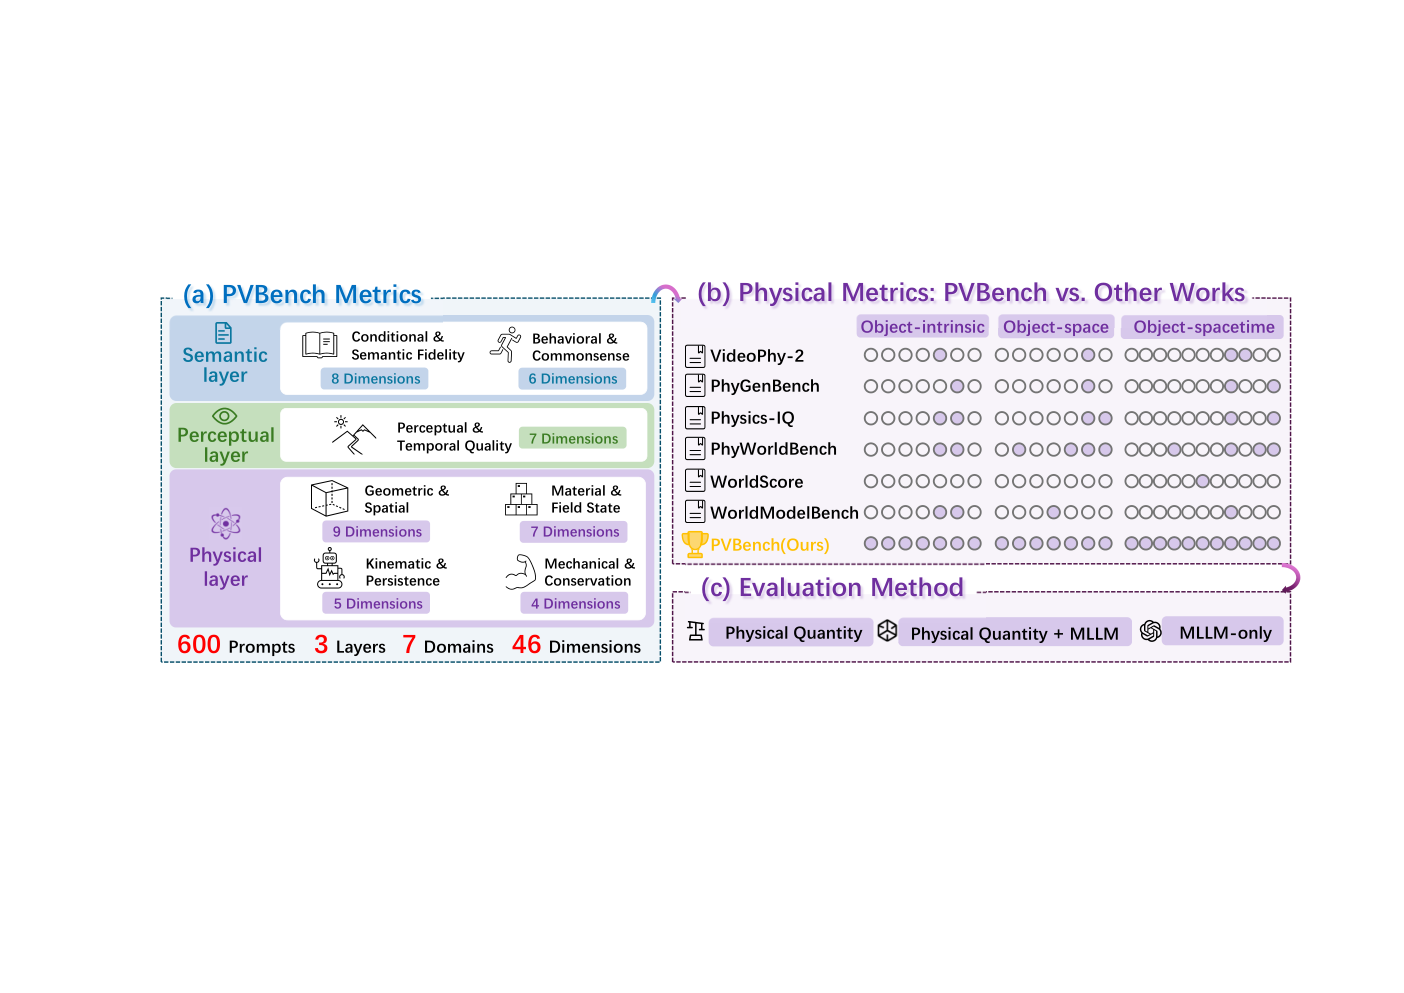
PVBench用600组配对文生视频和图生视频场景,评估46个维度,其中25项聚焦物理。它把分割、深度、法线、姿态与运动追踪组合为对象级测量,再检查几何和动力学关系。总体人工相关性较好,但各维度可靠性差异很大,生成失败和无法评估样本的分母也需要单独阅读。
图解主要方法
画面像真的,是否意味着对象持续存在、动量和能量也合理
- 1
图1(a):先指定可观察的物理问题
600组包含230个单维、230个双维和140个困难场景,180组涉及具身任务。提示词经模型辅助与人工复核,图生视频首帧由图像模型生成;两种生成方式共享场景描述,并不保证实际初始像素相同。
- 2
图1(c):从像素估计对象状态
SAM3分割对象,深度、法线、6D姿态与空间追踪模型估计距离、速度、接触和变形。25个物理维度分为17项数值、4项混合和4项MLLM评判;这些量主要来自视觉估计,并非仿真器提供的物理真值。
- 3
把状态转为约束残差
例如利用提示中给定的质量比检验碰撞动量,以尺度校准的深度检验动能和势能变化;摩擦情景检查能量不增加。残差经过手工阈值映射到1–5分,再汇总为百分制。材料、热和电磁等不可直接测量部分仍依赖语言视觉判断。
- 4
同时读分数、覆盖率与人审
系统按维度计算均分,但部分生成失败或感知不可用样本被排除。单一总分之外应保留每维有效分母、跳过原因及与人工的相关性,防止某模型因为困难样本未进入评价而显得更好。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据六个模型分别做T2V/I2V,目标720p、10秒、24fps、固定种子,总计约7200段,评价使用单H20 95GB。Seedance T2V语义92.2、感知68.4,而机械守恒仅30.0。 实验设置与主表 ↗
我的解读语义与物理分差说明评估必要性;不同专有接口和原生生成条件仍可能影响横向比较,不能把该排名解释为统一算力下的能力排序。
来源证据三个T2V模型、25个物理维度、每维五提示,共375视频、10名评分者,ICC为0.89;总体Spearman为0.772、Kendall为0.643。但对象永久性相关性仅0.125、连续性0.240。 人工验证 ↗
我的解读总体一致不能替代逐维可靠性;每维样本较少,永久性等判断不宜当自动验收金标准。
来源证据报告跳过比例约1.05%–4.84%;Seedance I2V有69个维度实例因生成阶段缺失从951降至882,随后15个跳过以882计。SAM置信阈值调整亦显著改变相关性。 覆盖率与校准附录 ↗
我的解读生成失败应另计,不能只看评价阶段skip率;感知模型和阈值会改变结论,应报告端到端覆盖而非只报告成功处理视频。
开放情况与使用许可
2026-10-21实际打开作者项目页和GitHub文件树,仓库含evaluate.py、pipeline、物理评价模块及配置;LICENSE为MIT。论文为CC BY 4.0。依赖的视觉模型、API与数据需分别遵循各自许可,未执行仓库复现。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
给出了比整体视觉印象更可诊断的物理评价接口,能区分几何、材料、运动与力学失败,也公开了实际评价模块。
反方 · 哪些结论还不够
对象状态由有误差的感知模型估计,很多维度没有真值;固定种子、阈值校准与未评价样本处理限制外推。部分维度人工相关性弱,数值化并不自动等于物理正确。
综合判断
适合做多维物理诊断和失败筛查,尚不足以单独认证世界模型的物理可靠性。
我会先做的验证
未执行的验证方案:用有真值的合成场景逐项注入物理违例,分离感知误差和物理判断误差;换追踪与深度后端、多种子、留出阈值校准集,并把生成失败纳入完整分母,报告逐维置信区间。