Qwen-Image-2.1:让图像生成进入透明图层与资产编辑流程
从混合粒度注意力、潜空间压缩到偏好训练:哪些已由 2.1 实现证实,哪些仍只是前代背景
Qwen-Image-2.1 将生成、编辑和透明输出统一起来。本文结合新版架构图与代码,以及 2.0、VAE-2.0、2.0-RL 三份报告,解释缓存为何成立、压缩如何影响细节、偏好训练怎样权衡任务,并明确版本与证据边界。
图解主要方法
为什么静态输入能被缓存,压缩与偏好训练又怎样影响可用的视觉细节?先分清版本,再对照图和实现。
- 1
先划清版本与证据范围
本次读取了 2.0、VAE-2.0 与 2.0-RL 报告正文及 RL 附录,并检查 2.1 官方博文、权重配置及已合并推理实现。尚未找到 2.1 独立技术报告;以下“2.1 已核实”来自新版公开资料,“前代背景”仅解释技术路线,不代表新版采用了相同训练配方。图 A 属于 2.1,图 B 属于 2.0。
- 2
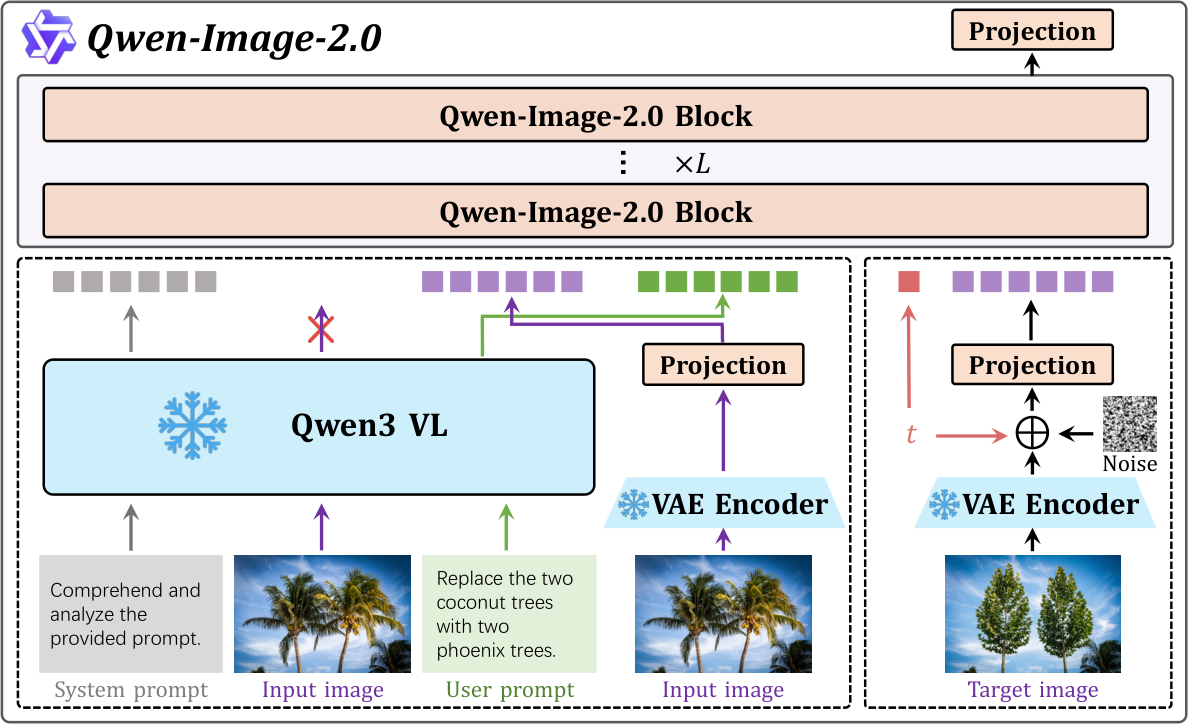
图 B:理解条件和保留像素细节是两条路径
【前代背景,2.0 §3】左侧冻结的 Qwen3-VL 理解系统提示、输入图与编辑要求;输入图另经 VAE 编码提供局部视觉潜变量。图中红叉表示视觉位置由 VAE 表示替换,不能将“语义理解”当成全部图像细节。右侧目标图加噪是训练示意,推理时没有真实目标图可供输入。
- 3
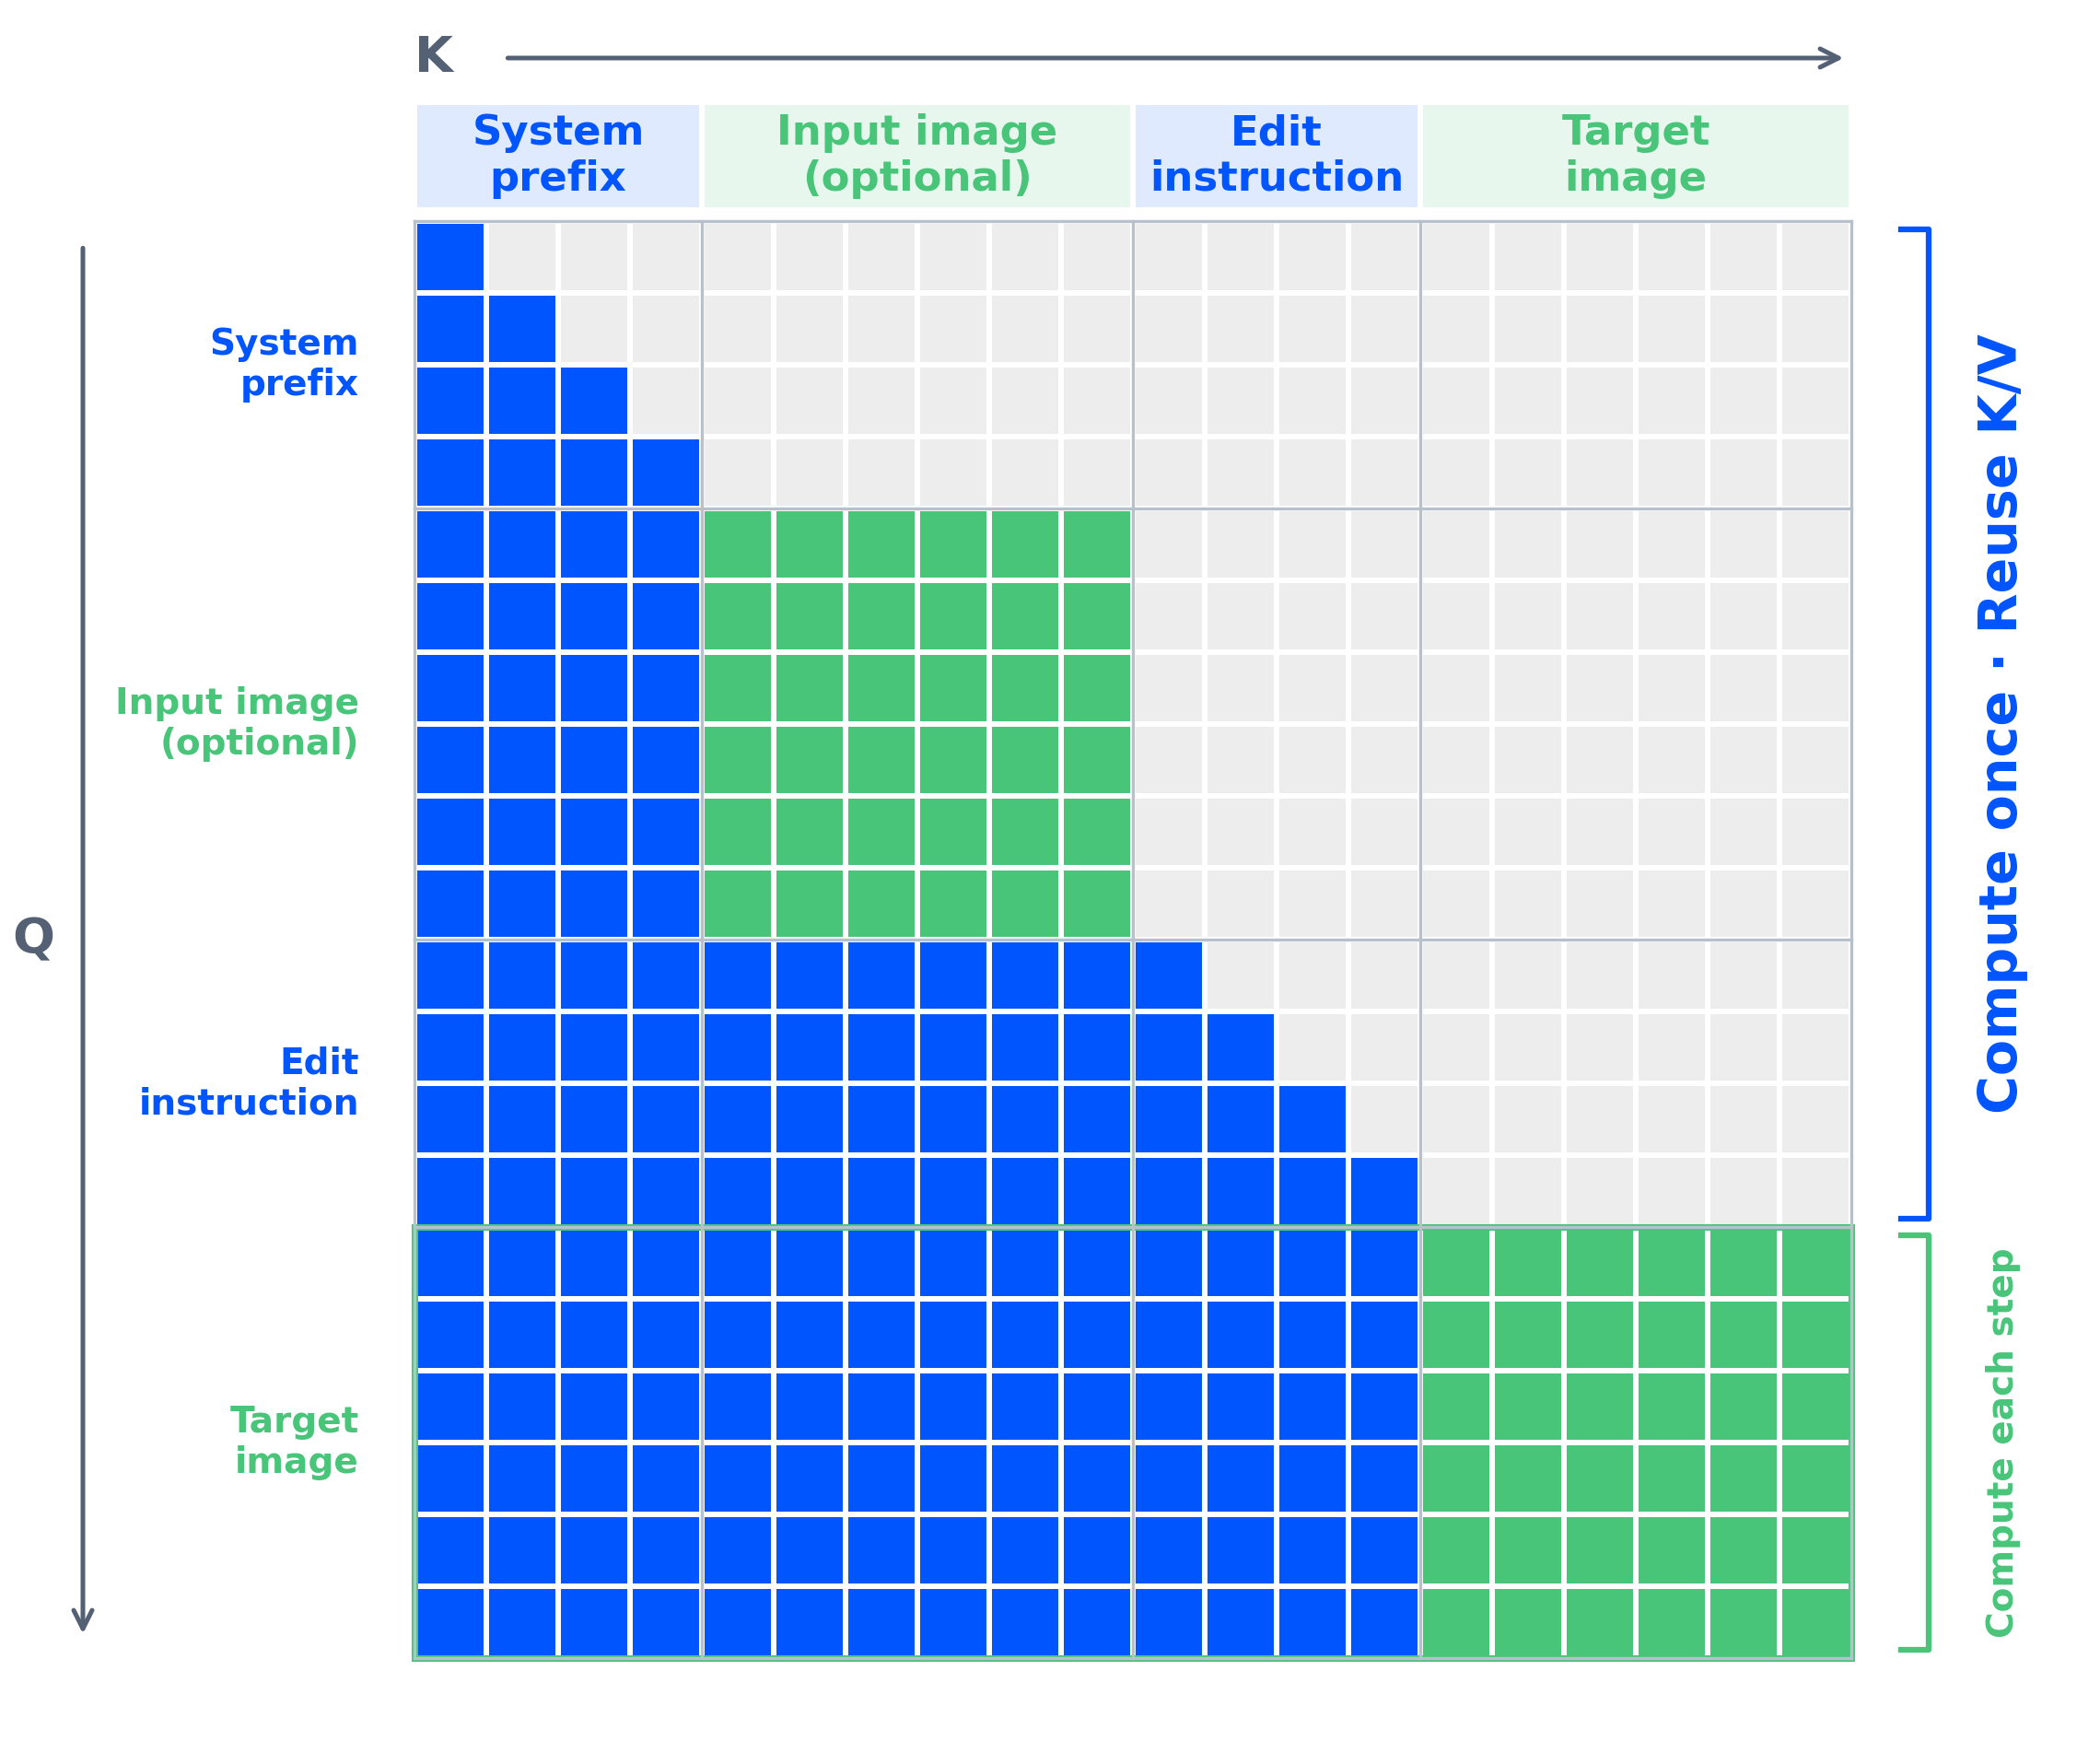
图 A:文字逐 token 因果,图像块内双向
【2.1 已核实】横轴 K 表示被读取的键,纵轴 Q 表示发起读取的查询。蓝色文字区沿序列形成因果结构;绿色图像块内各位置可互相读取;灰格被屏蔽。目标图像可读取前缀和整个自身块,前缀不能反向读取正在改变的目标。它不是按像素从左到右逐个生成,而是在每个去噪步更新整块图像表示。
- 4
缓存成立的两个条件:看不到目标,且时间条件不变
【2.1 代码核验】图 A 右侧上半部只算一次,底部每步重算。transformer_qwenimage21.py 将文字和条件图像的调制时间固定为 t=0,目标图使用当前 t;再由块因果掩码阻断目标对前缀的反馈。两者共同让前缀 K/V 不随步骤变化。pipeline 首步使用 extract,后续使用 cached;只固定原始输入却让前缀继续读取噪声目标,不能得到同样的精确复用。
- 5
缓存省在哪里,仍然要付出哪些计算
【我的计算解释】设静态前缀长度 P、目标长度 T、采样步数 S。后续步骤少做 P 个前缀 token 的层内更新,但目标仍需读取 P 个前缀键和 T 个目标键,目标注意力规模仍含 T(P+T)。缓存还占用逐层 K/V 显存。因此多参考图可能更受益,却不能只凭“缓存”推出固定加速倍数,更不能推断参考图数量增加没有成本。
- 6
16 倍空间压缩的收益与代价
【2.1 配置核验】发布的 VAE 为输入/输出各 4 通道、z_dim=64、scale_factor_spatial=16;DiT 为 32 层、32 头、每头 128 维,patch_size=1。按这些配置计算,2048×2048 图像对应 128×128 个空间潜位置,即 16384 个位置。f8c16 与 f16c64 的潜标量总量相同,但后者空间位置更少、每个位置通道更多。注意力收益不能简单当作整条管线的加速率,细笔画和 alpha 边缘仍可能在压缩中损失。
- 7
VAE 论文:让压缩表征既能重建,也容易生成
【前代背景,VAE-2.0 §2–4】全局跳接把像素空间折叠进通道,给高频细节一条直达路径;训练结合像素 L1、LPIPS 和语义对齐,未用 KL 或 GAN 损失。早期严格对齐 DINOv2 中间特征,后期放松约束,让语义结构与重建细节折中。关键问题是“原图压得好”不保证“噪声容易生成该潜分布”。新版残差、无注意力 VAE 配置与这条路线相符,但配置不能证明透明数据构成、损失权重或训练阶段照搬。
- 8
基础训练:先学语义,再提高分辨率与编辑占比
【前代背景,2.0 表 2】报告给出 700K 步预训练、250K 步继续预训练和约 10K 步 SFT;分辨率逐步进入 512/1024/2048,文生图/编辑混合比由 9:1 变成 7:3。我的解读:统一生成编辑来自任务数据和训练权衡,不能只用网络能接收多张图来解释。2.1 的训练预算、透明样本占比和相应消融尚未在已读资料中核实。
- 9
偏好训练:先分任务优化,再在学生轨迹上合并
【前代背景,2.0-RL §3–4】生成教师关注对齐、审美和人像,编辑教师关注指令及身份。GRPO 按同一提示下的一组样本归一化各奖励后加权;采样使用 CFG,策略优化排除无条件分支,并选择部分偏高噪声步骤来减缓奖励投机。OPD 再让统一学生沿自己的轨迹匹配对应教师的速度:L=Σ‖v学生(x_t,t,c)−v教师(x_t,t,c)‖²。它解决的是任务能力合并,不能据此宣称 2.1 已被证明采用该训练流程或拥有 4 步推理能力。
- 10
RGBA 输出:透明度是图像变量,不是三维材质
【2.1 已核实与编辑判断】管线将条件图转为 RGBA,VAE 解码得到颜色和 alpha。这里 alpha 表示合成时的透明度,不等于物理透射率,也不携带粗糙度、金属度或表面法线。新版原生透明输出有利于贴花与合成素材研究;把它放到三维项目中仍需单独验证边缘、UV 接缝、尺度以及不同视角的一致性。
实验与证据
下列条目将官方 2.1 结果、前代论文实验和实现核验分开。本站未训练或运行模型,所有实验数字均来自对应来源;2.0 系列报告用于解释路线与证据边界,不转写成 2.1 的实测结论。
来源证据【2.1 官方结果】发布博文的 Qwen-Image-Bench 图列出 60.28 分,并将 7B 明确限定为视觉生成组件。 2.1 官方评测图与说明 ↗
我的解读这是发布方图表,不是本站独立评测。该图没有列出这次运行的全部提示改写、采样、样本数与置信区间;不能把分数差直接归因于缓存,也不能把 7B 当作整条模型管线的参数量。
来源证据【2.0 表 1】256×256 ImageNet 验证集上,前代 Qwen-Image 与 2.0 VAE 的 PSNR 同为 33.42,SSIM 从 0.9159 到 0.9225;内部文字集的 PSNR 却从 36.63 降到 32.81。 2.0 §3.1 表 1 ↗
我的解读同一表存在不同方向的指标,不能写成全面超越。它测的是特定前代 VAE 重建,不是 2.1 文生图能力;内部文字集的外部可复核性也有限。
来源证据【VAE-2.0 实验】OmniDoc-TokenBench 约 3K 文本图,f16c64 的 NED 为 0.9244,f16c128 为 0.9617;论文定义是 1−归一化编辑距离,越高越好。下游生成比较使用 ImageNet 256、80 epochs、无 CFG。 VAE-2.0 §5–6 ↗
我的解读NED 比较原图与重建图的 OCR 输出,不是真实文字正确率。不能拿 128 通道的最好成绩替代 2.1 的 64 通道 RGBA 配置;这份报告还注明 2.0 使用的是中间变体,两篇报告数值不可直接拼接。
来源证据【2.0-RL 表 1】Qwen-Image-Bench 的总分由 55.23 到 57.84;评测使用基于人工标注训练的 Q-Judger。论文另给出混合 RL 与分任务教师再 OPD 的定性对比。 2.0-RL §5、表 1 ↗
我的解读这些属于 2.0-RL,不是 2.1 成绩。自动评委的偏好与实际资产验收可能不同;定性案例不足以量化 OPD 相对混合 RL 的全部贡献,也没有提供三维几何正确性的证据。
来源证据【实现证据】2.1 已公开的管线首步提取前缀缓存、后续复用;权重配置确认因果条件、32 层及 RGBA VAE。 固定提交的 2.1 推理管线 ↗
我的解读这直接支持机制存在,但本次未运行模型,不能声称在本站设备上验证了加速、显存、输出质量或 alpha 精度。
开放情况与使用许可
已核实 2.1 的实际权重、推理代码、架构配置与官方方法图;已读 2.0、VAE-2.0、2.0-RL 报告。尚未找到 2.1 独立技术报告,未核实其完整训练数据、透明数据配方及消融,不能称为全训练链条开放。
LICENSEQwen Research License Agreement,发布日 2026-09-20。第 2 条仅授予非商业研究或评估用途,商业使用需另行取得许可。本站“开源 / 开放”筛选表示权重或代码可取得,不表示无条件商用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:透明图层减少素材从生成到合成之间的格式障碍,值得用实际抠图和编辑任务检验能否节省返工。
可下载权重与可检查的推理实现,使固定版本、固定种子的研究评估更容易落地,也方便定位工作流中的失败环节。
反方 · 哪些结论还不够
漂亮的单张结果可能掩盖局部身份漂移。资产流程往往要求同一物体在多次修改中保持结构,这比一次生成的审美分数更严格。
贴花和材质候选仍需处理尺度、重复纹理、光照烘焙和接缝。二维生成的提升不能直接兑换成可用三维资产,许可条件也会影响落地范围。
前代 VAE 表格已经说明不同细节指标可能相互冲突。用自然图像的平均质量替代 alpha 边缘、小字或贴花接缝检查,可能在实际资产任务中漏掉最昂贵的返工。
缓存机制与品质改进应分开归因;质量还受训练数据、提示增强、采样和偏好优化影响。只有固定其余条件的消融才能量化单一技术的贡献。
综合判断
值得作为图像生成与资产编辑基础模型跟踪。当前最有依据的价值是可获得的二维生成编辑能力;它对三维生产效率的实际贡献,应以返工时间和一致性验收来衡量。
我会先做的验证
未执行的验证方案:选取 20 个有权使用的主体,覆盖细发丝、透明物体、文字标识与硬边产品。固定模型版本、提示词和采样设置,每例运行 3 个种子,对比普通生成后抠图与原生透明生成;盲评边缘色晕、身份保留和局部编辑外溢,并记录人工修正分钟数。再将候选贴花贴到同一测试网格上,检查接缝和不同背景下的边缘。所有结果完成后再报告,不预设获胜方案。 增加机制消融(仍未执行):同一固定提交、权重、精度、设备及种子下,比较 KV 缓存开/关,分别用 0、1、5、10 张参考图,记录首步预填充、后续步耗时、峰值显存与输出差异;预热和编译时间单列。质量侧用相同分辨率与预算对比提示增强开/关,记录小字 OCR、未编辑区变化与 alpha 边缘误差,禁止把性能测量与不同提示词的质量比较混在一起。