RealMe:从稀疏拍摄补出跨视角一致的2K体积视频
生成的细节更清晰,是否也能约束一个统一的4D场景?
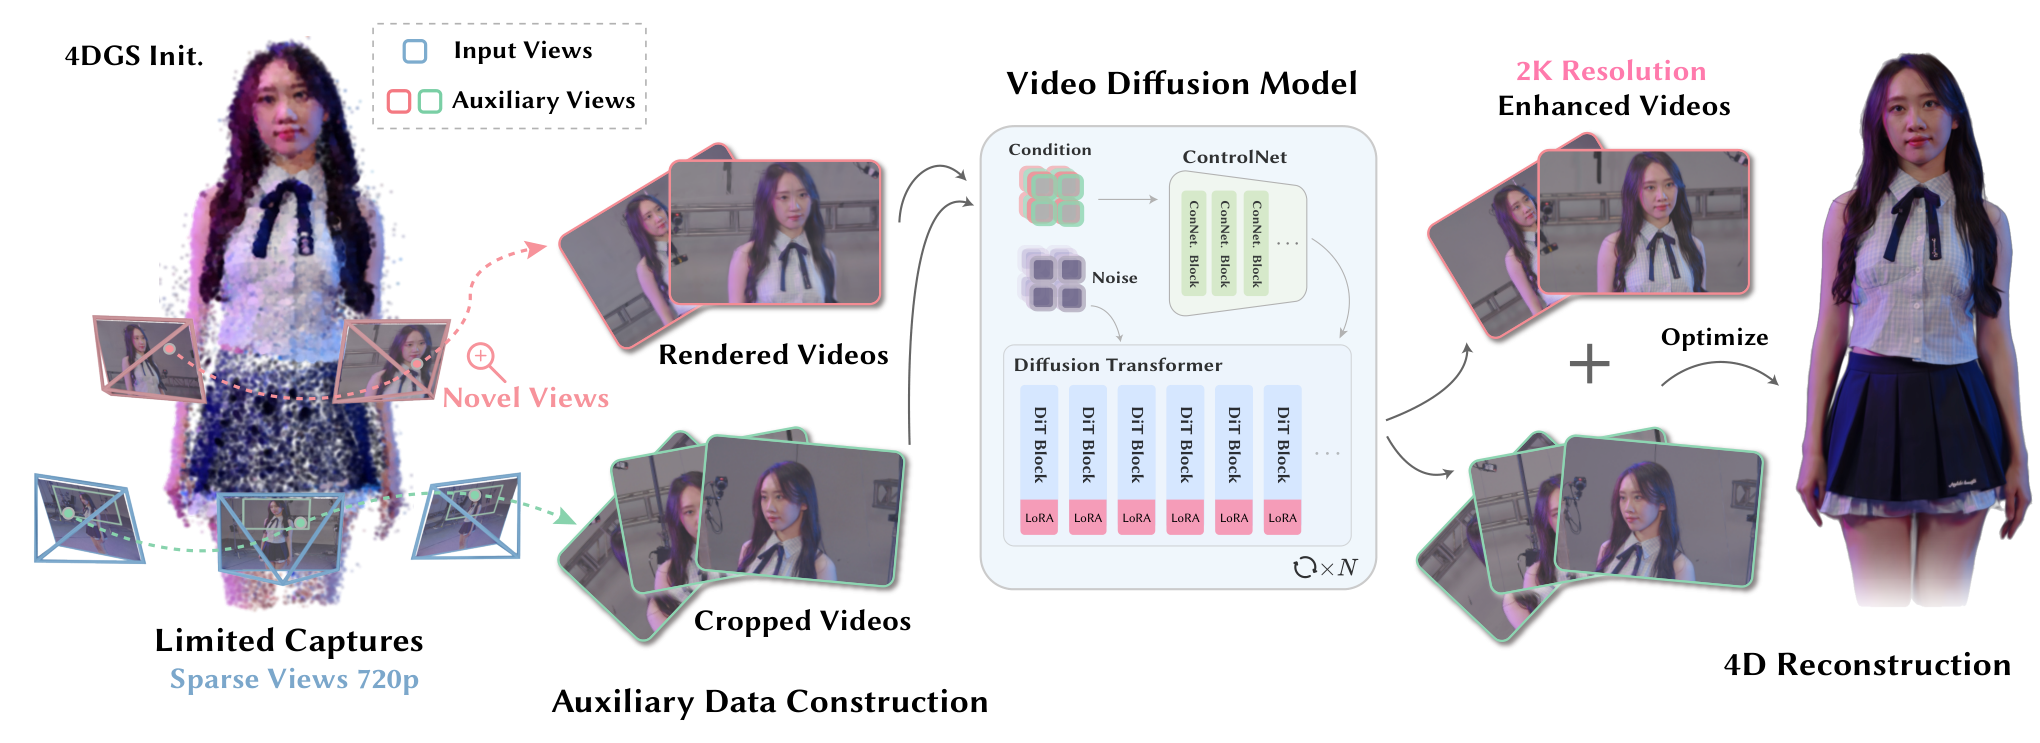
RealMe先重建粗4DGS,再同时增强新视角与局部细节视频,最后把生成视图和原始拍摄共同用于重建。核心是跨时间、跨相机的生成一致性,而非从几张照片直接得到可重光照的材质资产。
图解主要方法
生成的细节更清晰,是否也能约束一个统一的4D场景?
- 1
图2左侧:先提供几何条件与局部ROI
稀疏拍摄初始化FTGS,插值相机渲染辅助新视角;离线检测器裁出脸部等细节ROI。两类条件分别增强,ROI再按记录框映回原相机坐标,避免裁剪图被误当完整相机视图。
- 2
图2中部:把图像先验改造成多视角视频模型
FLUX.1 dev配ControlNet与rank32 LoRA,冻结原DiT主体、VAE和文本编码器。位置编码加入时间和视角,与二维latent坐标组成四轴;每三次时间注意力配一次跨视角注意力。
- 3
训练时约束潜空间频率
在流匹配之外,对干净latent预测施加FFT幅度差损失,按扩散时刻调整两类频率分支权重。此处不等于保证真实毛发或衣物纹理被恢复,生成先验仍可能补出不存在的细节。
- 4
图2右侧:回到统一4D表示
最终使用8个原始视图与40个增强视图共同优化完整场景4DGS,保持同监督权重。输出可做动态新视角渲染,但没有报告UV拓扑、纹理接缝、PBR分解或去光照/重光照能力。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据RealVV留出7序列,8输入视角,报告PSNR 27.2706、LPIPS .1621;DNA-Rendering四序列零样本为25.5956/.1261。 Table 1、数据协议 ↗
我的解读作者数据上的优势需结合基线域差;Diffuman4D前景掩膜评测与完整场景能力不能混称完全同范围比较。
来源证据4D重建一致性PSNRc 28.0756;TWE .00551,好于生成基线但劣于FTGS .00299;4→8视角收益明显,16视角部分指标并不单调提升。 Table 3、4 与消融 ↗
我的解读一致性指标是生成视图与其拟合渲染的差,非独立真值;低TWE还可能来自过平滑。
来源证据单H100、4帧2560×1440、30去噪步的扩散推理135.1秒、48.1GB,未包括初始和最终4DGS优化。 Appendix B.6 ↗
我的解读不能把体积视频播放帧率当生产吞吐,也不是完整管线只需135秒。
开放情况与使用许可
仓库目前仅README、LICENSE和展示资源,明确代码内部审核中、数据待发布。PRL v1.0要求组织项目使用前登记;不能因已有LICENSE就称实现开源。底座FLUX也有独立许可。
LICENSECC BY-SA 4.0(arXiv版本标注);代码许可另述
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把新视角与ROI增强送回共享4DGS,是检验生成细节能否被统一场景解释的具体路线。
反方 · 哪些结论还不够
粗几何无效时会失败;训练仅20演员100序列,对大场景和复杂相机泛化有限。细节增强不等于测量真实纹理。
综合判断
适合有限拍摄下体积视频研究,距离可编辑、可重光照的工业资产仍有明显接口缺口。
我会先做的验证
未执行的验证方案:留出完全不参与生成的真值相机,比较细节与身份漂移;独立测长时间一致性、总处理时长,并尝试换光照以暴露烘焙外观。