RWM:在表征中连一条路径,再把局部段落解码成动作
省去前向动力学搜索,但路径的可执行性依赖训练分布
Representation World Model 不反复展开候选动作的未来图像,而是学习一种状态表征:在当前与目标之间构造潜空间路径,用浅层逆动力学将相邻点变成动作,再观察并重连路径。收益依赖表征把可执行的过渡组织得足够平滑。
图解主要方法
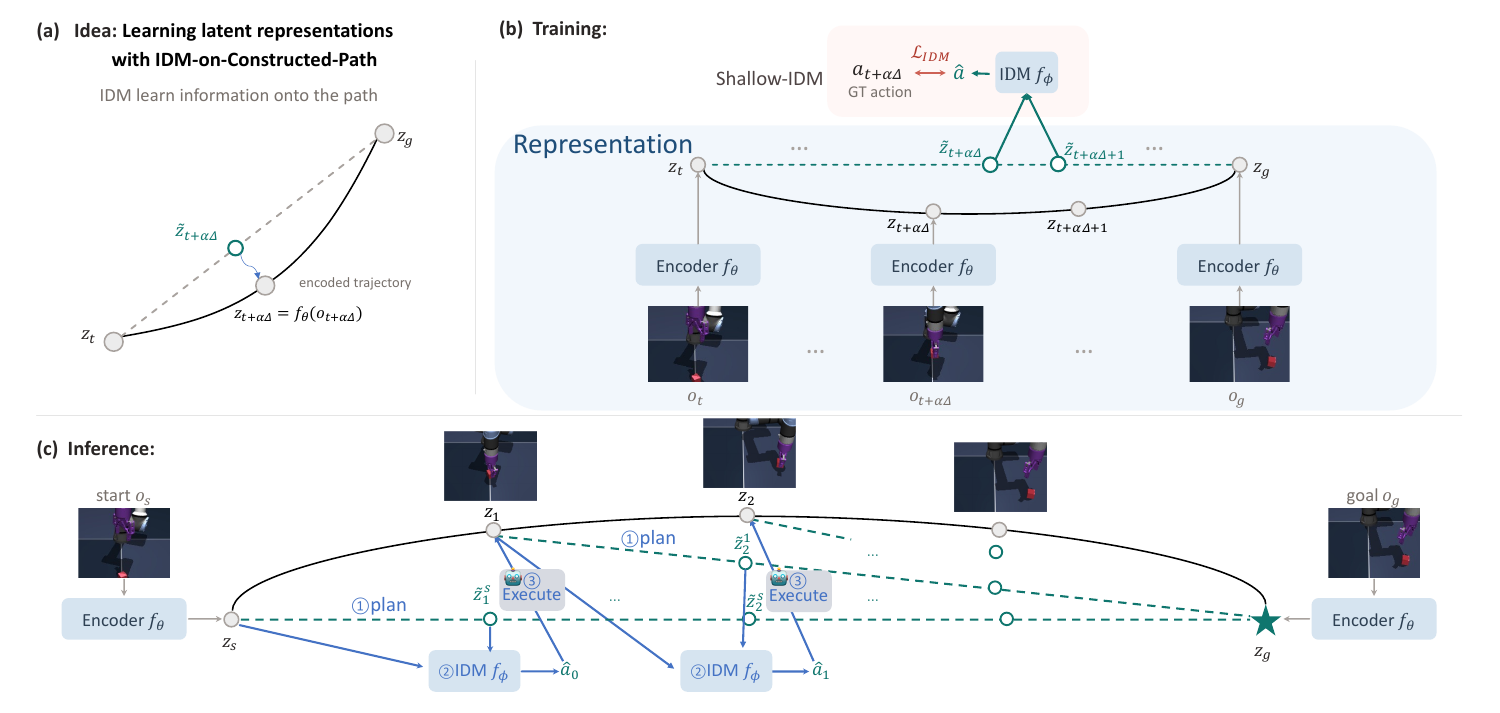
图 2 中的直线路径如何受到真实动作监督,又在哪里重新接上真实观测?
- 1
编码端点,构造潜空间中的插值路径
图 2 左上把轨迹中的当前与后续目标图像编码为 z_t 和 z_g,再按时间比例构造中间点。它是潜变量直线,不是直接在像素或机械臂位置上画直线;隐式前提是学到的表示能让路径附近存在可执行过渡。
- 2
用浅层逆动力学约束局部路径段
图右上 IDM 读取相邻插值点预测真实记录动作,动作损失同时回传到端点编码器,促使表示具备可解码的过渡结构。另有真实编码状态的 IDM 与一致性辅助项;不是先固定任意视觉特征,再期望插值天然可行。
- 3
执行少量局部动作,重新观察并连线
图下每次沿当前—目标路径解码开头一段动作,执行 h 步后重编码新观测,再面向同一个目标构造新路径。它避免显式前向世界模型和候选动作搜索,但仍需要观测反馈,不能把一次潜空间连线当成完整可靠轨迹。
- 4
区分目标图像条件与任务条件扩展
基础实验输入可见目标图像;LIBERO 没有同样目标接口,因此增加预测潜变量增量的模块、机器人本体状态和任务 ID。这个变体不是直接照搬“当前—目标图像线性插值”,两组结果应分别解释。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【四环境匹配对照】ViT-Tiny、224 图像、3 层 MLP IDM,90/10 样本划分,8 张 RTX5090、batch128、10 epochs;三训练种子各三评估种子,宏平均成功率 98.25%,匹配 INTACT-guard 96.86%、IDM 95.33%。 设置、主表及实现附录 ↗
我的解读我的解读:在这些轨迹与目标分布上有竞争力;样本级划分不等于全新场景泛化,外部方法结果也不全是严格配对重跑。
来源证据【闭环步数与路径监督】一组 h=5 成功率 98.33%,h=25 为 69.17%;PushT 去掉插值相关训练项为 39.37%,完整配置约 96%。 执行步长与损失消融 ↗
我的解读我的解读:支持路径监督的重要性,也说明频繁重新观测在维持高成功率中扮演关键角色。
来源证据【任务条件变体】LIBERO 报告约 0.03B 参数、93% 成功率,对比外部 RC 0.07B/81.2%、OpenVLA 7B/97%。 LIBERO 扩展实验 ↗
我的解读我的解读:更小参数并不等于已证明更低端到端时延;任务输入和训练流程不同,也不能据此宣称全面超过大 VLA。
开放情况与使用许可
09-24 首发;17 页 PDF 全文及附录已读。论文所列项目地址本次返回 404,未确认可用专属代码、数据或权重,不将论文视为开源。
LICENSE论文及图 2 为 CC BY 4.0;实现和权重许可未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把动作监督直接施加到构造的表征路径,为免搜索规划提供了可检查的表示学习机制。
反方 · 哪些结论还不够
插值未保证避障、接触拓扑或多模态路径可行;闭环频率影响很大,LIBERO 又依赖新增模块与任务条件。
综合判断
适合先在有目标观测、短局部动作可反馈的任务中评估,不能代替复杂约束规划或视为通用物理模拟器。
我会先做的验证
未执行的验证方案:按完整轨迹和场景留出测试,构造必须绕障与接触切换的多路径任务;固定感知与调用预算比较 IDM、前向搜索和 RWM,测成功率、碰撞率、时延及不同 h 的退化曲线。