Richer Material Generation
用程序化数据增强突破简单 PBR 的表达上限
把常见的单层高光材质扩展成包含清漆、灰尘和分层散射的训练数据,再学习神经材质生成。7 月发表于 SIGGRAPH,预印本首发为 6 月 12 日;关注点是材质数据的表达能力。
图解主要方法
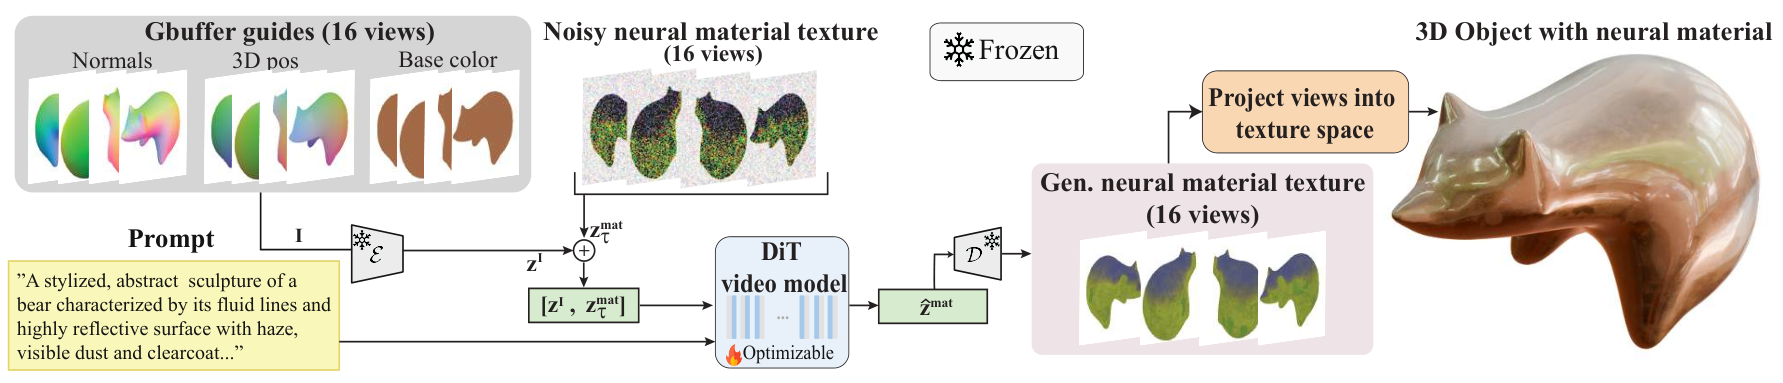
如果数据里的材质只有单一高光,再大的模型也缺少学习涂层和灰尘的监督。本文先扩充材质模型,再学习紧凑神经表示,最后做条件生成。图 9 展示的是这条路线的下游生成环节,不是从文字直接生成整件几何。
- 1
读图前:先扩大数据能表达的外观
作者用程序化规则在原有 PBR 上增加多层非漫反射效果,再压缩为共享解码器可读取的神经材质。可以理解为先扩展“答案空间”,再训练生成器;若只换生成网络而保持旧表示,新增效果没有地方存放。
- 2
左侧:用已有几何限制生成
法线、世界坐标、基础颜色组成多视图 G-buffer 条件,与文字一起输入。图中的熊形状已经给定,因此论文这一阶段解决的是为对象生成丰富材质,不是同时学会对象的完整结构。
- 3
中间:生成的是材质潜纹理
含噪神经材质通过视频 DiT 去噪,VAE 编解码器冻结。两张 RGB 潜纹理合起来承载 6 维表示;这些数值需要神经解码器解释,不应该被当作普通 RGB 色图直接使用。
- 4
右侧:回投影到同一个对象
输出的多视图材质再投影回纹理空间。把视图变回资产这一环节仍要面对覆盖与接缝;更丰富的 BRDF 表达能力不能自动解决几何对应和纹理空间一致性。
实验与证据
作者同时检验材质表示的拟合和下游生成。区分这两类证据很重要:能压缩程序化材质,尚不能证明生成模型能稳定产出同样丰富且合理的材质。
开放情况与使用许可
论文与补充材料公开,项目页代码和数据仍未提供可用下载。按 7 月会议发表纳入回顾,同时保留 6 月 12 日首发日期。
LICENSE实现与数据许可证尚未核实
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我最认同的是先审计数据和表示的上限。材质生成的短板可能根本不是网络太小,而是训练数据从未表达过目标反射现象;这里给出了一条可操作的数据建设路线。
将程序化的可控性与学习式生成结合,也便于设计针对性的覆盖实验,例如单独增加清漆变化,再测模型能否理解而非只记住高光外观。
反方 · 哪些结论还不够
程序规则会把设计者的假设写进数据。让每种增强都能作用到每个对象,可能生成物理上可渲染、语义上却不自然的组合;模型也可能学习这些人为偏差。
更复杂的神经材质既增加表达空间,也增加验证和部署成本。有限对象上的结果不足以说明对真实扫描材质、不同尺度和各种引擎都有效。
综合判断
对材质生成方向,我会优先借鉴材质数据扩充和分层误差评估,不会先追求替换整套渲染模型。只有目标产品确实需要简单 PBR 难以表达的效果时,神经材质的额外复杂度才有充分理由。
我会先做的验证
保持生成器、样本数和训练预算不变,只改变材质增强规则;同时留出对象类别和组合效果。逐层测解析材质→神经表示→生成结果的误差,并检查最终引擎中新增效果是否仍可见。