RoboJEPA:潜在世界模型的规模收益,能否兑现为机器人规划能力?
从22M到8B预测器,以目标图像搜索动作;规模规律受编码器、数据和评测条件约束
RoboJEPA冻结视觉编码器,训练带动作、本体状态和相机身份的潜在预测器,再用交叉熵搜索寻找接近目标图像的动作序列。其规模实验连接了离线预测误差与机器人规划收益,但真实控制依赖较重搜索,个别任务并不随参数单调提升。
图解主要方法
离线想象误差降低,何时能预测真实机器人规划变好?
- 1
将多视图观测映射到固定特征空间
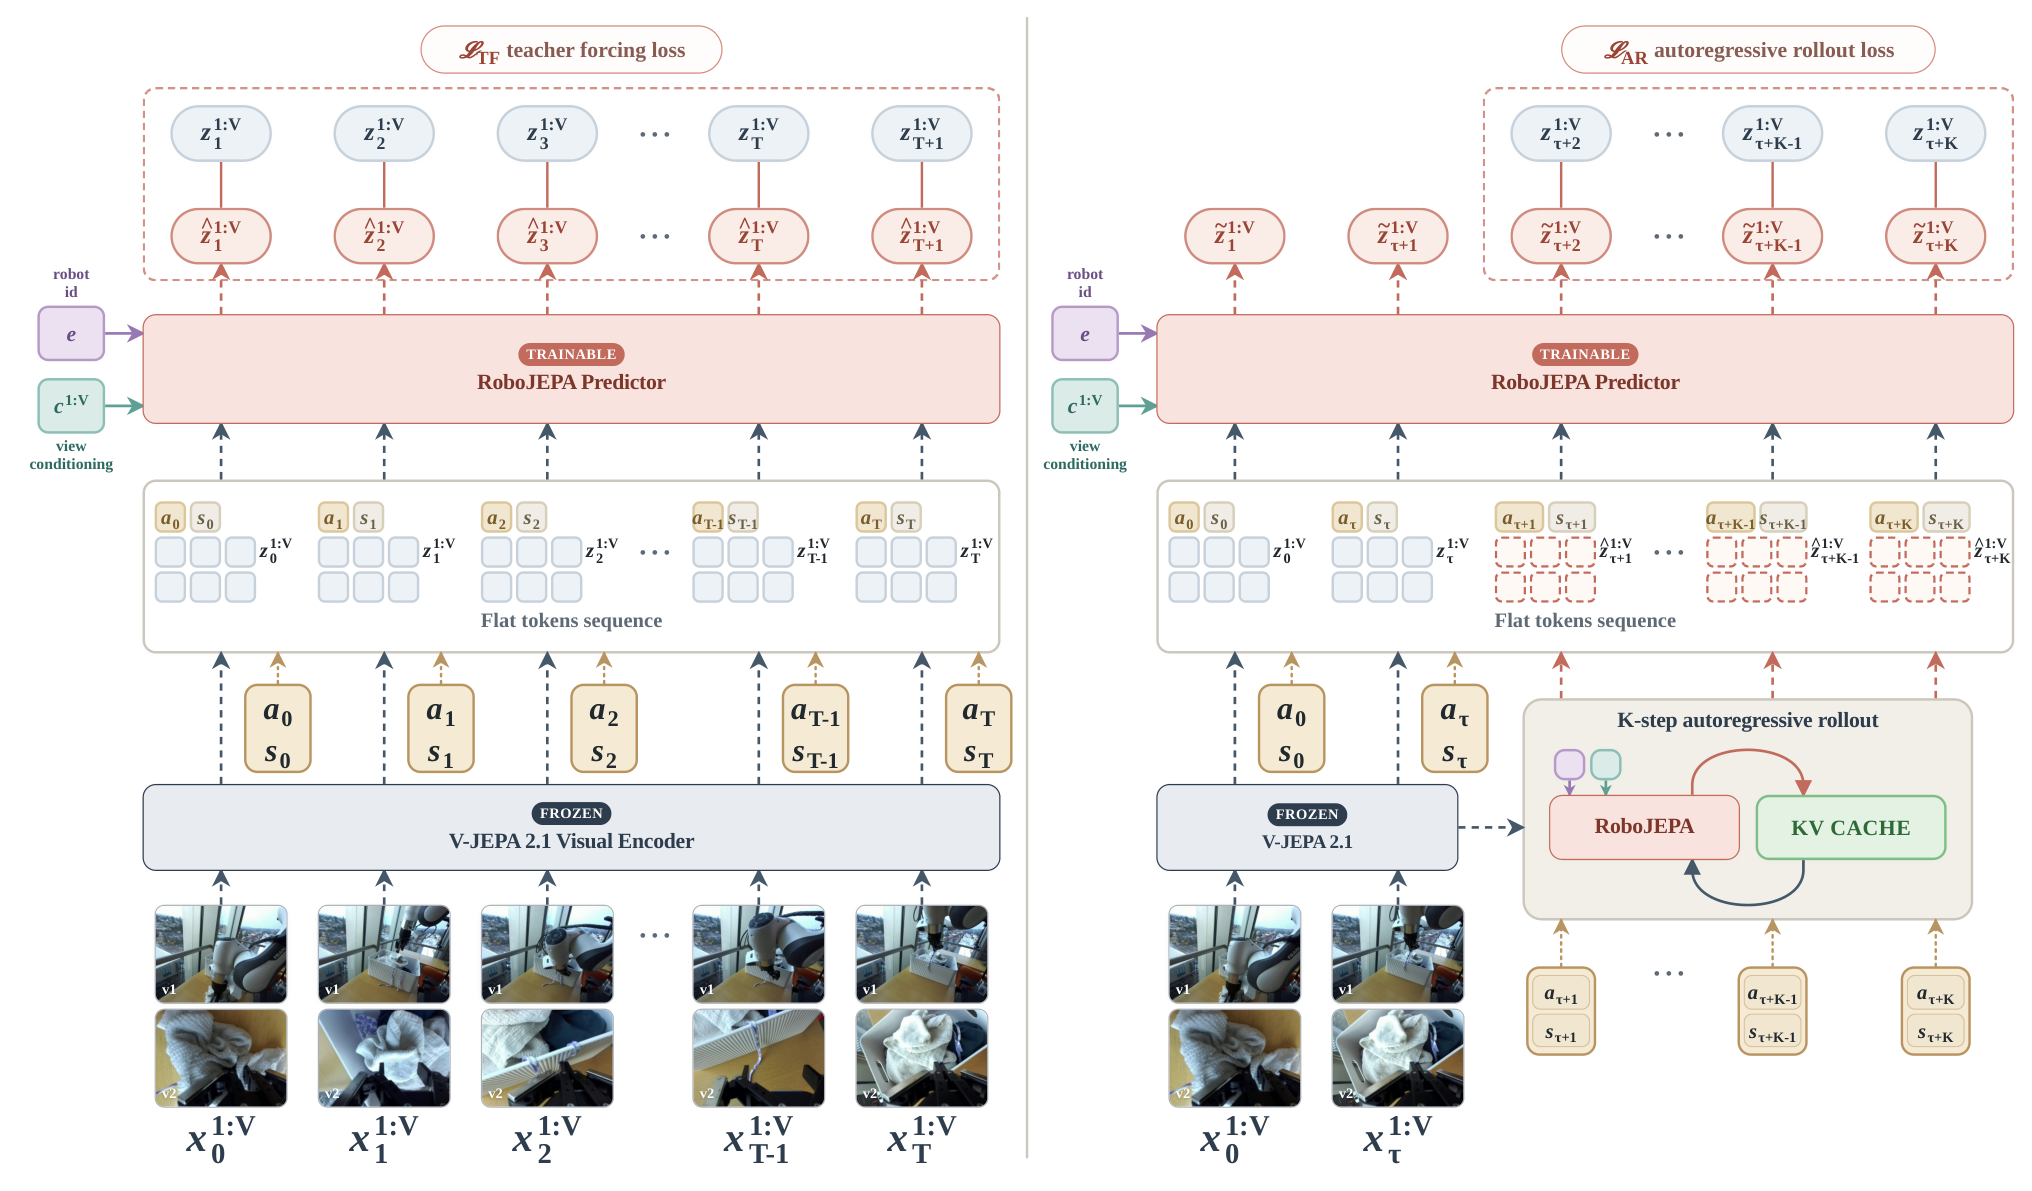
图3底部冻结的V-JEPA 2.1编码器把图像变成视觉token;每步拼入动作a与本体状态s,并加入机器人e和相机c身份。预测器使用帧内完整、帧间因果注意力,输出下一步特征而非像素。不同机器人动作填充到共同尺寸,再由各自映射进入模型。
- 2
同时学习看真历史与看自己预测
图3左侧teacher forcing用真实编码特征预测下一步,右侧用较短真实前缀启动,再把预测特征反馈进后续步骤。两项按token归一化的L1损失混合;滚动反馈停止跨步梯度,不能当作完整反向传播穿越长轨迹。
- 3
用更长滚动的冷却阶段改善闭环误差
基础配方滚动两步,后续冷却改为十步并混合240×320和480×640分辨率,使用KV缓存减少重复计算。此阶段不加入新数据,但每步计算更贵;证据对应整个配方,而非单独增加滚动长度。
- 4
在潜在空间比较候选动作与目标
推理编码当前观测和目标图像,CEM反复采样动作序列,用预测器展开未来,再按与目标特征距离挑选精英、更新采样分布。执行短前缀后重新观察和规划;图像解码器只用于观看预测,不参与规划得分。
- 5
将搜索开销与低层控制分开
真实机器人使用阻塞式末端目标控制;模型按动作搜索,不是一次前向就输出实时策略。多GPU候选并行、共享前缀缓存与预编译降低延迟,但预测器单批毫秒数不等于完整CEM决策耗时。
实验与证据
阅读全文及附录A–K共226089字符,查看图3;核对官方代码树、README、规划文档、许可和检查点链接。未运行机器人、训练或下载完整模型权重。
来源证据23个数据集、12类机器人,约287万回合;15022小时视频按相机累加,6692小时动作按轨迹计一次。 表1、附录A ↗
我的解读多视图录像时长不是独立交互时长;重复训练和固定数据混合也限制规模外推。
来源证据预测器22M至8B;用22M–2B检查点拟合,在4B、8B上比较外推,二阶幂律DROID/RoboCasa误差为0.0006/0.0014,普通幂律0.0020/0.0037。 表2、附录J.1–J.4 ↗
我的解读函数形式经过这些大模型结果筛选,这不是完全未参与选择的最终测试;长滚动训练FLOPs还包含按实测缓存因子估算的部分。
来源证据真机输入外部和腕部相机,但目标得分权重为1和0;4096候选、首次15轮后续10轮,规划时域5、执行前缀2。 附录G.1–G.3 ↗
我的解读腕部图像参与状态预测,不代表两视图同权监督目标;一次完整规划仍需数秒。
来源证据8B抓取67%、举起50%、放置27%;2B放置31%。VLA使用语言指令与不同控制方式,论文列VLA每任务50次、RoboJEPA30次。 表12、附录G.2 ↗
我的解读比较适合作背景,尚非同信息同预算的策略对照;部分百分比与试验数不一致,本文不据此虚构成功计数。
来源证据RoboCasa在10个保留厨房中评估,但移除部分杂物和设备;ObjectReach的物体由脚本预先抓住。推物成功定义包含朝目标移动。 附录G.4 ↗
我的解读不能把携带任务算成从零抓取,也不能把推近目标算成精确到位;短任务图中归一化累计奖励不应统一称二元成功率。
来源证据附录F列DROID/RoboCasa动作位移界0.05/0.10米,G的配置表列0.15/0.30米。官方规划文档还说明随附脚本的厨房、步数、夹爪搜索和距离范围与论文不同。 附录F、表13–14、官方docs/planning.md ↗
我的解读复现前须明确版本与评测协议。仓库可用与同配置成绩已复现是两个不同结论。
来源证据1B、H200、两视图、批量16的完整缓存预测耗时由eager217.1降至预编译96.7毫秒;预编译每检查点需要多卡40–60分钟。 附录H–I ↗
我的解读这是预测器测量,不能取倒数宣称完整机器人决策频率;离线编译和多轮搜索成本不能省略。
来源证据附录K比较V-JEPA 2和2.1的密集特征指标,明确模型大小及预训练配方不同,数字来自其他论文。 附录K、表21 ↗
我的解读“密集特征有助于可扩展机器人预测”是合理假说,但不是本文受控编码器消融得出的因果证明。
开放情况与使用许可
2026-10-11核对facebookresearch/robo_jepa提交f93106f5f4a451fd526d51778aa8ab7c852eb824,89个Python文件,包含训练、规划、推理及部署实现,README列出各规模多检查点和配置。DROID与AgiBot数据转换器已提供,其余混合数据转换器仍待补;未下载所有权重验证完整性。
LICENSE论文及图3为CC BY 4.0;项目代码与发布说明采用CC BY-NC-SA 4.0,含非商业和相同方式共享限制。第三方文件保留MIT、Apache等各自许可,编码器与解码器依赖也需单独核对。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
多规模检查点同时评估离线预测与下游规划,给出比单一最大模型演示更扎实的资源分配线索。
8B真机抓取与举起成功率分别67%和50%;公开实现说明了搜索、缓存和低层控制,便于检验潜在预测究竟如何参与动作选择。
反方 · 哪些结论还不够
真机放置成功率2B为31%、8B为27%,不能说每项任务都随规模单调改善;VLA基线输入目标和控制方式不同。
附录G写每模型每任务30次,但表12的2%、8%、18%、24%等不能都由30次整数计数常规四舍五入得到;缺原始分母不能还原成功次数。
长滚动配方同时改变步数和图像分辨率,未隔离二者作用;公开复现脚本与论文任务配置不同。
综合判断
结果支持在这个编码器、语料和任务族中,用潜在预测质量筛选更有希望的规划模型。它尚不是通用机器人能力的尺度定律,也没有证明大模型带来的收益足以覆盖完整搜索时延。
我会先做的验证
建议实验,未执行:固定数据、分辨率与总训练算力,独立扫描滚动步数;在同一未见厨房、相同目标与控制器、相同规划时限下比较各规模,公布每回合成功计数和置信区间。另用全新数据集检验预测误差与控制收益的排序,并先统一论文与脚本配置。